01 LM-Nav LM-Nav: Robotic Navigation with Large Pre-Trained Models of Language, Vision, and Action
2022.07 首次预印本原论文 ↗ · 官方代码 ↗
1. 需要解决的问题
能否让一个已经学会“朝目标图片导航”的机器人,直接按照自然语言指令行驶,而不再采集语言标注的机器人轨迹、重新训练语言导航策略? 已有的自监督视觉导航模型能利用大量无语言标注的经历学习移动,但使用时通常需要用户提供目标图片或位置,交互并不自然。
自然语言需要转换成视觉目标: “经过长椅,到停车标志旁,再去蓝色垃圾箱”需要变成机器人在环境中能够定位的目标序列。地标匹配需要考虑整条路线: 同一个环境可能有多个停车标志或外观相似的物体,单独匹配每个地标容易选到相隔很远、顺序不合理的位置。语义目标需要连接到可执行运动: 图像与语言匹配只能说明“像不像”,还需要判断节点是否能到达、代价是,并由机器人控制策略走过去。2. Framework · 语言、视觉与动作模型的组合
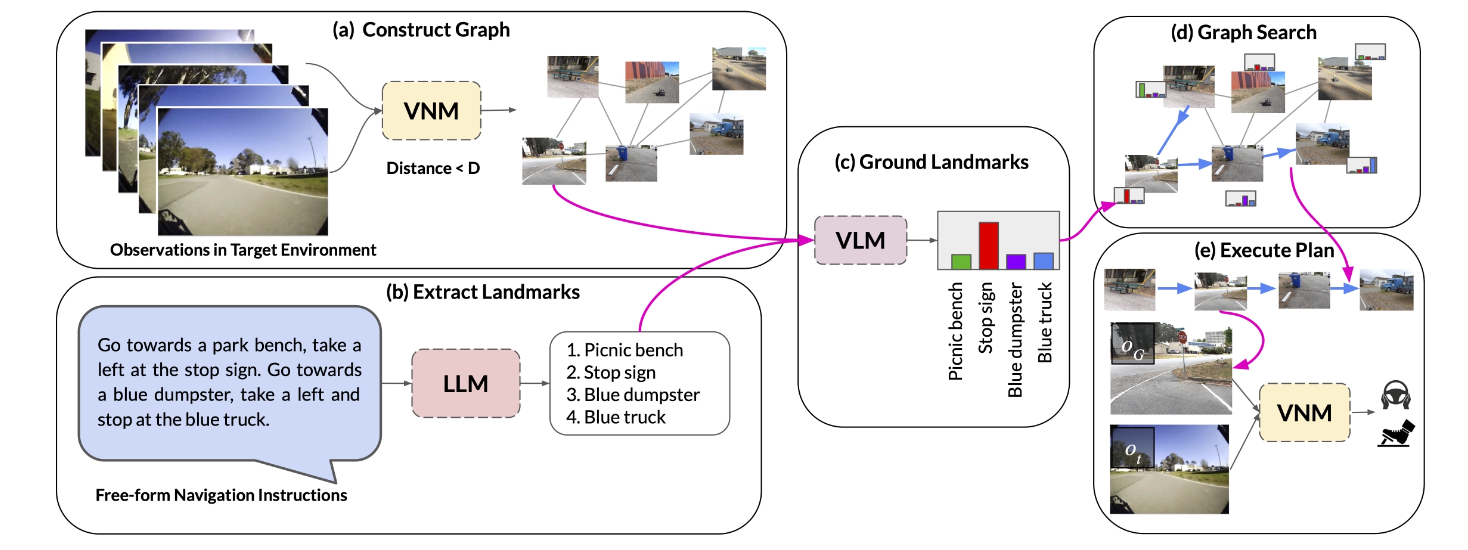
LM-Nav 使用三个独立预训练的模型:GPT-3 提取地标,CLIP 将地标匹配到环境图像,ViNG 提供可达距离预测与视觉导航控制 。模型之间通过“地标短语—图节点图像—目标图片”连接,图搜索负责整合语义匹配与路径成本。
Figure 3 · LM-Nav 整体框架 图片暂未加载,请通过图片链接查看。
整体流程 预先采集环境图像与 GPS → ViNG 辅助建立拓扑图 → GPT-3 提取有序地标 → CLIP 对地标和图节点评分 → 图搜索联合选择地标位置与连接路径 → ViNG 逐个执行视觉子目标。
3. Construct Graph · 怎样建立环境拓扑图
节点保存曾经观察到的图像,边表示局部可通行关系,边权使用 ViNG 预测的时间距离。
用时间相邻关系保留已走过的连接: 采集时间足够接近的两个节点直接连边,记录机器人实际经过的路段。用视觉导航距离补充连接: 如果 ViNG 判断两幅图像之间的导航距离足够短,就将它们视为可能连通的节点。用 GPS 排除明显错误的捷径: 相似的白墙或草地可能让模型误判距离,因此由 ViNG 距离提出的候选连接还要经过 GPS 距离过滤。去掉冗余边: 建图后做传递约简,减少密集图中的冗余连接,得到用于后续搜索的视觉拓扑图。这张图保存的是目标环境中已有的视觉经历与连接关系 。开始执行语言任务前,需要这些环境观测作为规划基础。
4. Extract Landmarks · 将指令转换成有序地标
GPT-3 根据少量示例,把路线指令整理成地标列表。例如框架图中的指令得到:Picnic bench → Stop sign → Blue dumpster → Blue truck 。
关键在于经过顺序,而不只是抽取名词。 例如“经过雕像并右转之后找图书馆”,需要输出“雕像 → 图书馆”。
5. Ground Landmarks · CLIP 怎样定位地标
编码地标文本: 把每个短语放入类似 This is a photo of a [landmark] 的提示,交给 CLIP 文本编码器。编码节点图像: 对拓扑图中的观测图像使用 CLIP 图像编码器,计算每个地标与每个节点图像的匹配分数。得到候选分布: 对一个地标在全部图节点上的分数做 softmax,形成该地标对应各节点的匹配概率。交给搜索统一决策: 保留多个可能位置的分数,由图搜索同时考虑其他地标和路径成本,决定最终采用哪个节点。6. Graph Search · 怎样同时选地标和路线
图搜索优化的目标可以理解为:按指令顺序匹配地标的 CLIP 分数之和,减去整条路线的加权通行成本。 通行成本使用 ViNG 预测的边时间距离。地标与路径共同选择,允许在两个地标之间经过其他连接节点。
论文通过动态规划与 Dijkstra 式图搜索 求解,把状态分成“已经匹配了几个地标”和“当前走到哪个图节点”两个维度:
从起点初始化: 尚未匹配地标时,以从起点到各节点的最小累计加权通行成本的负值,作为基础分数。加入下一个地标的匹配分数: 对每个节点,考虑在这里匹配当前地标,把它的 CLIP 分数加到上一层已处理地标的最优分数上。沿连通图传播: 在图上向邻居扩展时扣除移动成本,更新同一层中到达各节点的最优分数。这样下一地标可以在其他位置匹配,中间也能经过普通节点。逐个处理全部地标: 按顺序重复上述过程,最终选出最高分的终点,并沿保存的前驱关系回溯出完整 walk。例如环境里有多个停车标志,CLIP 最高分的那一个可能远离长椅和蓝色垃圾箱。联合搜索会结合前后地标的位置与通行代价,选择语义匹配较好、整体路线也合理的节点。这里的“回溯”是恢复搜索结果中的路径 ,发生在计划生成阶段。
7. Execute Plan · ViNG 如何把图片序列变成运动
搜索得到一串相连的图节点,节点图像依次作为视觉子目标。ViNG 读取机器人当前的前向 RGB 观察与下一张目标图像,输出局部运动,依序完成整条路线;执行中持续使用新观察进行视觉控制。
评测基座 GPT-3 解析指令,CLIP 匹配地标,ViNG 负责导航距离预测与局部控制。三个模型权重均冻结,无目标环境微调,也不需要语言标注的机器人轨迹。 实验数据 Clearpath Jackal 户外真机实验:EnvSmall-10 与 EnvLarge-10 各 10 条指令,共 20 条查询,累计行驶超过 6 km,目标最远约 800 m。报告规划成功率、实际执行成功率、路径效率与人工干预次数。 外部组件与执行 依赖预采集的目标环境图像、GPS 与视觉拓扑图,以及已经训练好的 ViNG 策略。机器人端使用 RGB 与未滤波 GPS,三个预训练模型的组合无需新增 VLN 训练。官方公开了语言接口、CLIP 评分、图搜索与实验 notebook。 本篇结果: LM-Nav 实机户外 / GPT-3 + CLIP + ViNG · LM-Nav 实机户外 / GPT-3 + CLIP + ViNG
回到实验总表 ↑ 回到论文目录 ↑
02 NavGPT: Explicit Reasoning in Vision-and-Language Navigation with Large Language Models
2023.05 首次预印本原论文 ↗ · 官方代码 ↗
一句话点评 算是 VLN 走向 LLM 的开山之作,虽然采用的是 Agent 架构,而不是原生 VLN 模型。
1. 需要解决的问题
一个没有经过 VLN 专门训练的通用 LLM,能否理解导航指令、根据环境反馈持续判断进度,并直接决定下一步行动? NavGPT 希望把 LLM 的语言理解、常识与规划能力接入视觉导航,同时通过显式输出观察它如何作出决策。
视觉环境如何变成 LLM 可以使用的输入: 当时用于决策的 GPT 接收文本,需要把图像中的场景、物体位置和可通行方向转成语言描述。语言推理如何变成可执行动作: “去厨房”“经过水槽”需要落实为当前导航图中可选择的具体航点,并用真实的新观察继续决策。多步导航如何维持进度: 模型需要记住之前看到了什么、采取了什么动作、当时的判断是什么,才能识别已经完成的子目标,并在观察不符合预期时调整计划。2. Framework · 视觉转文字,再进入推理—行动闭环
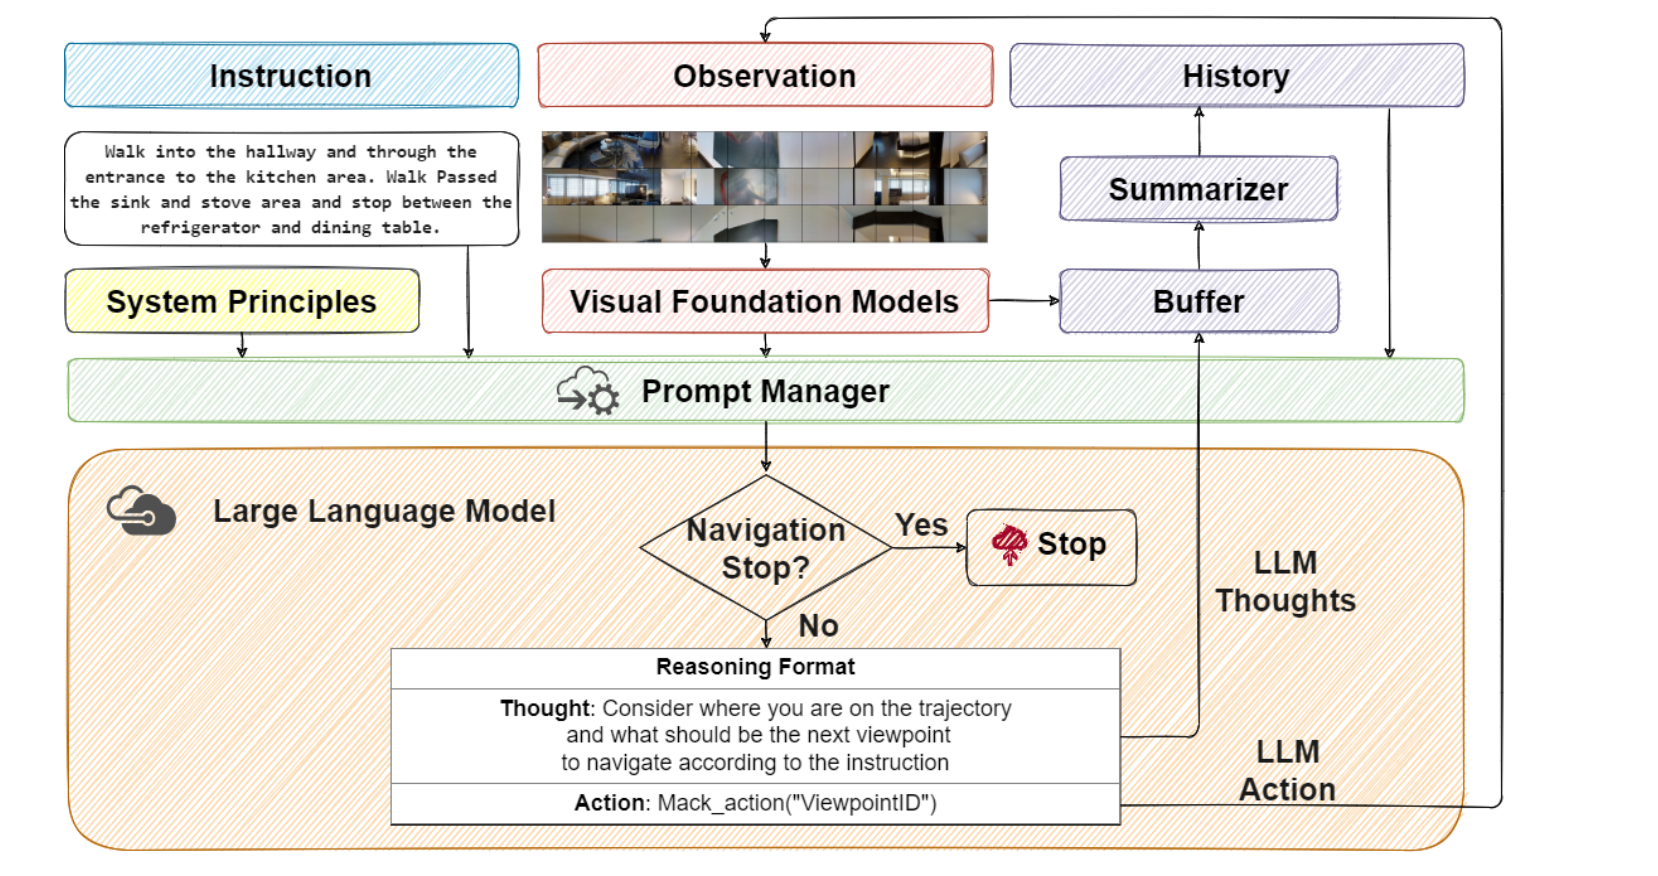
NavGPT 将指令、当前文字化观察、导航历史和系统规则 交给 Prompt Manager 统一组织,随后由 LLM 输出 Thought 与 Action。动作执行后产生新观察,再写入历史并进入下一轮。LLM 直接承担导航决策,视觉模型和模拟器分别提供感知接口与执行接口。
Figure 1 · NavGPT 整体框架 图片暂未加载,请通过图片链接查看。
执行闭环 当前多视图 → 场景描述 + 物体方位/距离 + 可导航航点 → 整合指令与历史 → LLM 判断进度并选择动作 → 移动到下一航点 → 获取新观察、写入历史 → 下一轮;输出完成信号时停止。
3. Visual Perceptron · 视觉如何转成文字
采集 24 个视图: 在一个 viewpoint 上,以 45° 为间隔覆盖 8 个水平方向,每个方向采集上、中、下 3 个俯仰视图,单张图像视场角为 45°。生成场景描述: BLIP-2 分别描述每张图像,再用 GPT-3.5 将同一方向的上、中、下三段描述合并成一句话。补充物体与距离: Faster R-CNN 提供物体类别和边界框;读取框中心像素在 Matterport3D 模拟器中的深度,结合图像方位计算物体相对朝向,保留距离当前位置 3 m 内的物体信息。补充可走的航点: 给出当前节点可到达的候选 viewpoint ID,以及它们相对于智能体的方向和距离。这些 ID 是后续动作可以使用的目标。统一到当前朝向: 以智能体面向的方向为 front,将八个方向顺时针排列;每个方向都包含场景描述、附近物体和可导航航点。因此,LLM 读到的不只是“这里有厨房”,还包括“厨房在哪个方向、附近有哪些物体、哪个候选 ID 可以朝那个方向移动”。空间信息先经过外部感知与几何处理,再以自然语言进入导航推理。
4. Reasoning + Action · 怎样决定下一步
论文明确采用 ReAct 的组织方式:每一步先输出对当前位置、任务进度和下一目标的判断,再输出动作。
拆解并跟踪子目标: 把长指令理解成一系列地标和动作,例如“进入厨房 → 经过水槽与灶台 → 到冰箱和餐桌之间”,结合当前观察与历史判断已经完成到哪一步。从候选中选择航点: 将下一子目标与各方向的场景、物体及可导航 ID 对齐,通过 action_maker 指定下一个相邻 viewpoint。根据新观察修正判断: 移动后重新读取环境;如果预期地标没有出现,可以继续探索或调整计划,历史中的已访问 ID 也用于减少重复访问。决定何时停止: 提示要求综合当前观察和历史判断是否到达终点。LLM 确认完成时输出 Final Answer: Finished!,由系统结束导航。子目标规划和进度判断主要体现在 LLM 的文本推理中 ,系统每次执行的是离散导航图上的航点移动。
5. History Buffer + Summarizer · 怎样记住之前的导航过程
Buffer 按时间保存“Observation—Reasoning—Action”三元组。 历史不仅告诉模型到过哪里,还保留当时为什么选择这个方向,使后续决策能够延续此前的子目标判断。
当前观察保留完整描述: 当前航点仍呈现八个方向的场景、近距离物体与可走航点,供本轮选择。过去观察压缩成一句话: 把某个历史航点的完整文字观察交给 GPT-3.5,生成简洁的场景摘要,替换提示中该步的观察部分。保留推理与动作顺序: 摘要后的观察仍与对应的推理、动作和航点 ID 放在一起,按时间拼入后续提示,支持进度判断和异常后的计划调整。这里有两次不同的摘要 :感知阶段把同一方向的三张图描述合成一句,历史阶段再把整个旧航点的观察压缩成一句。
评测基座 主结果使用 GPT-4 进行导航推理;BLIP-2 ViT-G/FlanT5-XL 生成图像描述,GPT-3.5 进行方向描述合并和历史摘要。视觉组件消融使用 GPT-3.5 导航。 实验数据 R2R 离散导航的 val-unseen,原文以 11 个场景、783 条轨迹描述主评测范围。视觉消融另从训练与 val-unseen 的 72 个场景中各采样 1 条轨迹,每条配 3 条指令,共 216 个样本。 外部组件与执行 BLIP-2、Faster R-CNN、Matterport3D 模拟器提供的物体深度与预定义导航图;通过航点 ID 进行离散移动。各模块使用现成模型,不新增 VLN 训练;导航 LLM 接收的是整理后的文本观察。 本篇结果: R2R(离散) / GPT-4;BLIP-2 ViT-G/FlanT5-XL;Faster R-CNN;GPT-3.5摘要
回到实验总表 ↑ 回到论文目录 ↑
03 VLFM: Vision-Language Frontier Maps for Zero-Shot Semantic Navigation
2023.12 首次预印本原论文 ↗ · 官方代码 ↗
1. 需要解决的问题
VLFM 研究的是 ObjectNav:在未知环境中寻找某一类别的物体 ,例如“找一张床”。目标还没有进入视野时,判断接下来去哪里更容易找到它。
几何探索缺少目标语义: 总去最近的 frontier,逐步探索环境,没有利用“卧室更可能有床”这样的语义线索,容易花时间搜索不相关区域。视觉转文字会丢失场景信息: 先检测物体、转成类别名称,再交给语言模型评价,难以保留房间布局、空间大小和通往其他房间的视觉线索。单帧判断需要积累成空间证据: 机器人从不同位置、不同方向反复观察同一区域,需要把当前图文匹配分数写入地图,并合理融合新旧观察。2. Framework · 用语义价值决定探索方向
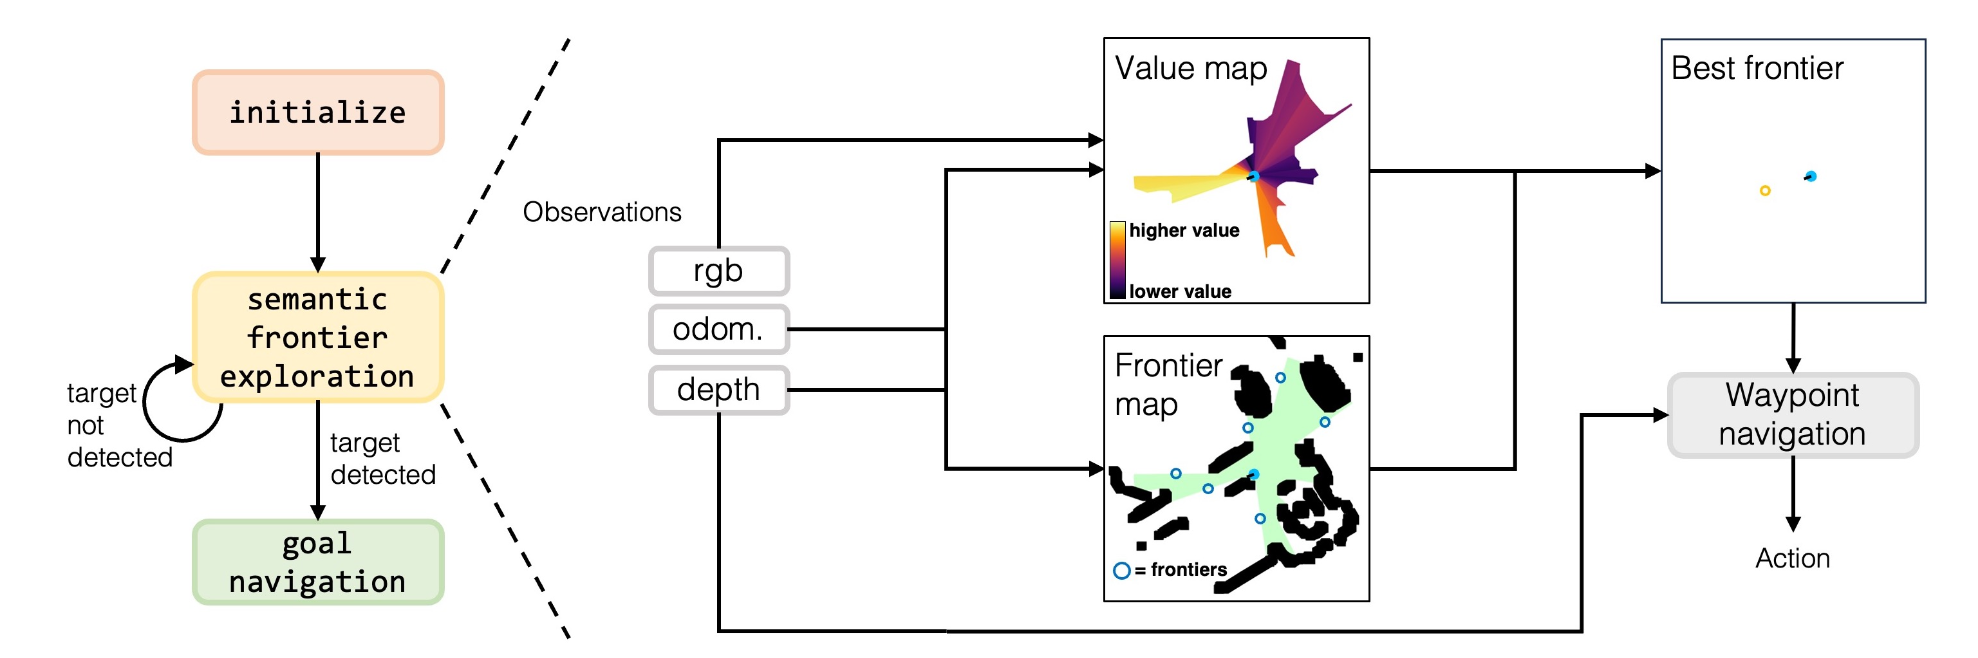
VLFM 在线维护两张二维地图:Frontier Map 提供接下来可以探索的边界位置,Value Map 评价这些位置对寻找目标有多大价值 。前者来自深度与里程计,后者额外使用 BLIP-2 从 RGB 图像中提取目标相关的语义分数。
Figure 2 · VLFM 的价值地图、前沿探索与目标导航 图片暂未加载,请通过图片链接查看。
执行流程 环视初始化 → RGB-D/里程计更新地图 → Value Map 评价 frontier → 航点导航 → 新观测继续探索;检测到目标后 → 分割与深度定位 → 接近目标 → Stop。
3. Frontier Map · 候选探索点从哪里来
Frontier 是已探索区域与未探索区域之间的边界。 机器人可以先走到这里,再获得边界另一侧的新观察。
深度转点云: 将当前深度图反投影成三维点云,过滤过低或过高、不会构成机器人运动障碍的点。统一空间坐标: 结合里程计,将障碍点变换到全局坐标系,再投影到二维占据栅格。更新可见区域: 根据当前位置、朝向和障碍遮挡,记录当前实际探索到的区域。提取边界航点: 寻找已探索区与未知区之间的边界,以各条边界的中点作为候选 frontier waypoint。4. Value Map · 如何把图文相关性写入空间
Value Map的每个栅格保存两个量:语义价值 与观测置信度 。语义价值表示视觉线索对找目标的作用;置信度表示如何融合重叠区域的新旧分数。
用目标构造文本: 例如床,使用 Seems like there is a bed ahead.。BLIP-2 将 RGB 图与目标提示进行图文匹配,输出余弦相似度。定位当前视野: 结合相机视场角与里程计,在俯视地图中生成当前相机视野对应的扇形区域。用深度裁剪遮挡: 去掉被障碍物挡住的区域,使分数只写入这次观察覆盖的可见部分。投影语义分数: 把图像的匹配分数赋给对应区域。当前帧提供的是整张图像的语义评分,地图空间差异随着视角变化和多次观测逐步融合。融合重复观察: 对已经有历史分数的栅格,根据当前与历史的观测置信度更新价值。置信度由观察角度决定。 沿相机光轴的地图位置取 1,向视野左右边缘按余弦平方函数衰减,到边缘为 0。
对于有效重叠区域中的同一个栅格,语义价值按新旧置信度加权融合:
$$v^{\mathrm{new}}_{i,j}=\frac{c^{\mathrm{curr}}_{i,j}v^{\mathrm{curr}}_{i,j}+c^{\mathrm{prev}}_{i,j}v^{\mathrm{prev}}_{i,j}}{c^{\mathrm{curr}}_{i,j}+c^{\mathrm{prev}}_{i,j}}$$ v i , j new = c i , j curr v i , j curr + c i , j prev v i , j prev c i , j curr + c i , j prev
历史置信度也同步更新,使融合结果偏向较大的置信度:
$$c^{\mathrm{new}}_{i,j}=\frac{\left(c^{\mathrm{curr}}_{i,j}\right)^2+\left(c^{\mathrm{prev}}_{i,j}\right)^2}{c^{\mathrm{curr}}_{i,j}+c^{\mathrm{prev}}_{i,j}}$$ c i , j new = ( c i , j curr ) 2 + ( c i , j prev ) 2 c i , j curr + c i , j prev
其中 curr、prev、new 分别表示当前观测、历史地图与更新结果。首次看见一个栅格时,写入当前语义分数;置信度参与之后的重叠观测融合。
5. 从 Value Map 到 frontier、目标位置与动作
探索时: 用 Value Map 评价 Frontier Map 给出的候选位置,选择高价值 frontier 作为下一航点。移动过程中持续获取新观测、更新两张地图。
发现目标时: 对于 COCO 类别内的目标,论文使用 YOLOv7 检测;其他类别使用 GroundingDINO。得到目标框后,再由 Mobile-SAM 提取轮廓,结合深度确定物体上距离机器人最近的点,把它设为目标 waypoint。机器人接近该点后调用 Stop。
仿真中的航点执行: 预训练 PointNav 接收当前深度图,以及相对航点的距离与方向,输出逐步运动动作。它只负责几何导航,输入不包含 RGB;语义上的“去哪里找”由上层价值地图决定。
评测基座 BLIP-2 提供图文匹配价值,YOLOv7/GroundingDINO 与 Mobile-SAM 负责目标检测和分割,仿真中的运动控制使用已训练的 PointNav。 实验数据 原论文 ObjectNav 验证集:Gibson 为 1,000 个 episode/5 个场景;HM3D 为 2,000 个 episode/20 个场景/6 类目标;MP3D 为 2,195 个 episode/11 个场景/21 类目标。另有 Spot 在未知办公环境中的真机演示。 外部组件与执行 依赖 RGB-D、里程计与在线二维地图。仿真使用 Habitat 和 VER 训练的 PointNav;真机通过 BD API 移动,机身深度相机用于障碍建图,夹爪相机用于语义观察,并用 ZoeDepth 辅助估计目标深度。 本篇结果: Gibson ObjectNav / BLIP-2+PointNav · HM3D ObjectNav / BLIP-2+PointNav
回到实验总表 ↑ 回到论文目录 ↑
04 MapGPT: Map-Guided Prompting with Adaptive Path Planning for Vision-and-Language Navigation
2024.01 首次预印本原论文 ↗ · 官方代码 ↗
一句话点评 和 NavGPT 类似,提出了一个 Agent 架构,并在其中加入地图信息,用拓扑关系支持全局探索与路径规划。
1. 需要解决的问题
只给模型当前位置的图像和几个可选方向,但很难掌握已经探索过哪些地方、不同分支如何连接、走错后应该退回哪里 。
局部观察缺少整体空间关系: 当前候选都不符合指令时,模型需要知道其他分支在哪里、通过哪些旧节点能够重新到达这些分支。线性历史难以表达拓扑结构: 记录“路线结构”可以还原经过顺序,但不能说明所有已知节点的连接关系,哪些候选曾出现却尚未探索。需要随新观察修改后续计划: 上一轮认为正确的路线,可能在靠近后被证据推翻。模型需保留一个计划,持续决定继续、回退或换一条分支。2. Framework · 单个导航专家读取地图并更新计划
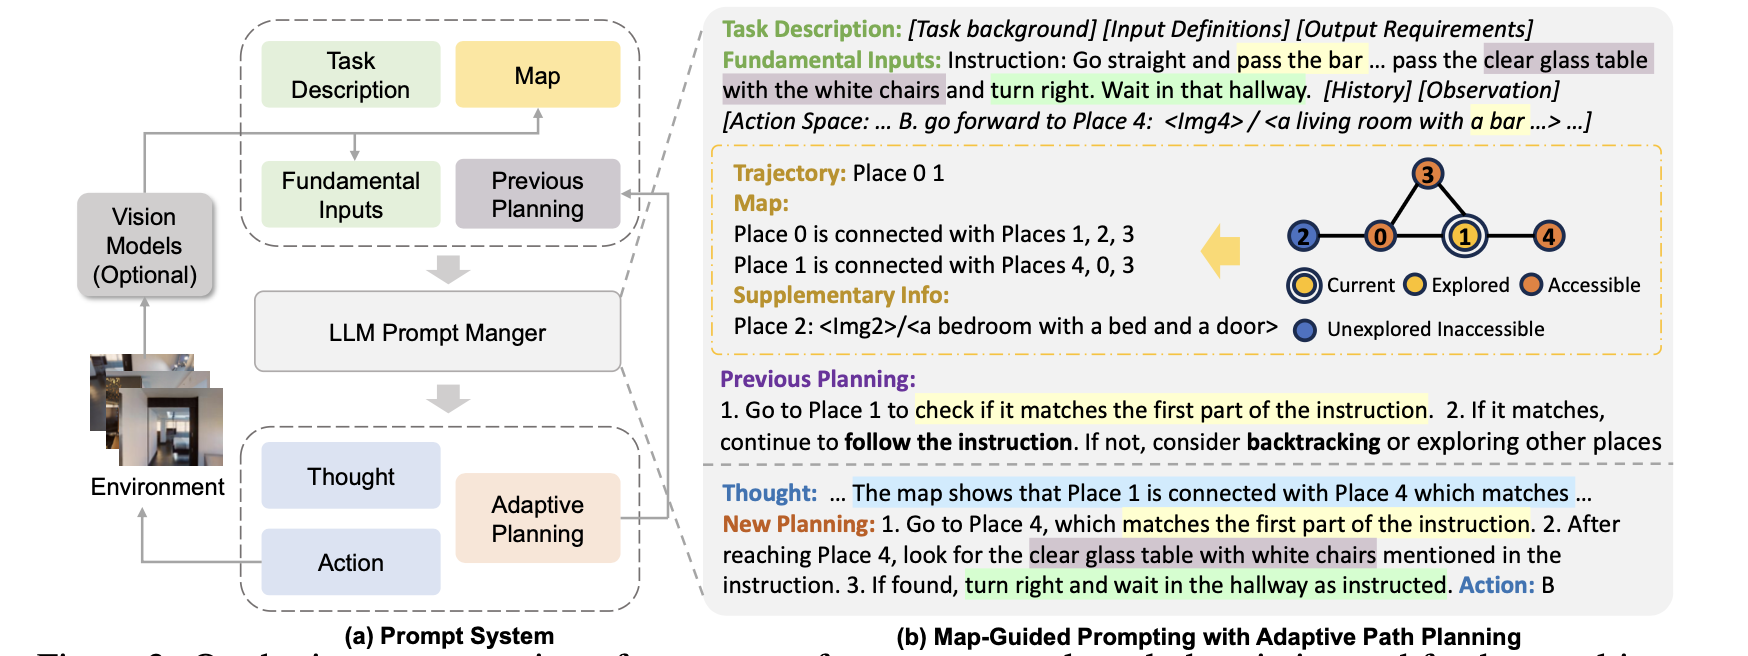
MapGPT 由 Prompt Manager 组织任务要求、原始指令、观察、动作历史、在线地图和上一轮计划,再交给同一个导航模型,核心输出为 Thought、New Planning 和 Action 。原始指令直接进入提示;任务进度和后续步骤由导航模型在决策时分析。
Figure 2 · Map-guided Prompting 与 Adaptive Path Planning 图片暂未加载,请通过图片链接查看。
视觉输入有两种方式:GPT-4V 直接读取图像 ;GPT-4 文本分支 先用 BLIP-2 生成场景描述,再用 Faster R-CNN 提供物体信息。
执行流程 获得候选观察 → 更新节点与连边 → 组织地图提示和旧计划 → 生成 Thought/New Planning/Action → 执行一个候选动作 → 新观察与新计划进入下一轮。
3. Online Topological Map · 地图如何建立和保存
地图在导航过程中扩大。每到一个地点,系统把新发现的节点及其连接加入图中,并按首次观察顺序赋予 Place 0、Place 1 编号。
节点既包括已经走到过的地点,也包括已经发现、但尚未进入的候选地点。 模型因此能够区分“我去过哪里”和“我还知道哪些地方可以继续探索”。节点之间的连边来自环境提供的可导航连接。
Explored Nodes 已经实际访问过的节点,包括起点与当前位置;用轨迹和动作历史记录访问过程。 Accessible Nodes 从当前位置能够一步到达的相邻候选,组成当前动作空间;其中也可能包含已经访问过的节点。 Unexplored Inaccessible Nodes 此前已经发现、尚未访问,而且当前不直接相邻的地点。 这里的“不可达”指当前不能一步直接到达 。例如在 Place 1 时,Place 2 可能需要先退回 Place 0,再从 Place 0 前往。
4. Map-guided Prompting · 怎样把图变成模型能读的内容
MapGPT 将地点关系写成文本形式的拓扑图,主要保留节点编号、连接关系和节点对应的观察 。模型读取的核心地图提示由三个部分构成:
Trajectory: 用 Place 编号列出实际经过的路线,帮助模型识别当前位置、回退过程与重复探索。Map Connectivity: 对已经访问过的地点列出其相邻节点,例如 Place 0 is connected with Places 1, 2, 3。Map Annotations: 当前候选的观察放在 Action Space,已执行动作保存在 History;尚未探索且当前不能直接前往的节点,其图像或场景描述放入 Supplementary Info。Trajectory: Place 0 1
Map:
Place 0 is connected with Places 1, 2, 3
Place 1 is connected with Places 4, 0, 3
Supplementary Info:
Place 2: a bedroom with a bed and a door
Place 1 时,模型可以考虑 Place 4,也能从地图中知道 Place 2 仍未探索、且与 Place 0 连通。已知但不在眼前的候选,仍然可以进入后续规划。
5. Adaptive Path Planning · 如何规划、回溯与执行
地图提供空间关系,Previous Planning 保存接下来准备怎么走 。模型每一步结合当前观察、指令进度、地图与旧计划,重新生成一个多步计划,再选择本步动作。
检查旧计划: 判断到达的地点是否符合预期,之前设定的子目标是否仍然成立。更新多步计划: 可以继续原路线,也可以调整目标顺序、增加条件分支,或者安排返回旧节点后探索另一方向。执行本步选择: 模型从当前合法候选中输出一个动作标签,例如 Action: B;执行接口将它映射为模拟器中的相邻视点移动。将计划带入下一轮: 本轮的 New Planning 成为下一轮的 Previous Planning,动作写入 History,访问序列与地图随观察更新。规划范围可以覆盖多步,实际每轮只执行一个相邻动作。 回溯通过连续选择地图上的返回路径完成;停止也由模型从动作选项中选择。R2R 按路线终点判断,REVERIE 还借助 Surroundings 中的周边目标物体信息判断是否结束。
评测基座 主要为 GPT-4V,另有 GPT-4/GPT-3.5 文本系统对照。模型通过提示完成导航推理与计划更新,无 VLN 任务专用微调。 实验数据 R2R 包含 72 个场景、216 条轨迹的采样实验,以及 11 个场景、783 条轨迹的较大 Val Unseen 子集;REVERIE 为随机抽取的 500 条 Val Unseen 样本,仅评导航,不包含最终物体指认指标。 外部组件与执行 Matterport3D 提供离散视点、相邻候选与图上的移动接口。GPT-4V 直接使用图像;文本分支使用 BLIP-2 和 Faster R-CNN。REVERIE 的停止判断使用数据集提供的周边物体列表,该额外信息不用于 R2R。 本篇结果: R2R / GPT-4V · REVERIE / GPT-4V
回到实验总表 ↑ 回到论文目录 ↑
05 InstructNav: Zero-shot System for Generic Instruction Navigation in Unexplored Environment
2024.06 首次预印本原论文 ↗ · 官方代码 ↗
一句话点评 算是开山之作,主要探讨一个问题不同类型的语言导航任务,能不能被统一成同一个零样本导航系统。
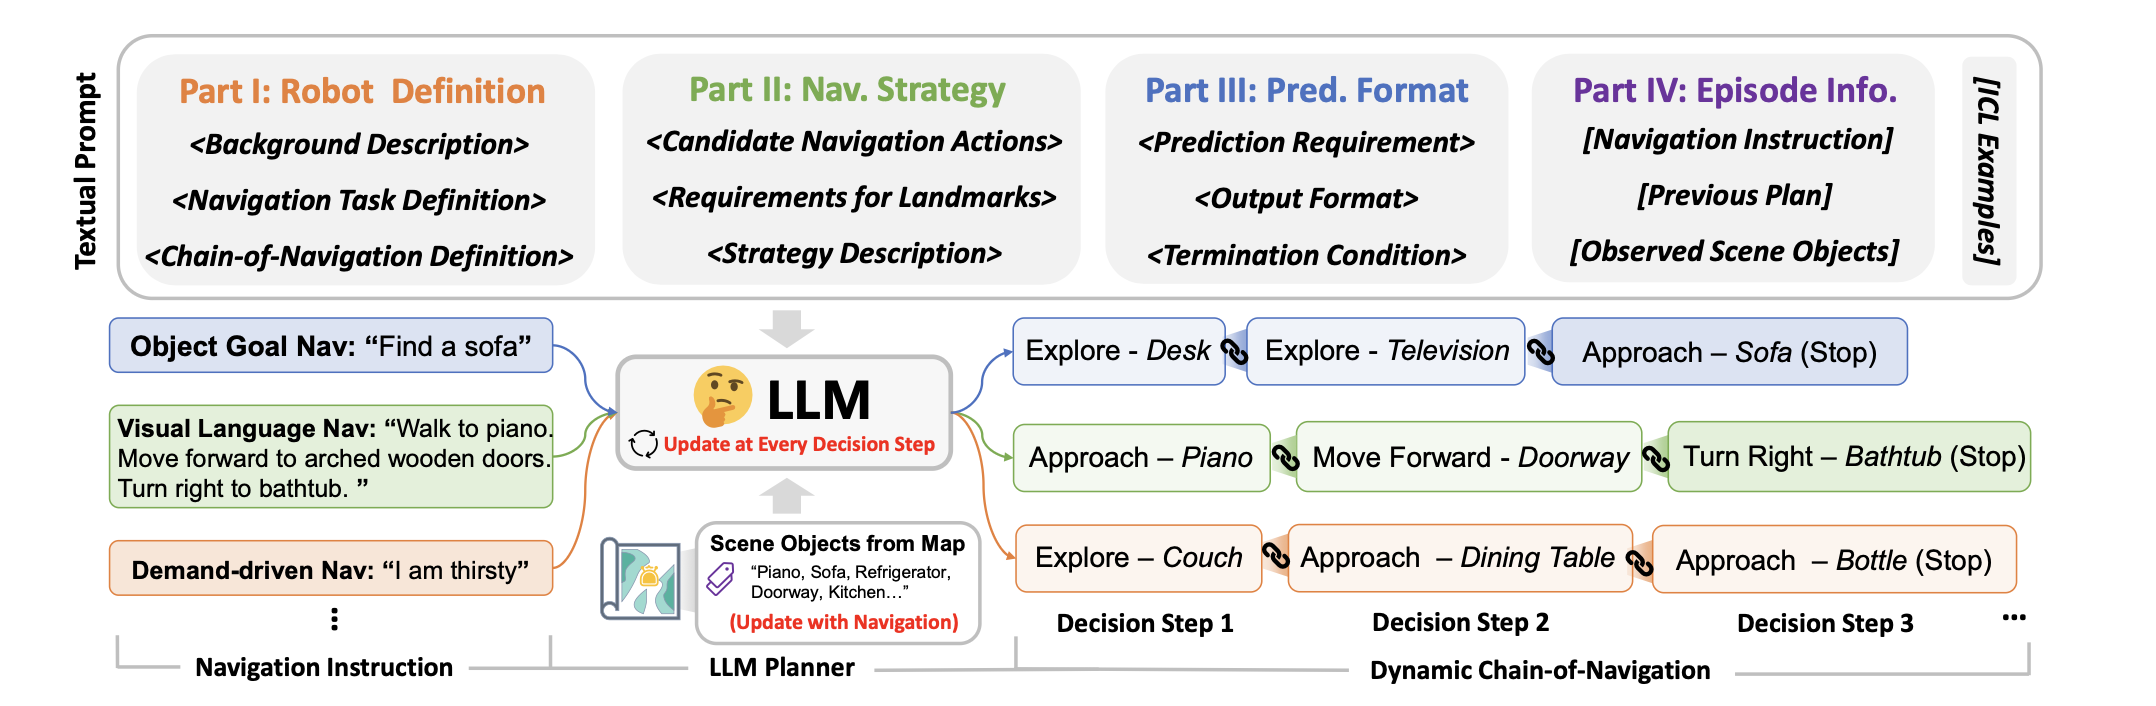
1. 需要解决的问题 能否开发一个在未探索环境中执行多种语言指令的零样本导航系统? 不同任务对规划的要求不同:ObjectNav 需要探索并找到指定物体,VLN 需要按语言描述的路线行走,需求驱动导航(DDN)则需要先推理什么物体能够满足人的需求。
任务层面的统一: “找到沙发”“沿走廊右转”和“我渴了”分别指向目标搜索、路线遵循与常识推理,需要一种能够共同表达它们的规划接口。语言规划到机器人控制的落地: LLM 给出的动作和地标仍是语言,必须转换为连续环境中的 waypoint 与可执行路径。未知环境中的在线适应: 物体与通路逐步进入视野,目标可能尚未发现,指令用词也可能不同于感知标签;计划需要随新观测更新。2. Framework · 先统一规划,再落到空间 DCoN 提供跨任务的 Action–Landmark 中间表示,Multi-sourced Value Maps 负责把这个表示转换成空间目标。 前者回答“下一步以什么方式朝哪个地标移动”,后者回答“在当前已探索环境中,具体应该去哪个位置”。
整体流程 指令 + RGB-D/位姿 → 在线语义点云与已观察物体 → 动态更新 Action–Landmark → 构建并叠加四张 Value Map → 选择 waypoint → A* 规划与执行 → 新观测驱动下一轮。
3. DCoN · 统一的 Action–Landmark 接口
Figure 2 · Dynamic Chain-of-Navigation 图片暂未加载,请通过图片链接查看。
CoN 把导航规划表示为 Action 1 – Landmark 1 → Action 2 – Landmark 2 → … 。其中 Action 是 Explore、Approach、Move Forward、Turn Right 等导航意图,Landmark 是对应的物体或场景地标。DCoN 在此基础上加入动态更新:每个决策步骤重新推理下一步动作与地标。
GPT-4 的输入包括完整指令、上一轮计划和已观察到的场景物体 ;提示由 Robot Definition、Navigation Strategy、Prediction Format、Episode Information 四部分组成,并带有示例。输出采用 {Reason, Action, Landmark, Flag}:推理说明、当前动作、地标,以及终止标志。
其关键机制有三点:优先采用已观察到的物体标签以便在地图上定位;目标未出现时用房间布局常识指导探索;对抽象需求推理可满足它的地标。
4. Multi-sourced Value Maps · 把语言意图转换为空间分数 系统先用 RGB-D 与相机位姿在线建立场景点云,提取已探索地面上的无障碍可导航区域;GLEE 的二维语义分割再通过深度和位姿投影到三维,得到带物体标签的语义点云。四张价值图在这个空间上分别为候选位置赋分,初始值均为零。
5. 从 Value Map 到 waypoint、路径与停止 四张图按位置直接相加,形成决策价值图;原文没有引入学习得到的融合权重:
$$m=m_i+m_a+m_t+m_s$$ m = m i + m a + m t + m s 其中四项依次为直觉、动作、轨迹、语义价值图。系统将障碍区域的值置零,再选择价值最高的位置作为下一 waypoint。
$$p^*=\operatorname*{arg\,max}_{p\in\mathrm{PCD}_{\mathrm{nav}}}m(p)$$ p * = arg max p ∈ PCD nav m ( p ) 随后用 A* 规划到该 waypoint 的路径;仿真中使用先转向、再前进的方式跟踪路径,真机中控制机器人速度。移动后的新 RGB-D 和位姿继续更新点云、历史轨迹与场景物体列表,触发下一轮 DCoN。停止条件是 Flag=True,或 GPT-4V 给出 Stop 判断。
这就完成了从“语言中的 Action–Landmark”到“空间中的价值最高点”,再到“低层可执行路径”的衔接。
评测基座 GPT-4(gpt-4-0613)负责 DCoN;GPT-4V(gpt-4-vision-preview)负责 Intuition Map 的方向判断。默认视觉输入为 6 个方向的 RGB 图像。 实验数据 HM3D/Habitat ObjectNav、R2R-CE val-unseen、DDN 的未见场景与未见指令设置。消融为每种任务分别随机采样 100 条指令;不将这个数量作为主结果表的样本量。 外部组件与执行 预训练 GLEE 语义分割、RGB-D 与位姿、在线语义点云、规则计算的四张价值图、A* 路径规划和低层运动控制。零样本指不做导航任务训练、无需预建地图,仍然依赖预训练模型和几何观测。 本篇结果: R2R-CE / GPT-4(gpt-4-0613)+ GPT-4V(gpt-4-vision-preview)
回到实验总表 ↑ 回到论文目录 ↑
06 ReMEmbR: Building and Reasoning Over Long-Horizon Spatio-Temporal Memory for Robot Navigation
2024.09 首次预印本原论文 ↗ · 官方代码 ↗
一句话点评 将RAG那边的bge结合向量检索拿入这边的记忆检索
1. 需要解决的问题
ReMEmbR 关注的是:如何把这些历史保存成可查询的记忆,并在用户事后提问时,找出足够的证据来回答问题或生成导航目标。
持续增长的历史放不进固定上下文: 把视频帧或文字描述全部送给模型,随着运行时间增加,会占用更多上下文和推理时间。记住语义,还需要记住位置和时间: “电梯在桥边”可以帮助人理解,但机器人需要坐标;“我见过箱子掉落”,需要知道何时发生。一次语义检索可能不足以回答复合问题: 找到相关物体后,还需要补查附近环境、前后时刻或其他候选,再比较位置、计算时长并形成答案。2. Framework · 先建立记忆,再按问题迭代检索
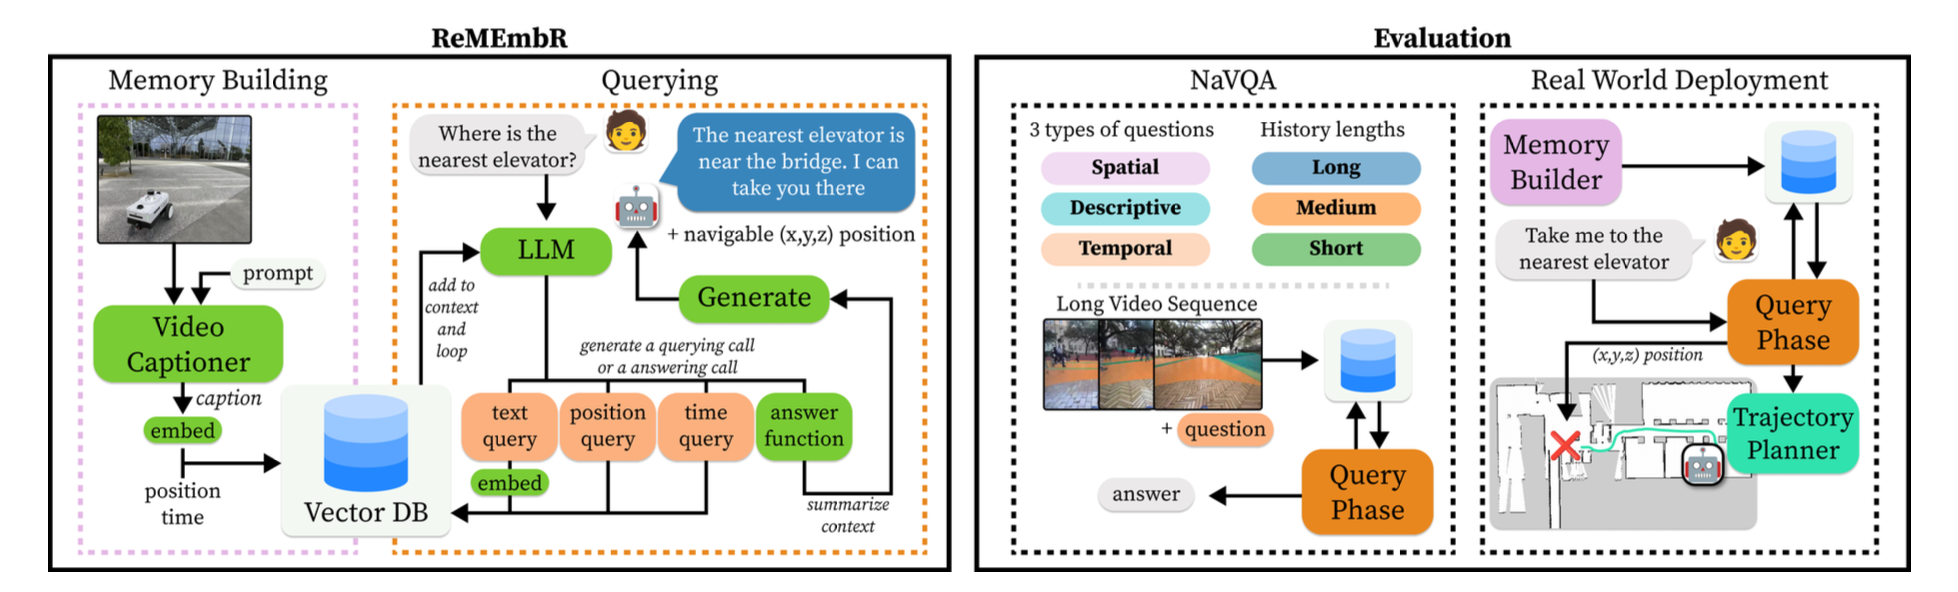
系统分为 Memory Building 和 Querying 两个阶段。前者在不知道未来问题的情况下,把短视频片段转成描述,并连同位置信息、时间戳写入数据库;后者由 LLM 根据用户问题选择检索工具,逐轮积累相关记忆,最后输出答案。
Figure 2 · 记忆构建、迭代查询与评测架构 图片暂未加载,请通过图片链接查看。
从 RAG 的角度看,短视频的 caption 对应可检索的文档片段,向量数据库保存机器人经验,LLM 决定下一步需要补查什么 。
执行流程 视频片段 → VILA 描述 → 文本嵌入+位置+时间入库;用户提问 → LLM 选择检索工具 → 返回相关记忆 → 继续补查/生成结构化答案 → 需要导航时,将目标位置交给导航栈。
3. Memory Building · 一条记忆是怎么存下来的
采集短时间片段: 论文实验每 3 秒取 6 帧,相当于 2 FPS,由 VILA1.5-13B 生成该片段的文字描述,覆盖场景、物体和动态事件。将描述编码为向量: 使用文本嵌入模型,把 caption 转成可做相似度检索的向量。后续的文本查询也用同一嵌入模型编码。绑定时空信息: 将原始 caption、文本向量、对应的机器人位置和时间戳保存到同一条记录中,随着新观察到来持续追加。Caption 机器人在这段视频里看到了什么,是返回给 LLM 阅读的语义内容。 Text embedding 用于找到语义相关的描述;它承担检索作用,LLM 读取的仍是描述及其时空信息。 Position 记录观察时机器人的空间位置,使模型知道这条经验发生在哪里,并为目标位置推理提供依据。 Timestamp 记录经验发生的时刻,用来补查某个时间附近的观察,以及计算“多久以前”或持续多久。 4. Retrieval · 文本、位置和时间分别怎么查
LLM 根据问题和已检索的内容,决定调用哪一种工具及其参数。三种检索都返回包含描述、位置和时间的记忆记录 。
相似度只决定哪些记录被召回;是否足以支持答案,仍由 LLM 结合完整问题和多条证据判断。
5. Querying Agent · 为什么还要多轮补查
提出查询: LLM 读取用户问题和当前已有证据,生成检索工具调用。一轮可以提出多个查询,每次取回若干条相关记忆。加入上下文: 工具返回的 caption、位置和时间进入本次问答的上下文,与前几轮的证据一起供模型使用。判断是否继续: 如果仍缺少证据,模型可以修改文本关键词,或转为位置、时间查询。论文实验最多进行 3 轮检索。生成答案: 证据足够或达到检索轮数上限后,整理已有信息,输出结构化 JSON;根据问题填写文字、是否、位置、时间点或时长等字段。评测基座 主要为 GPT-4o+VILA1.5-13B+mxbai-embed-large-v1;另比较 Codestral、Command-R 和 Llama3.1-8B 等查询模型。真机使用量化 VILA-3B 构建记忆,GPT-4o 负责查询推理。 实验数据 NaVQA 基于 CODa 的 7 条导航视频,共 210 个问题,涵盖空间、时间和描述;按历史长度分为短(少于 2 分钟)、中(2–7 分钟)、长(超过 7 分钟)。真机在办公室先采集约 25 分钟记忆,再进行导航请求演示。 外部组件与执行 官方代码用 Milvus 保存与检索记忆。真机为 Nova Carter,使用 Jetson Orin、预建度量地图、AMCL 定位和 Nav2 导航,并通过 Whisper 接入语音请求。 本篇结果: NaVQA / GPT-4o + VILA1.5-13B
回到实验总表 ↑ 回到论文目录 ↑
07 Open-Nav: Exploring Zero-Shot Vision-and-Language Navigation in Continuous Environment with Open-Source LLMs
2024.09 首次预印本原论文 ↗ · 官方代码 ↗
一句话点评 沿用了wuqi提出的 waypoint predictor,也就是预测连续空间中的候选路点,再由 LLM 选点并交给执行层移动,将运动轨迹离散转为连续
1. 需要解决的问题
如何部署开源 LLM,在连续环境中根据语言指令完成导航。 借鉴 NavGPT 高层导航决策方式,还需要补齐候选位置、空间感知和任务进度。
连续空间里,下一步可以去哪里: 离散 VLN 有提供候选节点;连续环境需要根据当前观察生成附近的可导航目标,才能让语言模型选择。普通场景描述缺少空间信息: 仅知道“有桌子、椅子、门”还不够,导航需要理解它们相对机器人的方向、距离和彼此关系。多步骤指令容易丢失执行进度: 模型需要结合已经看过的场景和走过的路线,判断到了指令哪一步,避免只看到地标就提前认为任务完成。2. Framework · 候选路点、场景感知与语言决策
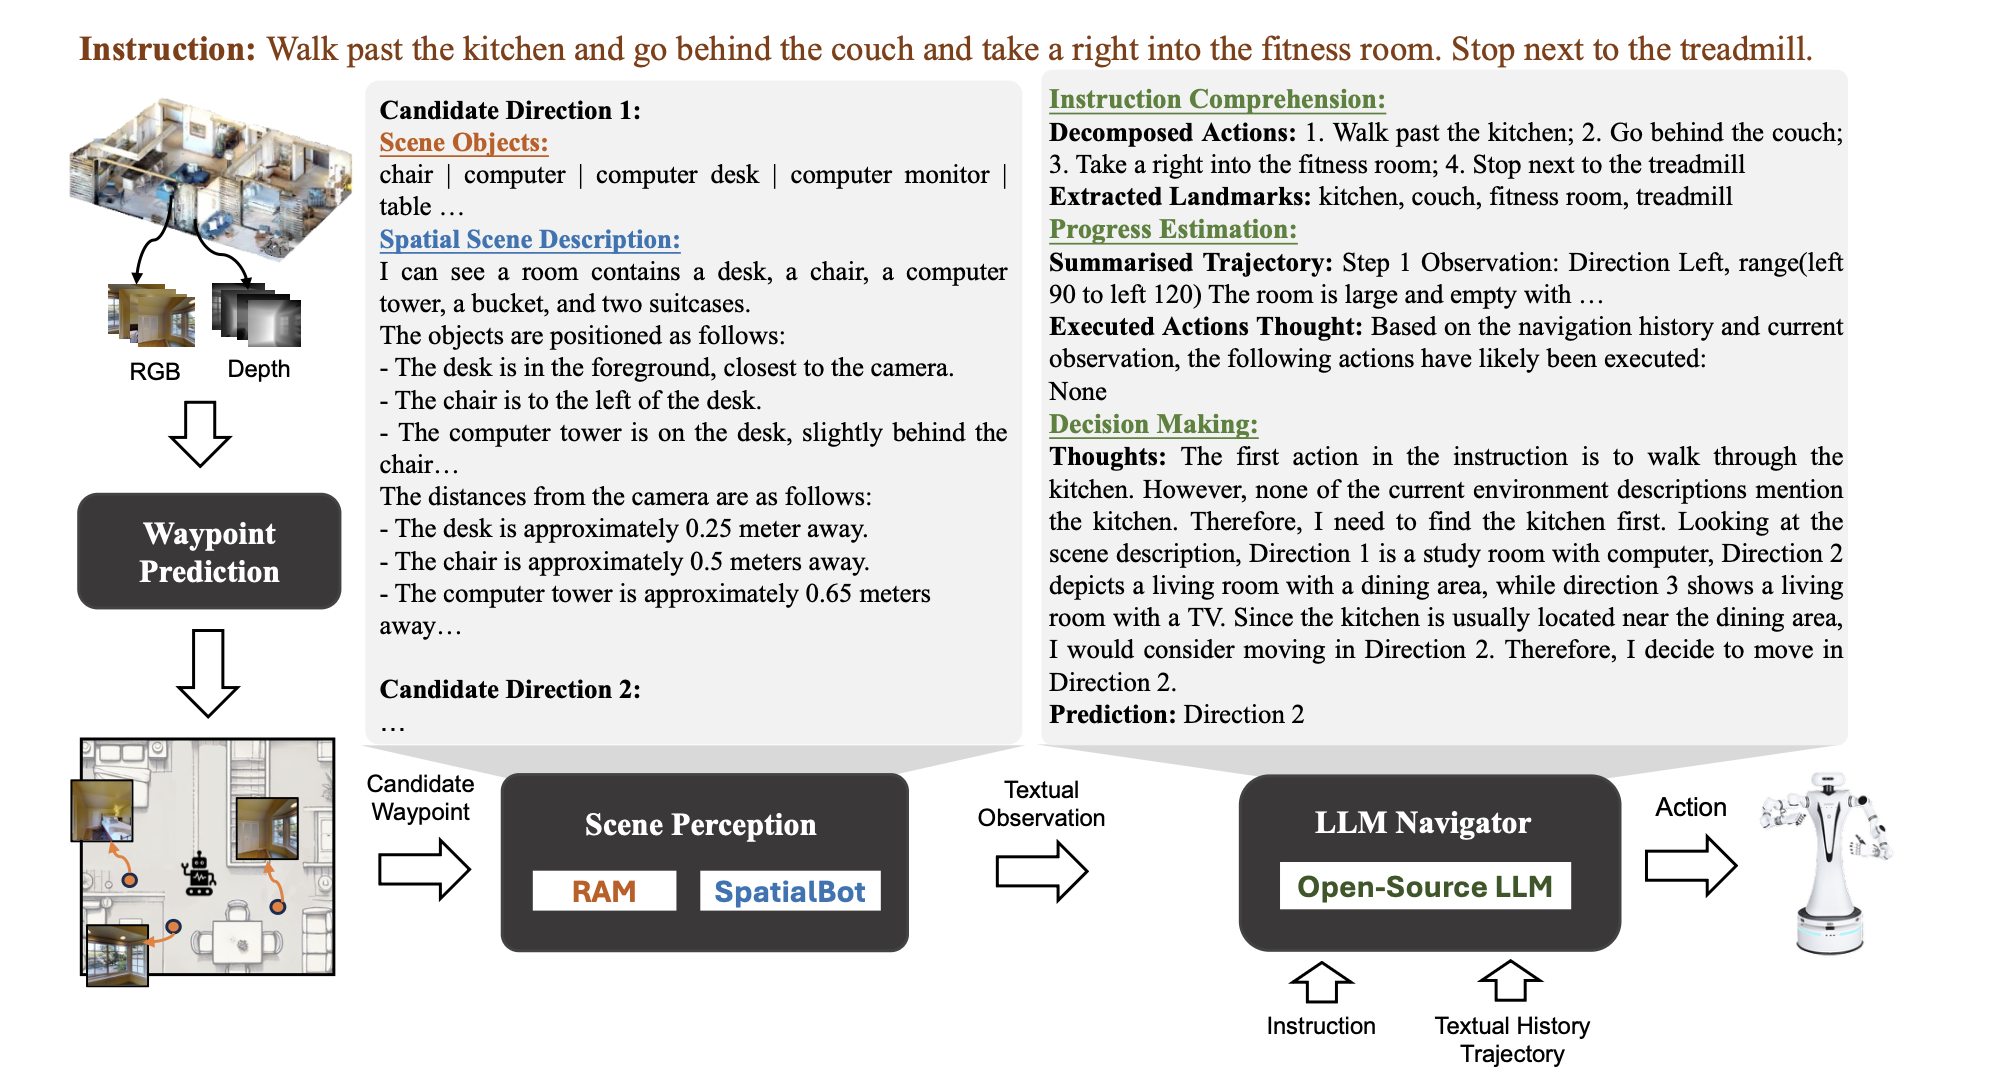
整体流程由三部分组成:Waypoint Prediction 生成候选位置,Scene Perception 描述每个候选方向,LLM Navigator 根据指令与历史决定本步选哪一个。 模型接收到的是整理好的文本观察,RGB-D 先由航点预测与感知模块处理。
Figure 2 · Waypoint Prediction、Scene Perception 与 LLM Navigator 图片暂未加载,请通过图片链接查看。
执行流程 全景 RGB-D → 预测候选路点 → RAM/SpatialBot 生成文本观察 → 理解指令、估计进度、选择候选 → 按所选角度与距离执行 → 更新观察与历史 → 下一轮决策。
3. Waypoint Prediction · 下一步的候选点从哪里来
Waypoint predictor 先提出若干可能可导航的位置,LLM 再根据指令从中选择。 论文中的预测器输入是全景 RGB-D;语言指令用于后续选择,因此候选生成与“哪一个更符合当前任务”是两个环节。
获取全景输入: 在当前位置每隔 30° 采集一个视角,共 12 张 RGB 图和 12 张深度图,覆盖一整圈。融合外观与几何特征: 分别通过 RGB 和深度的 ResNet-50 编码器提取特征,拼接后映射成每个视角的融合表示。联系相邻视角: 使用两层 Transformer;注意力限制在当前视角及左右相邻视角之间,让预测器结合局部方向关系判断候选位置。生成候选热图: 由 MLP 输出潜在路点的热图,再用非极大值抑制(NMS)压低邻近的重复峰值,保留若干候选。转换为相对位置: 每个候选包含“相对角度+距离”,角度以弧度表示,距离以米表示。LLM 选中候选后,执行层使用这组参数完成移动。这个接口把连续环境中的局部移动目标整理成有限候选,使高层模型仍然可以做“选哪一个”的决策。连续的是机器人所在的环境和移动过程,高层每一步仍在离散候选集合中选择。 它不直接预测整条连续轨迹;每次移动之后,还需要重新观察、预测候选和决策。
Open-Nav复用了wuqi 等人的预训练 waypoint predictor 。它的零样本设定主要针对高层 LLM 导航,无需再用该任务的导航数据微调 LLM。
4. Scene Perception · 如何让 LLM 理解候选方向
候选点说明“可以考虑往哪里移动”,感知模块还要说明“这个方向有什么、空间关系怎样”。Open-Nav 分别补充物体识别和空间描述:
RAM 读取 RGB 图,提供细粒度物体标签,例如 chair、computer、desk,帮助导航器把观察与指令里的地标对应起来。 SpatialBot 读取 RGB 与深度图,按照提示生成包含空间关系和距离的描述,例如“椅子在桌子左边”“桌子靠近相机”。 候选文本观察 按 Candidate Direction 编号组织两类结果,将物体列表与空间场景描述绑定到同一个候选方向,供 LLM 比较。 5. Spatial-Temporal CoT · 怎样判断进度并选点
LLM Navigator 把每轮决策组织为指令理解、进度估计、决策 三个阶段。空间信息来自当前候选描述,时间顺序来自此前的观察、动作和历史。
Instruction Comprehension: 将原始指令分成有顺序的动作,并抽取地标。Progress Estimation: 结合历史观察和决策,检查哪些地标已经出现、哪些动作已经执行,再核对每步方向变化与动作完成情况。Decision Making: 把指令分解、当前进度、历史摘要和各候选方向的描述放在一起,选择最符合下一步任务的候选,更新历史。进度检查由语言模型依据提示完成。历史保存为文本化轨迹摘要 ,包含过去看到了什么、做过什么和相应判断,帮助模型在下一轮接续任务。
评测基座 主要为 Llama 3.1-70B-Instruct,配合 SpatialBot 与 RAM;另比较 Qwen2-72B、Gemma2-27B、Phi3-14B,并报告 GPT-4 对照。开源 LLM 通过 Ollama 本地部署。 实验数据 仿真使用 Habitat 中的 R2R-CE,随机采样约 100 条 episode;真机覆盖办公室、实验室、游戏室,每个场景 20 条指令,共 60 条。 外部组件与执行 仿真采用已有预训练 waypoint predictor、RGB/深度编码器和 Habitat 执行接口;感知使用 SpatialBot、RAM。真机使用配备 RealSense D435 的双臂复合机器人。高层 LLM 负责候选选择,执行层负责移动。 本篇结果: R2R-CE / Llama 3.1-70B + SpatialBot + RAM · R2R-CE / GPT-4 + SpatialBot + RAM
回到实验总表 ↑ 回到论文目录 ↑
08 Constraint-Aware Zero-Shot Vision-Language Navigation in Continuous Environments
2024.12 首次预印本原论文 ↗ · 官方代码 ↗
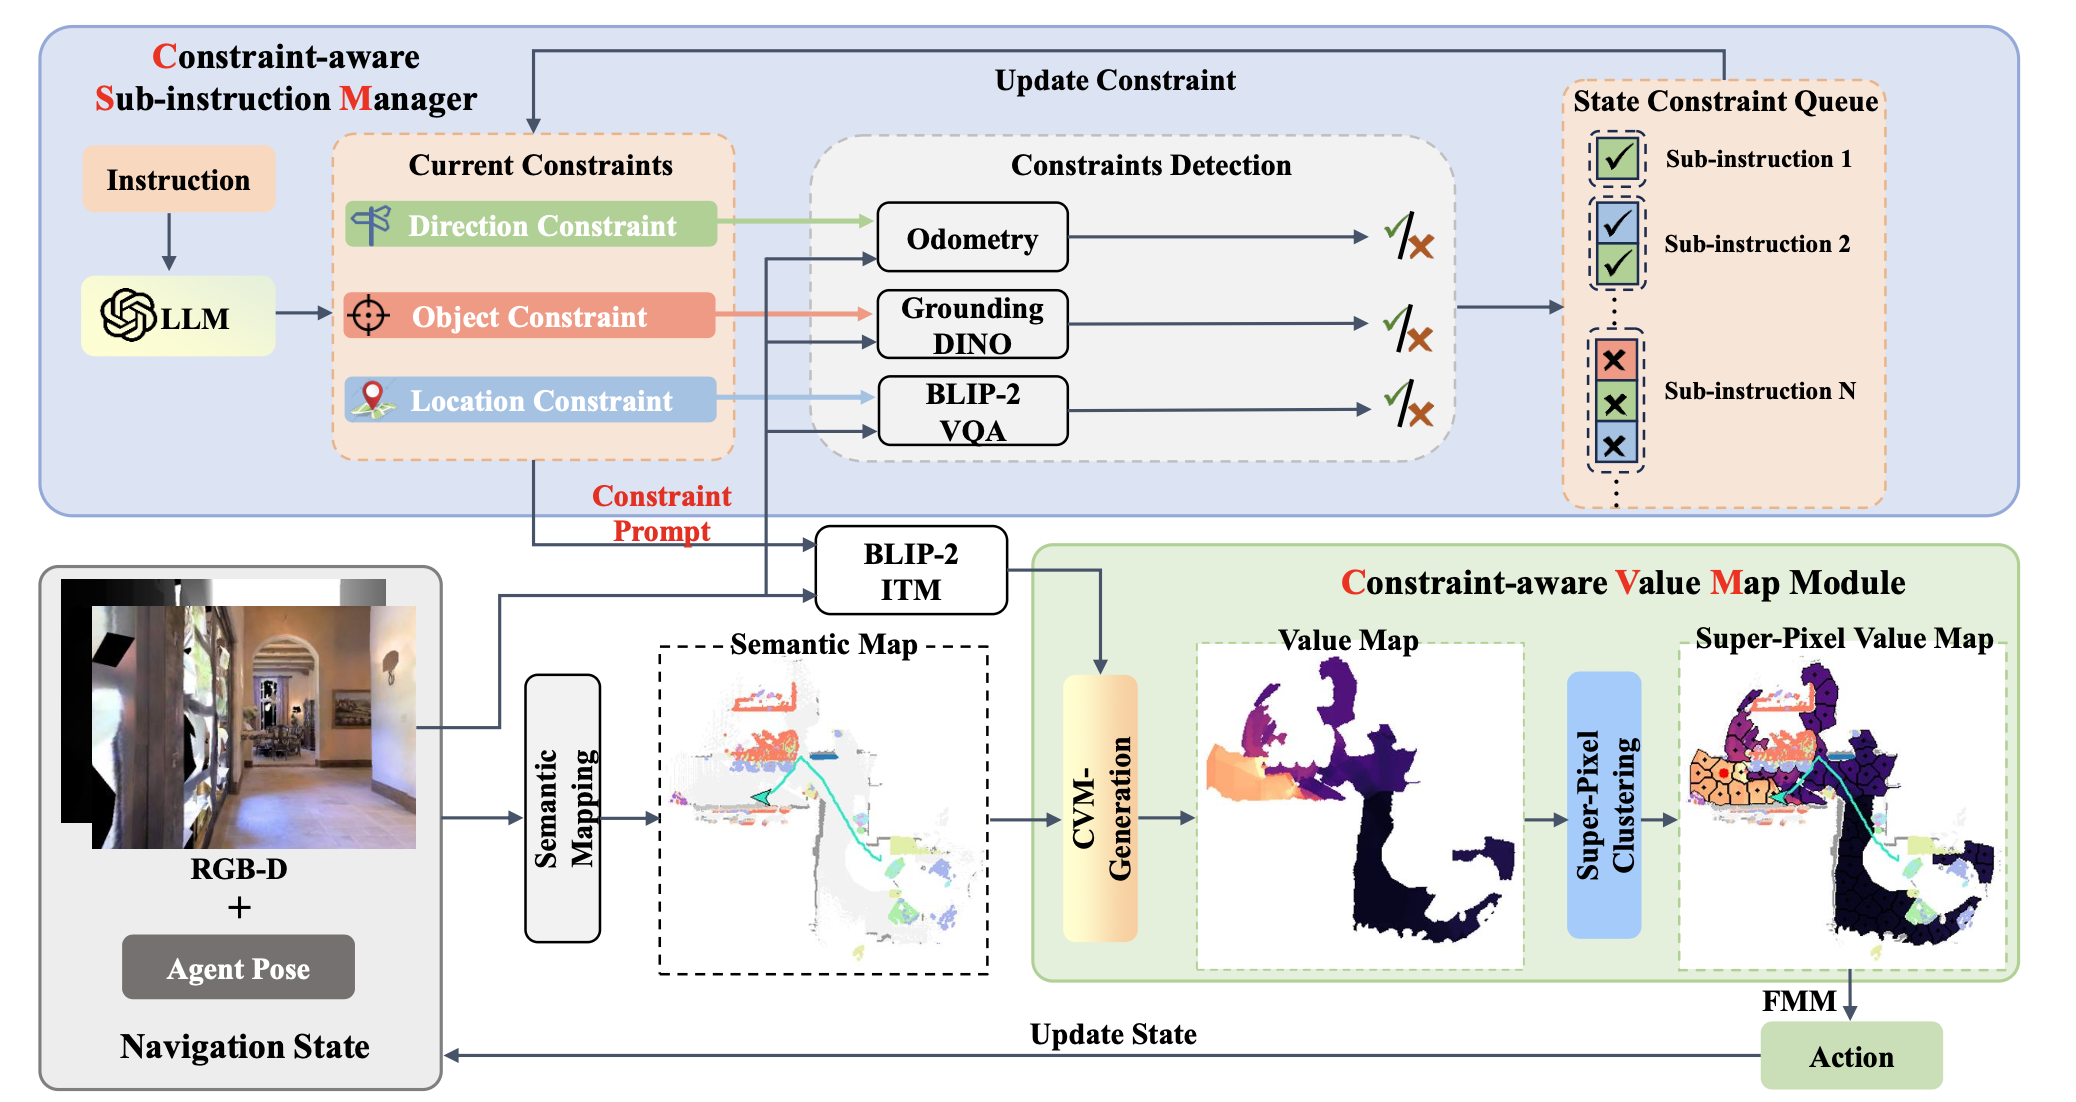
1. 需要解决的问题 连续空间让指令进度难以判断: 机器人需要经过许多低层动作才能完成一句“经过画作后左转进入吧台”。没有离散导航图中的节点作为天然分界,只把完整指令反复交给 LLM,很难准确判断当前执行的是哪一段、何时应该切到下一段。视觉转成文字会丢失空间信息: 将当前画面与导航历史概括为文字,再让 LLM 选动作,会遗漏视觉细节和环境结构。即使文字提到了目标物体,也不等于保留了可通行区域、物体相对位置与路径布局。CA-Nav 因而把任务表述为按顺序完成一组带约束的子指令 :通过感知和里程计检查进度,同时在地图中保存当前任务相关的视觉与空间证据。
2. Framework · CSM 判断进度,CVM 建图与选点
Figure 3 · CA-Nav 完整架构 图片暂未加载,请通过图片链接查看。
CSM(Constraint-aware Sub-instruction Manager) 先将完整指令拆成有序子指令,并为每一段提取完成约束。运行中,根据物体、地点和方向检查结果推进队列。CVM(Constraint-aware Value Mapper) 以当前约束生成提示,用 BLIP-2 为观测评分,再把分数写入空间地图,选出值得前往的区域。
CA-Nav
3. CSM · 怎么知道当前子指令完成了 CSM 在 episode 开始时用 GPT-4 将指令转换成有序的约束集合队列 。每个集合对应一条子指令,可以包含物体、地点、方向中的一种或多种条件。系统始终关注第一个尚未满足的集合,把“执行进度”落实为当前队列位置和各约束的满足状态。
CSM 的作用是让完成判断具有明确的感知依据。当前物体与地点约束还会成为 CVM 的地标提示,使“进度判断”和“往哪里走”围绕同一个子目标。
4. CVM · 怎么把视觉证据变成空间价值 CVM 同时维护环境布局和任务相关分数。语义建图利用 RGB-D 与位姿建立地图并提取可导航区域;价值建图则用当前约束告诉系统哪些观察更值得关注,它避免把全部导航证据压成文字摘要。
根据当前约束给图像评分: 将 RGB 观测与当前物体/地点提示交给 BLIP-2,得到图文匹配或相关分数。将分数落到可见空间: 按机器人位姿和相机视场,将该观测的分数赋给对应视锥中的地图区域。融合新旧观测: 当前视锥内的价值按置信度做加权平均。置信权重由相对相机光轴的夹角决定,采用余弦平方权重,光轴附近权重大。切换约束时衰减历史: 新子指令带来新的匹配提示。直接清空地图会丢掉过去的探索线索,因此系统仅在约束切换时施加历史衰减。抑制重复走过的区域: 将轨迹掩码逐元素乘到价值地图上,访问越多的位置权重越低,从而鼓励探索。轨迹掩码初始为 1,具体计算为:
$$M_{i,j}=\lambda^{k(i,j)},\qquad \lambda=0.95$$ M i , j = λ k ( i , j ) , λ = 0.95 其中 k 表示该位置累计访问次数。要区分两种作用:历史衰减处理任务提示改变后,旧分数还保留多少 ;轨迹掩码处理同一位置已经去过多少次 。
5. 超像素选点与 FMM · 从价值地图到行动 直接选全图最高值像素容易被局部噪声影响;只选探索边界又限制了对整张地图的利用。尤其在子指令切换后,分数发生变化,候选目标可能不稳定。因此 CVM 用 SLIC 对价值地图做超像素聚类 ,先评估一整块区域,再选其中的代表位置。
它对每个超像素区域计算平均价值,选择均值最高的区域,并以该区域的几何中心 作为下一 waypoint:
$$V(S_i)=\frac{1}{|S_i|}\sum_{p\in S_i}v(p),\qquad S^*=\operatorname*{arg\,max}_{S_i}V(S_i)$$ V ( S i ) = 1 | S i | ∑ p ∈ S i v ( p ) , S * = arg max S i V ( S i ) 确定 waypoint 后,FMM(Fast Marching Method) 负责规划到该位置的低层动作。到了最后一条子指令,系统还会使用 RepViT-SAM 提取目标分割掩码,投影到语义地图,将投影掩码的几何中心作为终点 waypoint。这里应区分普通阶段的超像素区域选点与最终目标定位。
评测基座 GPT-4 在导航开始前解析指令;Grounding DINO 检查物体;BLIP-2 分别承担地点 VQA 与约束相关的图文匹配;最终目标定位使用 RepViT-SAM。 实验数据 Habitat 中的 R2R-CE val-unseen(1,839 条)与 RxR-CE val-unseen 英语子集(3,669 条)。主要输入为 79° 水平视场角的单朝向 RGB-D 和里程计。 外部组件与执行 在线语义建图、置信度加权、历史衰减、轨迹掩码、SLIC 和 FMM。没有额外导航任务训练或学习型 waypoint predictor;仍依赖预训练视觉模型、深度与位姿。 本篇结果: R2R-CE / GPT-4 + Grounding DINO + BLIP2 · RxR-CE / GPT-4 + Grounding DINO + BLIP2
回到实验总表 ↑ 回到论文目录 ↑
09 VL-Nav Agent Framework Memory
VL-Nav: Neuro-Symbolic Reasoning-based Vision-Language Navigation
2025.02 首次预印本原论文 ↗ · 项目主页 ↗
1. 需要解决的问题
抽象需求需要先推断“到底要找什么”,再在未知环境中高效找到这些目标。 例如“外面下雨了,帮我找合适的衣物”,不能只检测任意一件 jacket,还需要判断它是否适合雨天,并可能继续寻找其他相关物品。
复杂指令需要拆解与持续更新: 一个需求可能对应多个目标,需要结合已发现的物体和空间关系,决定先探索哪里、再去哪个对象附近。目标类别不足以完成语义核验: 检测到“衣服”不代表找到“雨衣”,需要保留原始视觉证据,供模型进一步辨别。大场景探索需要控制计算与移动成本: 每个导航步都调用重型 VLM 会增加延迟;只追逐语义分数又容易在远处候选之间反复移动。2. Framework · 任务规划与探索执行
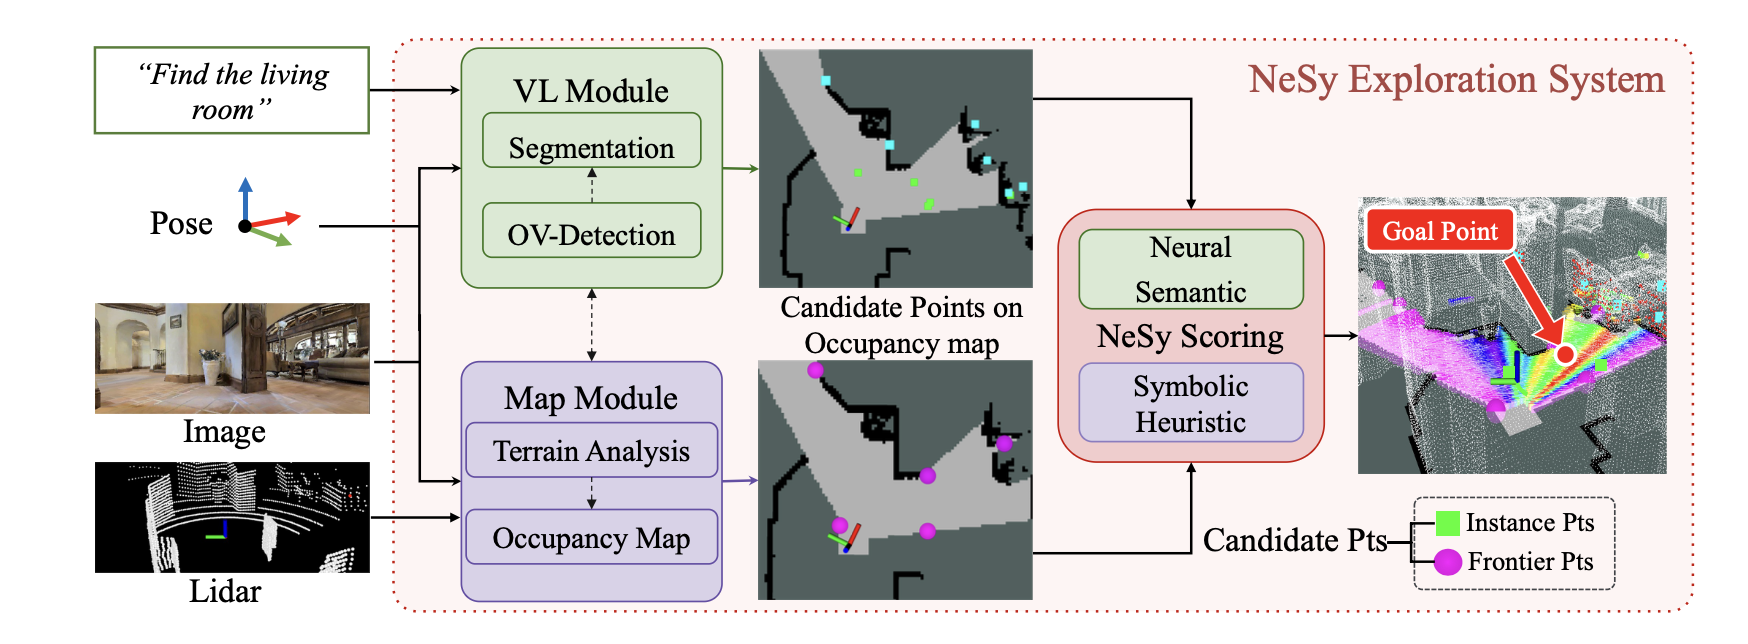
VL-Nav 由 NeSy Task Planner 与 NeSy Exploration System 两部分组成。上层用 Qwen3-VL 和场景图记忆分解任务、筛选目标并重规划;下层根据当前子任务,将开放词汇感知与几何启发式结合,选出目标位置并执行。
Figure 3 · NeSy Exploration System:实例点、前沿点与 NeSy Scoring 图片暂未加载,请通过图片链接查看。
图中展开的是探索执行部分 :VL Module 使用 YOLO-World 与 FastSAM 提供检测及分割结果;Map Module 利用几何观测进行地形分析与占据建图。两路分别提出实例候选点和前沿候选点,再由目标选择策略确定下一位置。上层任务规划器则通过 Memory 接收新发现,子任务完成后更新。
执行流程 解析需求与查询记忆 → 生成 exploration/go to 子任务 → 感知、建图与目标选择 → FAR Planner 执行 → 更新场景图和物体图像 → 子任务完成后重新规划。
3. Memory · 房间—物体场景图与最佳视角图像
统一记忆由 3D Scene Graph+Object-centric Image Memory 组成。场景图提供房间和物体之间的空间关系,图像记忆保存视觉证据。
4. Task Planner · 先筛选,再核验与重规划
Qwen3-VL 将复杂需求分成 exploration 和 go to 两类原子子任务,维护动态目标列表,并查询记忆来登记、跟踪潜在候选。
Symbolic Filtering: 先在场景图中按检测置信度选出 top-k 物体候选。Neural Verification: VLM 读取这些对象的最佳视角图像及邻接场景图节点,判断哪个真正符合抽象需求。提交导航目标: 确认对象后,发布记忆中保存的最佳观察机器人位姿 ,让执行系统前往并报告目标。完成后重规划: 每完成一个子任务,就根据更新后的记忆重新生成后续计划;新任务到达时也会触发规划。5. NeSy Exploration · 候选点与评分怎么做
下层系统接收当前子任务、RGB、位姿与 LiDAR,生成两种候选位置:
Frontier Points 占据图中自身为空闲、至少有一个未知邻居的栅格构成前沿。每次更新后,在当前前向视场和传感器有效距离内检测前沿,再用 BFS 聚类;小簇取中心,大簇采样多个代表点。 Instance Points 感知模块给出潜在目标实例的全局位置与置信度。保留高于检测阈值的候选,并通过体素网格下采样减少密集重复点。它们表示值得接近核验的线索,检测通过阈值还不等于任务完成。 神经语义分数: 将检测区域转换成水平视场中的方向分布,每个区域以检测方向为中心形成一个高斯,并按检测置信度加权。叠加后乘视场置信权重,降低视野边缘的贡献,再将语义分数限制在 0 到 1。论文实现使用固定的高斯角度宽度 0.1。
符号启发式: 一个目标是距离更近;一个在候选点周围做局部 BFS,统计未知栅格比例,目标是揭示更多未知空间的位置。前沿点评分为“加权距离分数+加权语义分数 × 未知区域分数” 。未知比例来自局部搜索范围,距离与未知区域项在选择目标时重新计算,首次被检测点时赋予语义分数。
因此,前沿选择同时考虑任务相关性、探索收益和移动代价。实例点用于接近并核验目标,仅使用语义分数,不使用前沿探索的 curiosity 项。
评测基座 Qwen3-VL-8B 负责高层任务规划,YOLO-World+FastSAM 负责开放词汇检测与分割。真机高层模型运行在远程 RTX 4090,实时导航栈运行在机器人端 Jetson Orin NX。 实验数据 DARPA TIAMAT Phase 1 的导航部分:Apartment 1、Apartment 2、Camping Site、Factory 四个环境,每个环境 8 项任务、每项重复 3 次,共 96 次试验;仿真使用五路 RGB-D 的 Spot。真机覆盖走廊、办公室、公寓、室外,共 9 类任务,每项重复 3–5 次;多楼层另有演示。 外部组件与执行 Super Odometry 提供状态估计,LiDAR 支持地形分析和占据建图,FAR Planner 执行目标位置导航。评测无需新增导航任务训练;真机 VLFM 对照将原有 BLIP-2 替换为相同的 YOLO-World+FastSAM 感知模块。 本篇结果: DARPA TIAMAT Phase 1 / Qwen3-VL-8B;YOLO-World + FastSAM · DARPA TIAMAT Phase 1 / Qwen3-VL-8B;YOLO-World + FastSAM · DARPA TIAMAT Phase 1 / Qwen3-VL-8B;YOLO-World + FastSAM · DARPA TIAMAT Phase 1 / Qwen3-VL-8B;YOLO-World + FastSAM
回到实验总表 ↑ 回到论文目录 ↑
10 GC-VLN: Instruction as Graph Constraints for Training-free Vision-and-Language Navigation
2025.09 首次预印本原论文 ↗ · 官方代码 ↗
1. 需要解决的问题 如何把语言中的空间关系转成连续环境中可计算的路径,并在一种解释走不通时重新选择? 指令不仅给出目标物体,还描述经过顺序、移动方向,以及路径与物体之间的关系。
语言关系到空间坐标的落地: “穿过门后左转”“从两把椅子之间走过去”同时约束路径、物体和方向,不能只拆成一串要寻找的物体;需要明确哪些位置满足这些关系。同一指令可能对应多个候选: 环境中可能有多个同类物体,满足当前关系的位置也可能不止一个。选择了局部可行的门或航点,后续仍可能无法继续,因此需要保存其他候选,并能回退重新尝试。2. Framework · 图约束求解与导航树
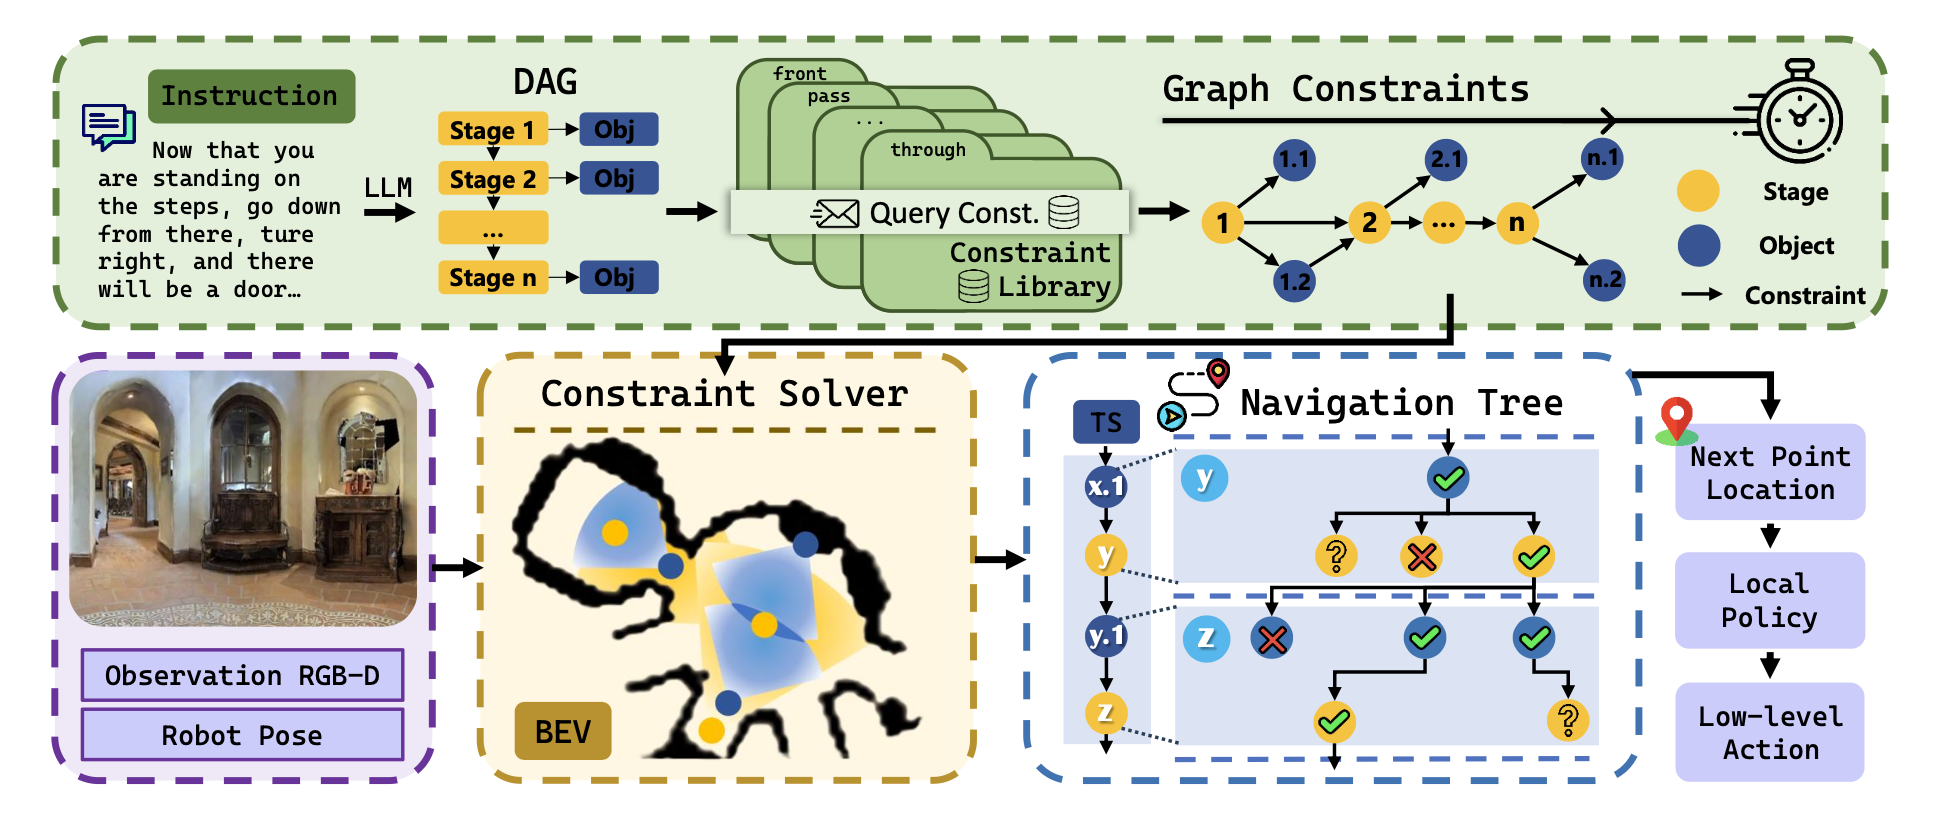
Figure 2 · GC-VLN 图约束导航框架 图片暂未加载,请通过图片链接查看。
两部分框架:Graph Constraint Construction 将指令转换为阶段、物体及其空间关系;Constrained Optimization 结合观测求解节点坐标。
整体流程 指令 → LLM 分解为 DAG → 查询空间约束库 → 按拓扑顺序感知物体、求解航点 → 展开导航树 → FMM 执行 → 有解则继续,无解则回溯。
3. Graph Constraints · 指令如何变成几何问题 LLM 将指令拆成多个导航阶段。每个阶段恰好包含一次位置变化,单独旋转不算一个阶段。 阶段记录移动方向及沿途涉及的物体;每个指令物体归属一个阶段。移动方向从 front / right / left / back / unknown 中选取,物体还带有 through、pass、near 等与路径相关的描述。
用 DAG 中的关系查询预定义的 Constraint Library ,把语言关系实例化为坐标约束。论文按角度、距离信息以及涉及的节点数构造六类模板:
这些约束带有角度和距离容差,将语言描述转换成允许一定误差的可行区域。下一航点需要同时满足指向它的多条约束,因此求解实际上是在寻找这些空间条件的交集。
4. Constraint Solver · 物体靠感知定位,航点靠约束求解 最初只有起点坐标已知,设为 (0, 0),其他节点坐标随导航逐步确定。系统先对约束图做拓扑排序(TS) :父节点在子节点之前;同一父节点下优先处理物体节点,再处理航点;多个物体按指令中的提及顺序排列。
确定物体坐标: Grounded-SAM-2 从 RGB-D 观测中感知物体,将其投影到 BEV 地图。只保留满足对应空间约束的物体坐标。求解航点坐标: 当某个航点的全部父节点坐标已知后,将来自前序航点和相关物体的约束共同交给非线性约束求解器。生成多个可行位置: 重复求解时,要求新解与已经得到的解至少相隔一定距离,避免候选集中在同一个位置附近。用 $$v$$ v $$C_v$$ C v
$$\max_v\sum_{c\in C_v}\operatorname{sum}(c)\quad\text{s.t.}\quad\min(c)\ge0,\ \forall c\in C_v$$ max v ∑ c ∈ C v sum ( c ) s.t. min ( c ) ≥ 0 , ∀ c ∈ C v 每条约束包含角度或距离子约束;非负条件保证各项满足,再在可行范围内最大化子约束值之和。第 $$k$$ k
$$\|v-x_j\|\ge L,\qquad j=1,\ldots,k-1$$ ‖ v − x j ‖ ≥ L , j = 1 , … , k − 1 其中 $$x_j$$ x j $$L$$ L
5. Navigation Tree · 多解保留分支,无解触发回溯 约束图中的节点是待定位的航点或物体,导航树中的节点则是它们的具体坐标候选。 导航树的每一层对应拓扑序中的一个图节点;这一节点有多少个可行坐标,就可以展开多少条候选分支。沿树选择的一条路径,逐步确定本次导航采用的物体实例和航点位置。
有多个解: 将候选保留为不同分支,先沿其中一条继续求解和导航,其余留待后续尝试。后续节点无解: 当前分支不能继续,沿树向上回退,直到找到仍有未探索兄弟分支的分叉点。尝试另一条解释: 转向该分叉点的下一条未探索分支,依据新的坐标组合继续求解,而不是从头重建整个导航过程。执行与结束: 局部策略 FMM 将选定 waypoint 转为低层动作;到达最终航点后结束导航。评测基座 DeepSeek-R1 负责指令分解;Grounded-SAM-2 负责物体感知与定位;后续航点由图约束求解器计算。 实验数据 Habitat/MP3D 场景上的 R2R-CE 与 RxR-CE validation-unseen,分别为 1,839 和 11,006 条 episode。RxR-CE 包含三种语言;另有 Hexmove 机器人上的实景导航展示。 外部组件与执行 RGB-D 与机器人位姿、BEV 物体投影、预定义空间约束库、非线性约束求解、导航树与回溯,以及 FMM 局部规划。框架无需额外导航任务训练,使用预训练语言和视觉模型。 本篇结果: R2R-CE / DeepSeek-R1 + Grounded-SAM-2 · RxR-CE / DeepSeek-R1 + Grounded-SAM-2
回到实验总表 ↑ 回到论文目录 ↑
11 LaViRA: Language-Vision-Robot Actions Translation for Zero-Shot Vision Language Navigation in Continuous Environments
2025.10 首次预印本原论文 ↗ · 官方代码 ↗
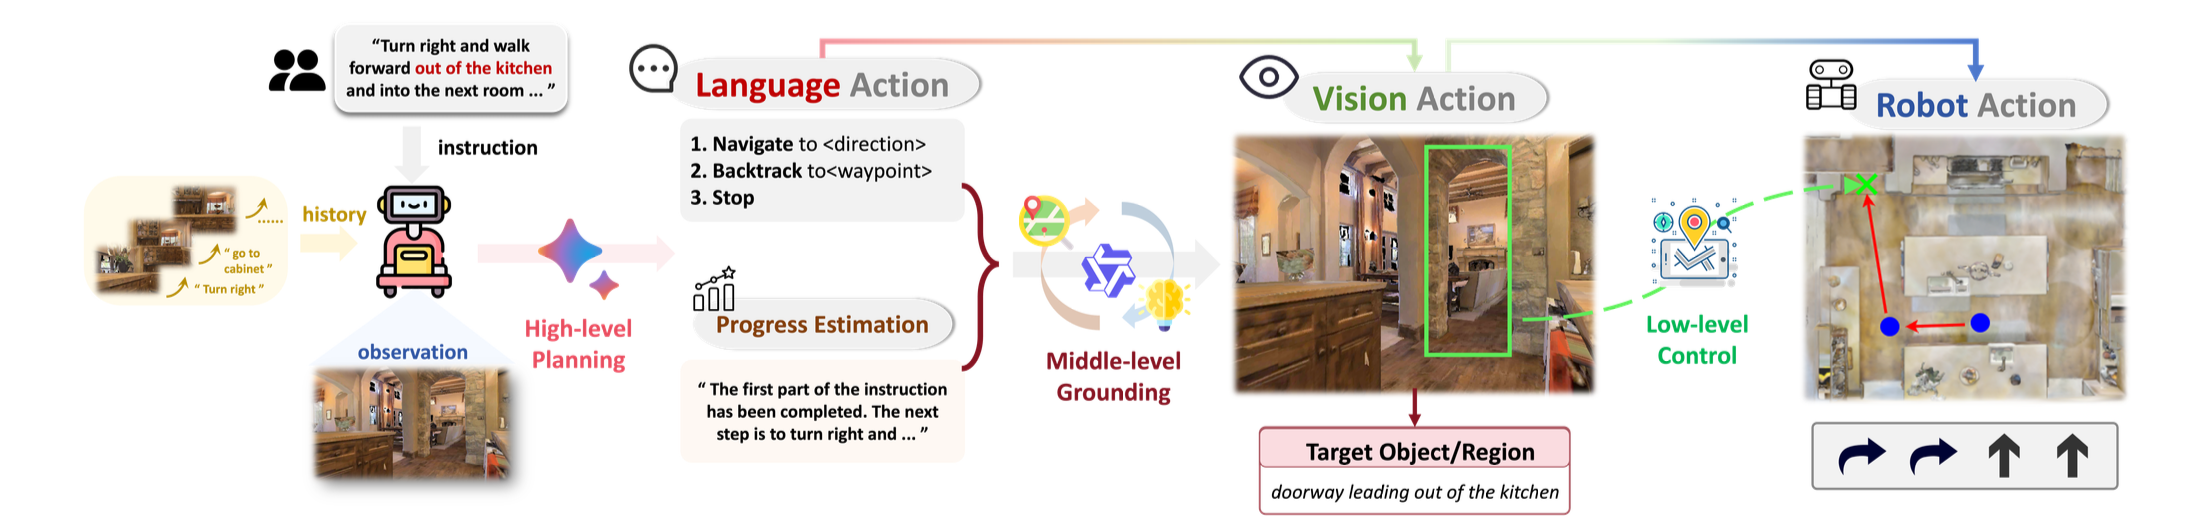
1. 需要解决的问题 能否在不依赖预训练 waypoint predictor 的情况下,让 MLLM 持续参与导航过程中的推理与决策? LaViRA 将问题放在两类零样本方案之间:
航点预测器限制了可选目标: 大模型选择用预训练 predictor 生成的候选航点。高层有推理能力,但候选质量和跨场景泛化受独立预测器影响。价值地图方案没有充分利用在线推理: 把强语言模型主要用于导航前的指令解析,运行时依靠视觉语言匹配分数和地图规则前进。省去了航点预测器,但导航中的进度判断、策略调整和纠错没有充分利用 MLLM。LaViRA 因而将导航拆成三种粒度的动作:先判断大致往哪里走,再在图像中确定具体目标,最后把目标转换为机器人运动。
2. Framework · Language → Vision → Robot Language Action 负责语义规划,Vision Action 负责视觉定位,Robot Action 负责几何投影与执行。
Figure 2 · LaViRA 三层动作转换 图片暂未加载,请通过图片链接查看。
执行闭环 指令 + 四方向观察 + 视觉历史 → 语言动作与进度估计 → 所选方向的目标框 → 深度反投影与地图目标 → FMM 执行 → 新观测与历史更新。高层也可选择回溯到历史航点,或停止导航。
3. Language Action · 选方向,同时判断指令进度 高层由 GPT-4o 或 Gemini-2.5-Pro 承担,输入是完整指令、当前前/左/右/后四方向图像,以及过去的视觉观察与动作 。它每轮同时输出自然语言的 Progress Estimation 和一个语言动作:
navigate to <direction>:从前、左、右、后选择方向,确定接下来在哪张图中寻找目标。backtrack to <waypoint>:选择一个已经访问过的航点,返回该位置。stop:结束当前导航任务。进度估计连接了前后两层。 模型判断“已经走出厨房,下一步要进入相邻房间”,这里的完成进度由 MLLM 根据历史和观察作出自然语言判断。
4. Vision Action · 从方向落实到目标框 选择导航方向后,Qwen2.5-VL-32B 读取原始指令、高层的进度估计,以及所选方向的单张图像 。Prompt还提供已访问目标,要求结合进度选择下一处相关物体或区域。
输出包括 bbox_2d = [x1, y1, x2, y2] 和目标描述。提示要求一次只定位一个目标,并避免选择太近的目标 ,让下一次移动能够带来实际进展。高层负责从多方向观察中做整体判断,中层集中处理所选画面里的定位问题。
5. Robot Action · 从目标像素到可执行运动 取目标框底边中心: 横坐标取左右边界的平均值,纵坐标取框的下边界,从视觉框得到一个确定的目标像素。用深度恢复三维位置: 读取该像素深度,结合相机内参将二维像素反投影到相机坐标系。转换到全局地图: 再根据机器人位姿进行坐标变换,得到二维地图上的目标位置。用于路径规划的全局地图由带位姿的深度观测构建。规划并执行: FMM 计算通向目标的短程路径,底层控制器执行运动并局部避障。到下一轮决策时,再用实际观察更新历史和进度判断。深度反投影可写为:
$$\mathbf{p}_{\mathrm{cam}}=dK^{-1}\begin{bmatrix}u\\v\\1\end{bmatrix}$$ p cam = d K − 1 [ u v 1 ] 其中,$$(u,v)$$ ( u , v ) $$d$$ d $$K$$ K
6. History 与回溯 · 怎样跟踪进度、纠正路线 视觉历史: 默认保留当前回合中过去的视觉观察与动作,让高层比较“之前看到了什么、做了什么、现在到了哪里”。这些信息支持进度估计;中层提示中的已访问目标帮助确定下一处应该关注的地标。
灵活回溯: 高层可以选择任意已访问航点返回。提示建议在当前路径没有进展或遇到死路时回溯,返回后继续根据新观察规划。因此恢复位置由高层结合历史选择;论文没有给出独立的失败验证器或固定超时触发规则。
评测基座 Language Action 使用 GPT-4o 或 Gemini-2.5-Pro;Vision Action 主要使用 Qwen2.5-VL-32B。 实验数据 Habitat/Matterport3D 上的 R2R-CE val-unseen 100 条 episode 子集;同一子集重复运行 3 次,报告均值与标准差。另在 Unitree Go1 和 Agilex Cobot Magic 上展示真机导航。 外部组件与执行 640×480 RGB-D、相机内参与位姿、深度建图、像素到世界坐标的几何变换,以及 FMM 和底层避障控制器。官方代码的语义建图还使用 GroundingDINO/SAM 等预训练组件。无需导航专用微调或学习式 waypoint predictor,使用通用预训练 MLLM。 本篇结果: R2R-CE / GPT-4o+Qwen2.5-VL-32B · R2R-CE / Gemini-2.5-Pro+Qwen2.5-VL-32B
回到实验总表 ↑ 回到论文目录 ↑
12 SpatialNav: Leveraging Spatial Scene Graphs for Zero-Shot Vision-and-Language Navigation
2026.01 首次预印本原论文 ↗ · 官方代码 ↗
1. 需要解决的问题
零样本导航主要依赖眼前的局部观察,缺少对整栋建筑布局和物体分布的了解。 例
SpatialNav 因而采用任务前允许充分探索环境 的设定:先把环境几何与语义组织成可复用的空间记忆,再让导航模型按需读取。它要解决的是如何让模型利用全局环境知识,判断当前位置、周围房间以及下一候选位置附近有什么。
2. Framework · 预建空间记忆,导航时查询
Figure 3 · SpatialNav:空间场景图、局部地图与远处物体查询 图片暂未加载,请通过图片链接查看。
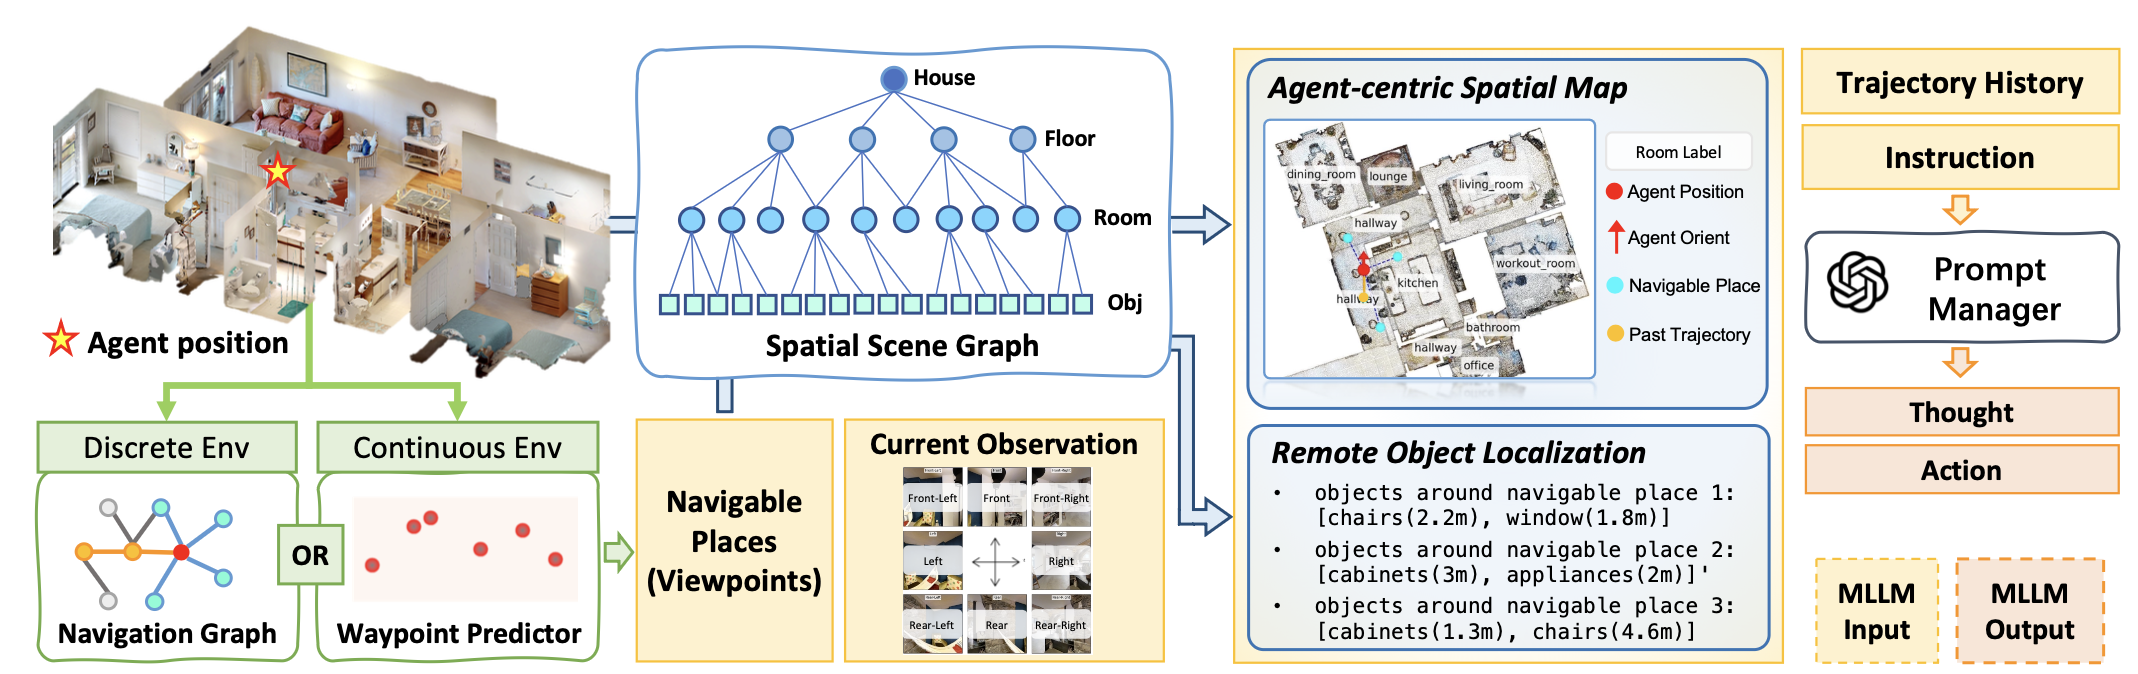
核心记忆是 Spatial Scene Graph(SSG) 。它将环境整理为 House → Floor → Room → Object 的层级结构,在同一场景中可供不同 episode 复用。每轮决策从这份记忆读取两类信息:一是智能体周围的空间布局,二是各候选位置附近的物体语义。
Prompt Manager 将这些信息与当前全景观察、导航指令和轨迹历史一起交给 GPT-5.1,由模型输出下一步导航决策。离散环境的候选位置来自已有导航图;连续环境则使用 SmartWay 的 waypoint predictor 生成候选。
执行流程 准备环境点云 → 构建楼层—房间—物体记忆 → 根据当前位姿读取局部地图 → 查询候选位置周围的物体 → 对齐地图与罗盘全景 → 结合指令和历史选择动作 → 移动后更新位置并再次查询。
3. Memory · SSG 保存什么,怎么构建
SSG 同时保存空间范围、层级归属和语义类别 。图中的边表示建筑、楼层、房间和物体之间的包含关系;每个实体还保存记录中心、朝向和尺寸。
构图分为四步:
Floor Segmentation: 统计点云的高度直方图,通过 DBSCAN 和峰值筛选区分不同楼层。Room Segmentation: 在每个楼层内使用几何启发式划分封闭区域,开放空间的房间边界容易不明确。Room Classification: 收集预探索阶段在各房间拍到的图像或视频帧,让 GPT-5 按预定义类别表标注房间类型。Object Detection: 用房间级点云作为 SpatialLM 的输入,预测物体类别及包围盒。预建 SSG 是环境记忆,当前导航的轨迹历史则作为另一份上下文提供给模型。
4. Agent-centric Spatial Map · 从全局记忆中读取局部布局
每一步先按智能体的高度定位楼层,再按平面坐标确定房间,读取同一楼层中当前位置附近的房间布局 ,生成一张俯视空间地图。
限制查询范围: 默认地图为 1024×1024,单格 0.015 米,论文设置的感知半径为 7.68 米。统一方向: 始终将智能体的当前朝向旋转到地图上方,让图中的前、后、左、右与自身观察一致。叠加决策线索: 显示房间标签、当前位置与朝向、候选可导航位置和过去的轨迹,帮助模型比较不同入口及路线。5. Compass-like Observation · 将八方向观察与地图对齐
系统每隔 45° 获取一个方向,共八张视图,每张视图的视场角为 90°。八张 256×256 图组成一张 1024×1024 拼图,与空间地图共享以自身朝向为基准的方向关系。
6. Remote Object Localization · 提前查询候选位置附近有什么
空间地图主要说明布局;物体查询进一步回答:“如果选择这个候选位置,它附近有哪些与指令相关的地标?” 对每个候选,论文实现先找到它所属的房间,读取该房间内的物体,按预测类别分组,再把类别及其到候选位置的距离压缩成文本。
查询依据 候选位置的空间坐标、所在房间以及 SSG 中的包含关系。检索范围按空间位置确定,之后由导航模型结合指令判断这些物体线索是否有用。 返回内容 例如“候选 1 附近:chair(2.2 m)、window(1.8 m)”。这里的距离以候选位置为参照,提供尚未到达位置周围的环境知识。 进入决策 物体文本与局部地图、当前罗盘图、指令、历史一同送入模型。模型比较候选后选择动作,移动到新位置再重新查询。 论文消融还发现:只有文字观察时,远处物体描述可能与当前所见混淆;加入罗盘视觉观察后,更容易分清眼前的证据 和候选位置的记忆线索 。
评测基座 GPT-5.1 负责导航决策;GPT-5 标注房间类型;SpatialLM 预测物体语义与包围盒。另有 Gemini-2.5-Pro、Qwen3-VL-Plus 的基座对比。 实验数据 离散环境评测 R2R 与 REVERIE val-unseen;连续环境在 Habitat 中分别随机采样 R2R-CE 的 100 条、RxR-CE 的 200 条轨迹。普通 SpatialNav 的 R2R-CE SR 为 64.0%;使用真值空间标注的 SpatialNav† 为 68.0%,属于另一个参考设置。 外部组件与执行 依赖预先可用的环境三维结构、房间分割与人工校验;物体感知包含 SpatialLM 微调,连续候选生成复用 SmartWay 的 waypoint predictor。零样本描述的是导航决策设定,整套系统仍包含这些训练与环境准备步骤。 本篇结果: R2R-CE / GPT-5.1导航;GPT-5房型;微调SpatialLM;SmartWay · RxR-CE / GPT-5.1导航;GPT-5房型;微调SpatialLM;SmartWay
回到实验总表 ↑ 回到论文目录 ↑
13 slow4fast-VLN Memory Double System
Towards Open Environments and Instructions: General Vision-Language Navigation via Fast-Slow Interactive Reasoning
2026.01 首次预印本原论文 ↗ · 官方代码(部分实现)↗
1. 需要解决的问题
在住宅中训练的导航策略,遇到商场、办公室等新环境,以及不同表达风格的指令时,容易沿用不适合当前场景的决策习惯。 即使慢推理能够分析一次失败,如果这些经验没有进入后续的快策略,类似问题仍会反复发生。
环境变化: 不同建筑的布局、地标和功能关系存在差异,快策略需要积累可用于新场景的空间规则与导航经验。快慢系统缺少经验传递: 慢模型分析出的知识需要被保存、检索,并转化为快策略能使用的输入。指令风格变化: 同一导航意图可能以标准路线、场景习惯或个性化口吻表达,增加已有策略理解指令的难度。2. Framework · 快系统执行,慢系统提炼经验
Figure 2 · Fast Reasoning、Slow Reasoning 与经验反馈 图片暂未加载,请通过图片链接查看。
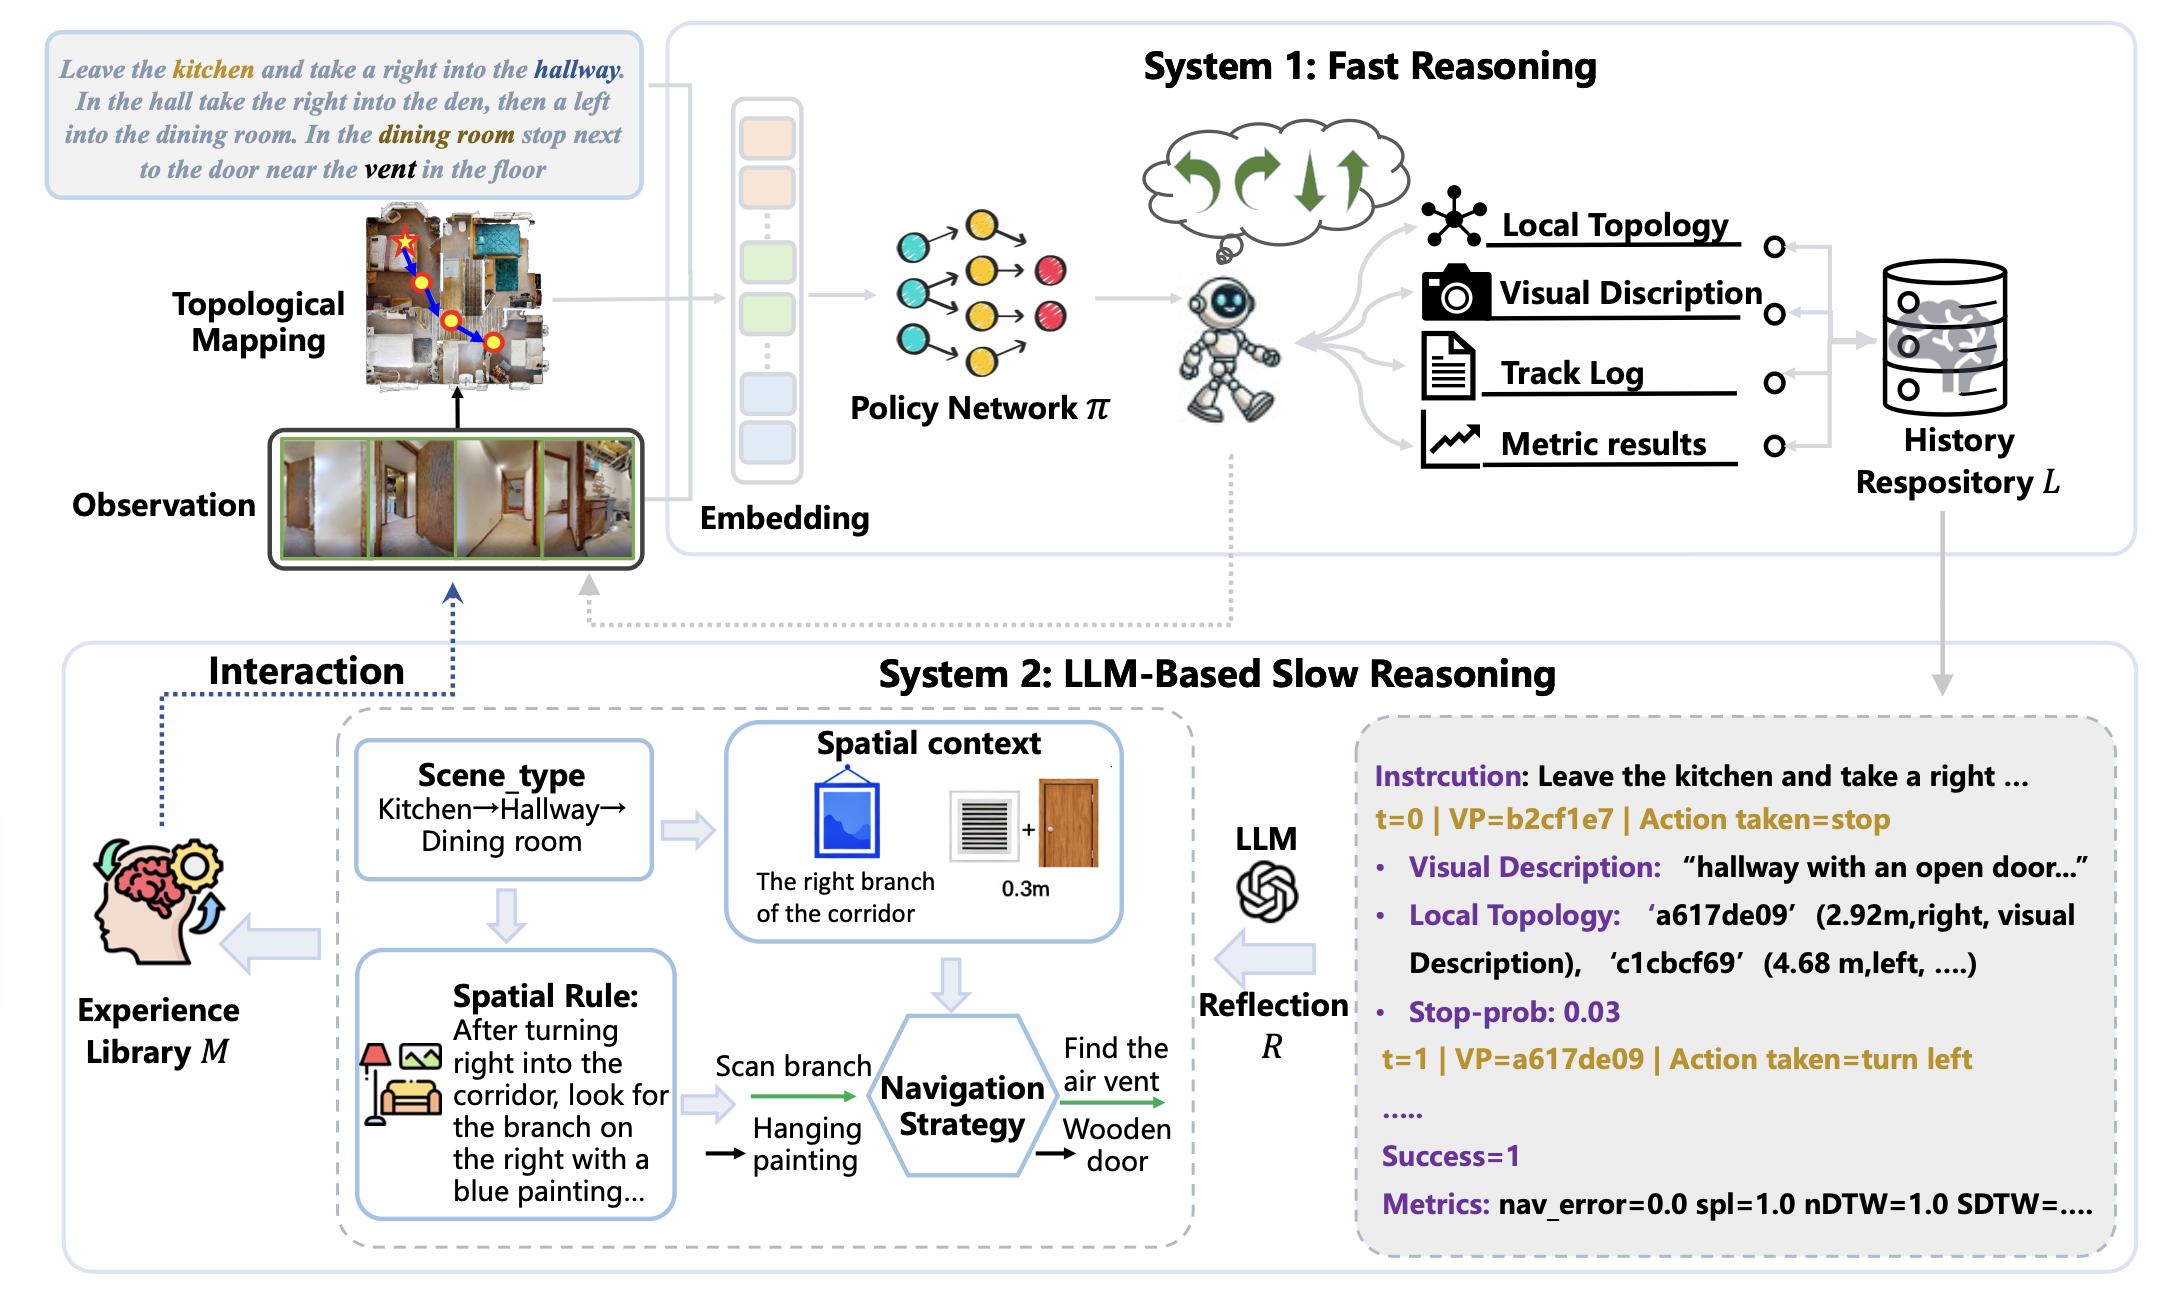
System 1 使用已训练的 DUET 策略网络,根据当前观察、指令和拓扑历史选择动作,同时记录执行过程。System 2 使用 Llama3.2-Vision 分析这些记录,将成功与失败中的知识整理成结构化经验。后续导航时,检索相关经验,通过特征融合增强 DUET 的决策。
两个存储承担不同角色:History Repository 保存“这次导航发生了什么”,Experience Library 保存“从这些经历中提炼出了什么规则和策略”。
交互流程 快策略执行并记录 → episode 后分析历史 → 提炼经验并写入经验库 → 后续决策按当前上下文检索 → 编码经验、与视觉特征融合 → 快策略输出动作并继续积累记录。
3. Fast Reasoning · DUET 如何行动与记录
快系统输入包括语言指令、全景图像、位置、邻接节点和导航历史。拓扑建图模块持续维护已访问、可导航和当前节点;DUET 的粗粒度分支评估全局导航目标,细粒度分支处理局部动作,再动态融合分数,选择下一视点或停止。
Llama3.2-Vision 为视点生成视觉文字描述。执行过程中,每一步写入 History Repository 的信息包括:
时间与位置 时间戳、步序和当前视点,记录动作发生的顺序与地点。 局部拓扑 邻居视点、相对方位和距离,用于还原当时有哪些路径可选。 指令与动作 当前导航指令及实际选取的动作,便于对照任务要求与执行过程。 视觉与指标 视点的视觉描述、停止概率和轨迹有效性等步级指标;框架图还展示 episode 的成功状态、导航误差、SPL、nDTW 等结果。 4. Slow Reasoning · 从日志到结构化 Memory
慢系统使用结构化反思提示:先指定角色与分析任务,再填入导航日志,将分析拆为场景识别、空间关系和策略总结等部分,最后约束输出格式。
5. Fast–Slow Interaction · 经验怎样进入快策略
快慢交互的具体实现是检索经验 → 向量编码 → 注意力融合 → 导航策略预测 ,经验最终进入 DUET 的视觉特征。
构造检索条件: 从当前上下文提取场景类型、空间上下文和导航策略相关特征。筛选相关经验: 计算当前特征与经验库中各条记录的相似度,保留超过检索阈值的条目,再按相似度排序,取最相关的若干条。编码为经验向量: 论文明确对场景类型、空间上下文、导航策略三个离散字段分别做 embedding,再通过线性层和激活函数得到经验表示。用当前视觉查询经验: 在多头注意力中,视觉特征作为 Query,检索出的经验特征作为 Key 和 Value,得到与当前观察相关的经验信息。融合后预测动作: 将注意力输出与原视觉特征拼接,经模型恢复到原视觉维度,再输入 DUET,与语言指令共同计算动作概率和导航置信度。评测基座 快系统使用 DUET,视觉特征由 CLIP-ViT-B/16 提取,文本编码器为 9 层 Transformer;慢系统和视觉文字描述使用 Llama3.2-Vision,正文未明确其参数规模。 实验数据 GSA-R2R 离散导航,组合 HM3D 与 MP3D,覆盖 150 个评测场景:75 个住宅场景和 75 个非住宅场景。指令包含 Basic、Scene、User 三类,评估环境变化与语言风格变化下的适应能力。 外部组件与执行 使用全景观察、位置和可导航邻接节点,动作是选择离散视点或停止。依赖已训练的 DUET,并增加经验编码与注意力融合模块。日志包含成功与轨迹指标,原文对测试期反馈来源、经验保留及跨场景重置规则说明有限。 官方仓库 已公开部分实现;其中反思模块 仍包含固定模拟返回和随机经验嵌入等占位逻辑,完整实验复现尚未核验。
本篇结果: GSA-R2R(离散) / 已训练DUET + CLIP-ViT-B/16;Llama3.2-Vision(规模未明确) · GSA-R2R(离散) / 已训练DUET + CLIP-ViT-B/16;Llama3.2-Vision(规模未明确) · GSA-R2R(离散) / 已训练DUET + CLIP-ViT-B/16;Llama3.2-Vision(规模未明确)
回到实验总表 ↑ 回到论文目录 ↑
14 3DGSNav: Enhancing Vision-Language Model Reasoning for Object Navigation via Active 3D Gaussian Splatting
2026.02 首次预印本原论文 ↗ · 项目主页 ↗
1. 需要解决的问题
零样本找物导航中,VLM 的判断受限于系统给它保留了多少视觉与空间信息。 把历史观察压成物体名称、文字描述或语义地图后,外观细节、遮挡关系和空间结构容易丢失;当机器人需要重新判断某个区域或目标时,已有表示未必能提供足够证据。
观察不完整: 固定转圈扫描会产生重复观察,也不一定补到真正缺失的方向,需要根据当前建图情况主动补拍。候选方向看不清: 前沿位于已探索与未知区域的边界,直接从边界渲染容易得到局部、遮挡或大面积空缺的画面,影响 VLM 判断往哪里探索。检测结果不可靠: 单个视角可能把相似物体误认成目标;为复核而反复移动机器人,又会增加导航成本。2. Framework · 建图、选前沿与目标复核
Figure 2 · Perception、Planning 与 Re-verification 图片暂未加载,请通过图片链接查看。
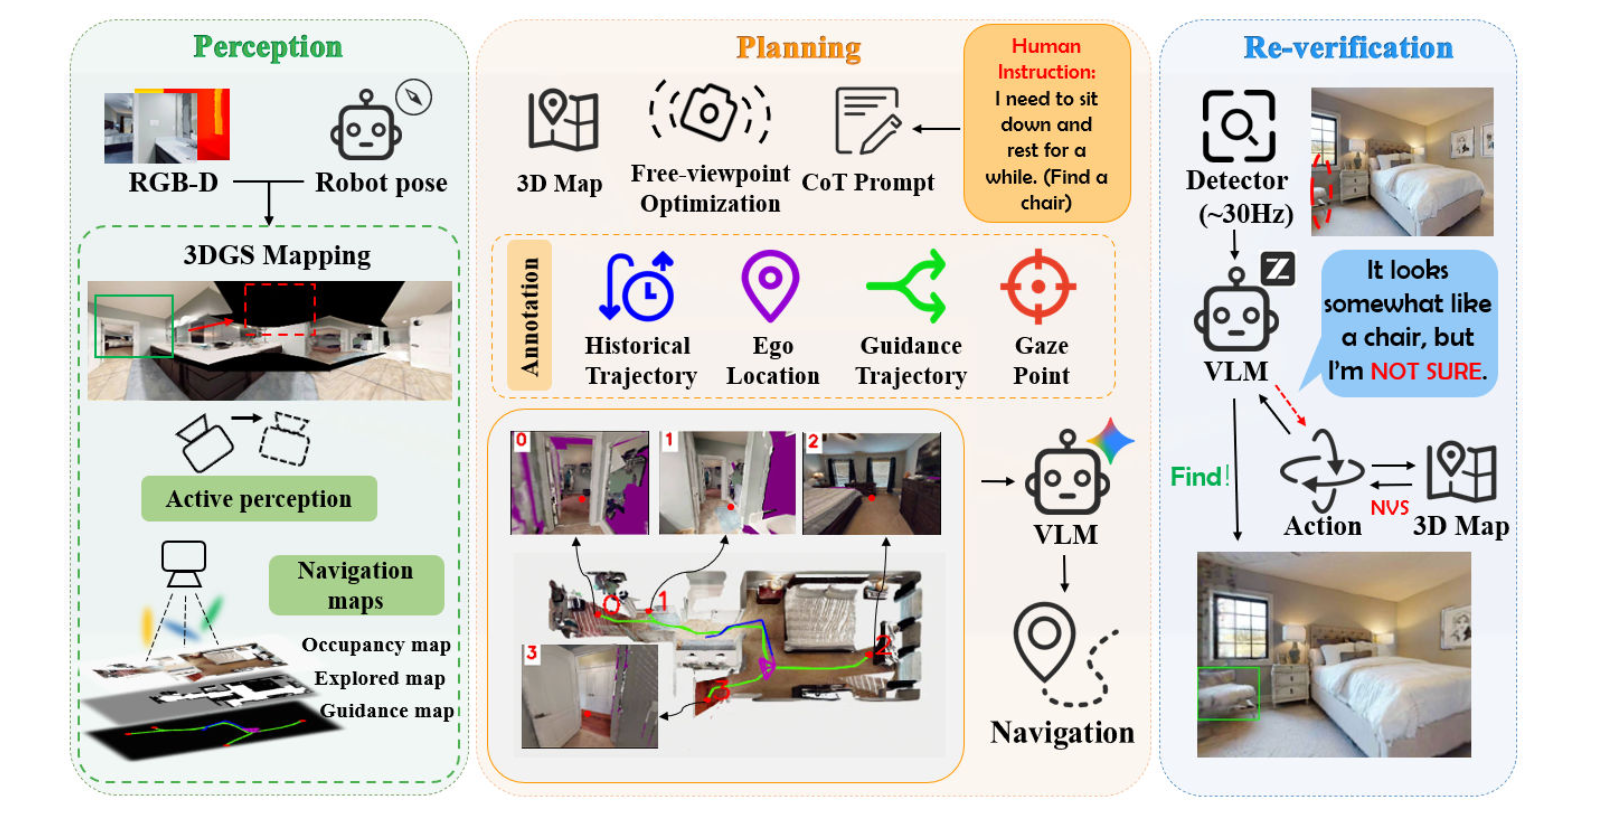
3DGSNav 的核心是把探索过的环境保存成可重新渲染的 3D Gaussian Splatting 场景 。真实相机持续提供 RGB-D 和位姿,系统从中构建几何与外观;规划时为候选前沿生成更合适的观察视角,结合俯视图交给 VLM;发现疑似目标后,再利用已建好的场景进行多视角复核。
执行流程 RGB-D/位姿更新 3DGS → 根据视觉缺口补拍 → 提取并聚类前沿、计算引导路径 → 优化虚拟视点 → 标注 FPV+BEV、VLM 选择前沿 → FMM 执行并检测目标 → 对疑似目标做虚拟视角复核;未确认目标时继续探索。
3. Perception · 3DGS 如何建图与主动补拍
每个三维高斯保存位置、不透明度、颜色和形状信息,后端用颜色误差、结构相似度(SSIM)和深度误差 持续优化场景。
定位观察缺口: 在当前位置渲染全景不透明度场,用低不透明度区域估计尚未充分观察的位置;论文阈值为 0.3。确定补拍方向: 用 DBSCAN 聚类低不透明度区域,选面积最大的区域,并将其中心转换成相机的 yaw/pitch。真实获取新证据: 控制真实相机转向该方向,补充 RGB-D 观察,再更新 3DGS。这里发生实际感知,用来补全地图。系统还从 3DGS 的俯视渲染和智能体高度信息构建用于导航的地图:
4. Free-viewpoint Optimization · 为候选区域选择观察位置
系统先确定要评估的前沿,再优化“从哪里看这个前沿”。 对每个候选,沿引导路径寻找距前沿 1–4 米的初始化位置。
Opacity Loss 惩罚画面中未观察区域占比过大,避免候选视图只有大片空缺、缺少可用于判断的环境细节。 Ray Occlusion Loss 沿相机到前沿的射线检查深度关系,减少前沿被遮挡的情况,使候选位置更容易被直接观察。 View Alignment Loss 约束相机朝向与前沿方向对齐;前沿被遮挡时,相应朝向约束会减弱。 Guidance Trajectory Loss 用相机到路径点集的平滑距离约束,让相机在引导路径附近调整,并结合观察完整度与前沿距离引导位置优化。 5. 视觉标注与 CoT · 怎样比较前沿的探索价值
每个候选的第一视角图(FPV)与全局俯视图(BEV)组成一张输入图:FPV 标出前沿编号、红色注视点和紫色未知区域;BEV 标出对应前沿、引导路径、蓝色历史轨迹以及紫色的机器人位置与朝向。 这些标记将“画面中的入口”与“地图上的位置和路线”对应起来。
CoT 将判断分为四步:
FPV 空间分析: 根据注视点附近的结构、物体和可见入口,判断该前沿实际通向哪里,区分已观察证据与未知区域。BEV 布局分析: 判断前沿相对机器人和其他候选的位置、到达路径,以及是否曾沿历史轨迹经过。房间与目标匹配: 结合可见线索推断功能区,判断该区域与目标物体的关系;线索不足时保留不确定性。前沿排序与选择: 综合到达距离、目标匹配程度和探索潜力,规划候选顺序,最终输出一个 Final Choice 前沿编号。提示还给出三项候选评分:房间类型匹配(−2~4)、探索潜力(0~4)、历史轨迹重叠(−2~0) 。这些分数用于比较前沿的优先级;几何地图和引导路径提供可达性与路线信息。最终由 VLM 选择前沿,再由 FMM 负责导航执行。
6. Re-verification · 用虚拟动作复核目标
导航过程中,YOLOE 根据目标文本检测疑似物体;候选图像交给 GLM-4.5V,结合物体形状、环境结构和遮挡关系判断是否需要进一步查看。
选择复核动作: 动作集合包含虚拟前进/后退 0.25 米、左转/右转 10°,以及 leave。从 3DGS 重新渲染: 将所选视点变换应用到虚拟相机,生成新的观察图,再检查疑似目标,减少由局部遮挡或相似外观引起的误判。限制复核次数: 每轮最多允许 5 次动作决策,避免复核过程无限持续。真实主动感知负责补充缺失信息,虚拟复核负责从已有重建中获取不同视角。
评测基座 Gemini 3 Pro 负责探索规划;GLM-4.5V 负责目标复核;YOLOE-11m-seg 负责开放词汇目标检测。另以 Qwen3-VL-32B-Thinking 和 Qwen3-VL-235B-A22B-Thinking 做规划基座对比。 实验数据 Habitat 中的 HM3D-v1、HM3D-v2 和 MP3D ObjectNav;每个 episode 最多 500 步,成功距离阈值为 1 米。另在 Go2 四足机器人上开展真实环境实验。 外部组件与执行 依赖 RGB-D、位姿与可调整俯仰的相机;DBSCAN、watershed、Dijkstra 分别用于观察缺口聚类、前沿归并与引导路径生成,仿真导航使用 FMM,真机集成 Nav2。VLM 与导航策略无需任务微调,运行时仍会优化 3DGS 参数和虚拟相机位姿。 官方项目页 仍标注 Code (Coming soon),截至 2026-10-08 按“未开源”标记。
本篇结果: HM3D-v1 ObjectNav / Gemini 3 Pro规划;GLM-4.5V复核;YOLOE-11m-seg · HM3D-v2 ObjectNav / Gemini 3 Pro规划;GLM-4.5V复核;YOLOE-11m-seg · MP3D ObjectNav / Gemini 3 Pro规划;GLM-4.5V复核;YOLOE-11m-seg
回到实验总表 ↑ 回到论文目录 ↑
15 ProFocus: Proactive Perception and Focused Reasoning in Vision-and-Language Navigation
2026.03 首次预印本原论文 ↗
1. 需要解决的问题
ProFocus 关注两个问题:一方面“看得太多” ,把全景或多视图直接交给 VLM,视觉冗余会掩盖指令真正需要的细粒度线索;另一方面“想得太散” ,把大量历史 waypoint 和观察一视同仁地交给 LLM,长程推理的注意力就容易被分散。
因此,它需要同时回答:当前还缺什么视觉证据,应该去图像的哪里找?历史中哪些航点及其关联路线,值得在这一步重点回看?
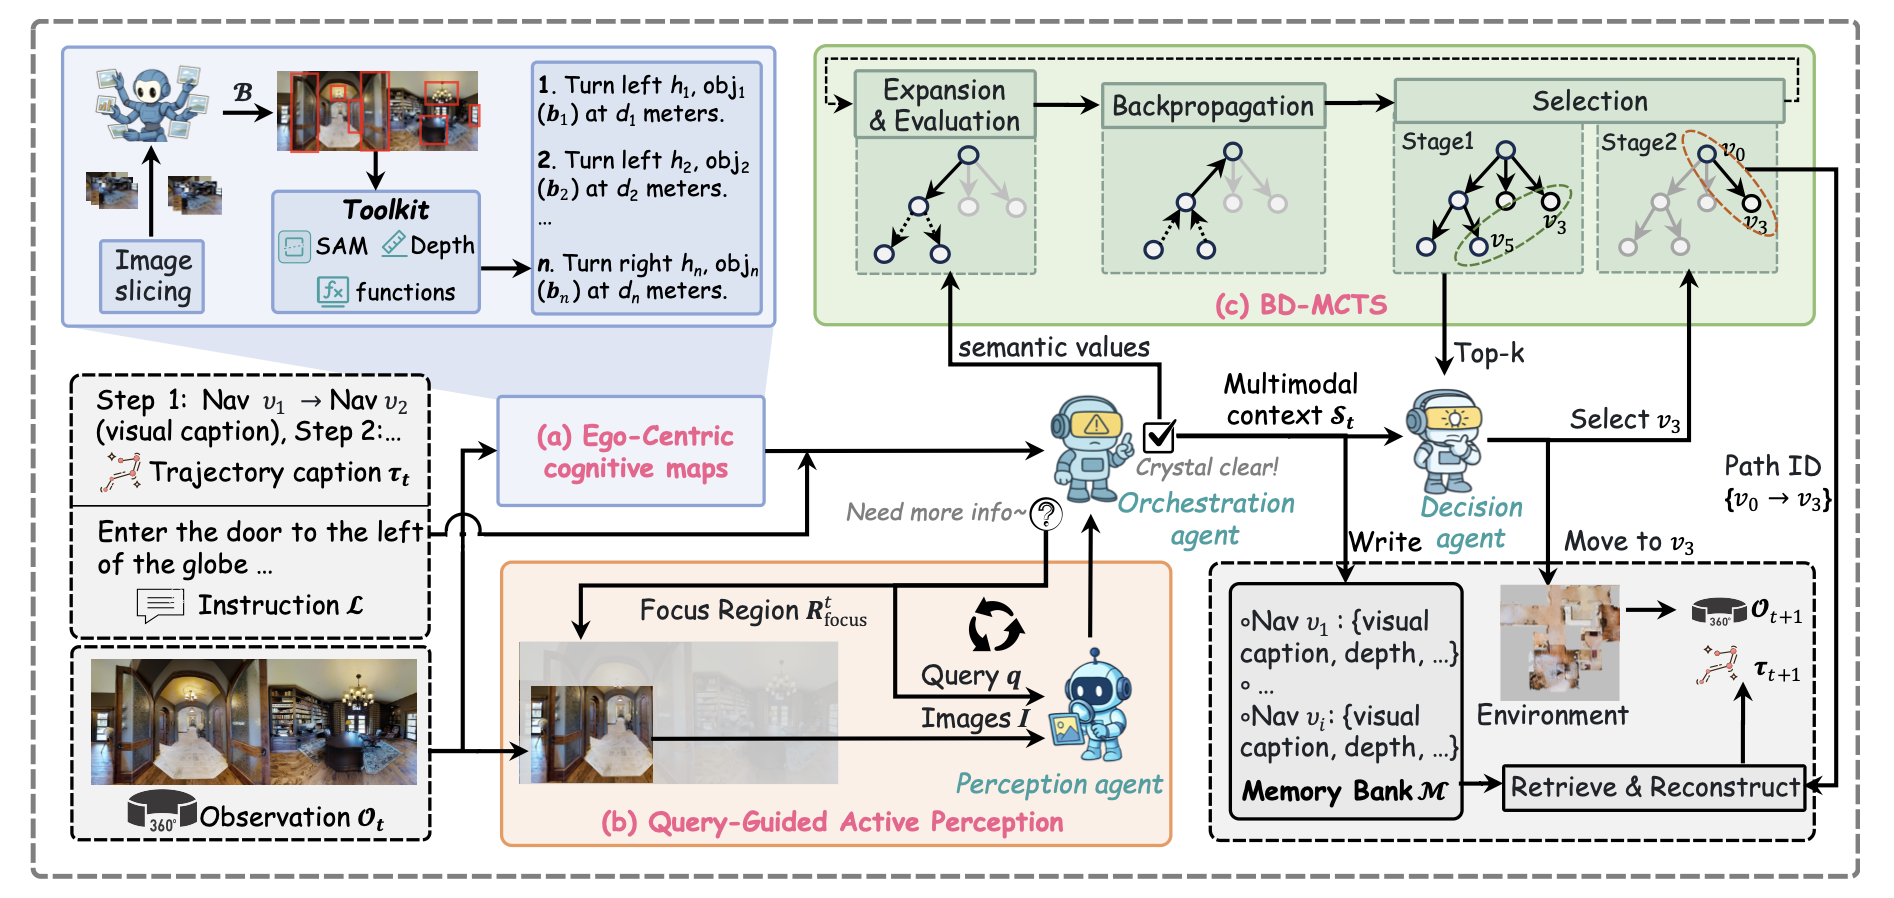
2. Framework · Proactive Perception + Focused Reasoning
先用自我中心语义地图(Ego-Centric Semantic Map) 组织当前全景中的物体与空间关系,再根据推理需要主动查询局部细节;随后用 Branch-Diverse Monte Carlo Tree Search(BD-MCTS) 从全局历史候选中筛选 top-k 个高价值航点,让决策模型集中分析这些候选的相关上下文。
Figure 1 · ProFocus 整体框架 图片暂未加载,请通过图片链接查看。
执行闭环 全景 → 自我中心语义地图 → 提问、裁剪、回答与充分性检查 → 新航点语义估值 → BD-MCTS 回传与候选筛选 → 检索相关历史 → 决策并移动 → 写入记忆、重建轨迹描述 → 下一轮观察。
3. Ego-Centric Semantic Map · 把全景变成可查询的空间描述
切分并扫描全景: 将全景划分成视野相互重叠的方向图像,由 VLM 并行检测物体,得到类别和边界框。补充距离与朝向: SAM2 提供物体掩码,Depth Pro 进行单目深度估计;再根据图像中的横向位置计算物体相对智能体的方位。整理成结构化文本: 每个物体关联“方向、类别、边界框、距离”,形成类似“向左转一定角度,可见某物体,其距离为若干米”的描述。这一步为全景建立对象索引。例如,指令要求“进入地球仪左边的门”,地图先告诉模型地球仪和周围门的位置,后续感知就能集中查验相关区域。
4. Query-Guided Active Perception · 由推理决定还需要看什么
提出问题并指定区域: LLM 读取语义地图、指令、轨迹描述和本轮已有问答,判断当前决策还缺哪些细节,同时输出视觉问题与关注区域。裁剪后回答: 感知 VLM 只分析当前全景中被选中的区域,返回相关的颜色、纹理、物体属性或空间关系。检查信息是否充分: 编排 LLM 判断为 sufficient 或 insufficient;不足时继续提出问题和区域,已有问答被保留以减少重复查询。为新航点评估语义价值: 信息充分后,编排 LLM 综合指令、已走过的轨迹与感知回答,为新发现的可导航 waypoint 赋予 0–1 的相关分数。主动感知体现在按决策需求选择图像区域、提出具体问题,并用回答修正后续判断。
5. BD-MCTS · 怎样筛出值得重点推理的航点
导航过程中维护一棵全局搜索树,节点对应已发现的物理 waypoint ,其中也包括尚未实际到达的新候选。每个节点保存估计价值与回传统计;扩展时把新航点接到当前位置之下,并跳过跨分支连接以保持树无环。这里的价值表示建立在航点和路径上。
Expansion & Evaluation · 用语义值初始化: 当前发现的新候选以主动感知得到的 0–1 语义分数初始化价值,统计计数置零。Backpropagation · 让新证据改变路径价值: 把新候选语义值的平均值作为本轮反馈;没有新候选时使用当前节点价值。反馈沿“根节点 → 当前位置”的路径回传,递增统计计数并按累计平均更新节点价值,其他分支本轮不更新。Stage 1 · 评分并粗筛 top-k: 对全局树的叶节点,按访问统计加权聚合根到叶路径上的价值,再减去从当前位置到该候选的归一化图距离惩罚。按综合分数筛选时,限制同一个父节点最多贡献两个子节点 ,减少候选集中在相近分支上的情况。Stage 2 · 由 LLM 最终选择: 决策代理读取筛出的候选、候选对应的历史上下文以及当前证据,选出下一目标航点。两阶段分别承担搜索筛选 和上下文推理 :BD-MCTS 缩小候选范围,最终决定由决策 LLM 作出。
6. Memory Bank · 如何取回相关历史并纠正路线
保存什么: 每一步记录指令、当时的轨迹描述、自我中心语义地图,以及主动感知得到的文本回答。由多模态观测整理写入 Memory Bank。
如何检索: 对每个入选候选,沿搜索树的“根 → 候选”路径,用 waypoint ID 索引相关历史。模型据此判断这条路线是否符合当前指令阶段。
评测基座 两组配置:Qwen3-Max(编排/决策)+Qwen3-VL-Max(感知);DeepSeek-V3(编排/决策)+GLM-4.5V(感知)。 实验数据 R2R 与 REVERIE 的 val-unseen 导航评测。本文及重实现基线使用随机抽样的验证子集,所给论文未注明主评测子集数量;REVERIE 只评估抵达目标位置,未评估对象 grounding。另对 R2R 最长的 30 条 episode 进行长轨迹分析。 外部组件与执行 预训练 VLM 检测物体框、SAM2 提取物体掩码、Depth Pro 估计单目距离,再结合方向换算、导航图、BD-MCTS 和按航点 ID 的记忆检索完成决策。导航在离散 waypoint 图上进行,各基础模型无需 VLN 专用微调。 本篇结果: R2R / Qwen3-Max+Qwen3-VL-Max · REVERIE / Qwen3-Max+Qwen3-VL-Max
回到实验总表 ↑ 回到论文目录 ↑
16 SysNav Agent Framework Lidar
SysNav: Multi-Level Systematic Cooperation Enables Real-World, Cross-Embodiment Object Navigation
2026.03 首次预印本原论文 ↗ · 官方代码 ↗
1. 需要解决的问题
真实世界的找物导航,需要同时解决“目标可能在哪个房间”“这个房间怎样搜全”和“机器人如何稳定走过去”。 不同问题依赖不同能力:VLM 擅长语义和常识判断,几何规划负责覆盖与可达性,运动控制还要适应轮式、四足和人形机器人的差异。
决策尺度不合适: VLM 频繁选择房间内的waypoint,容易造成重复探索和回溯。房间类型与物体分布的语义关联,更适合作为高层决策依据。目标带有额外约束: “找椅子”与“找卧室里的白色椅子”需要不同的验证过程。系统保存类别、属性、房间归属和物体关系,并找对应证据。不同本体的执行方式不同: 同一条导航路线在轮式、四足和人形机器人上,需要对应的运动控制,并完成避障。2. Framework · 三层分工,以房间为语义规划单元
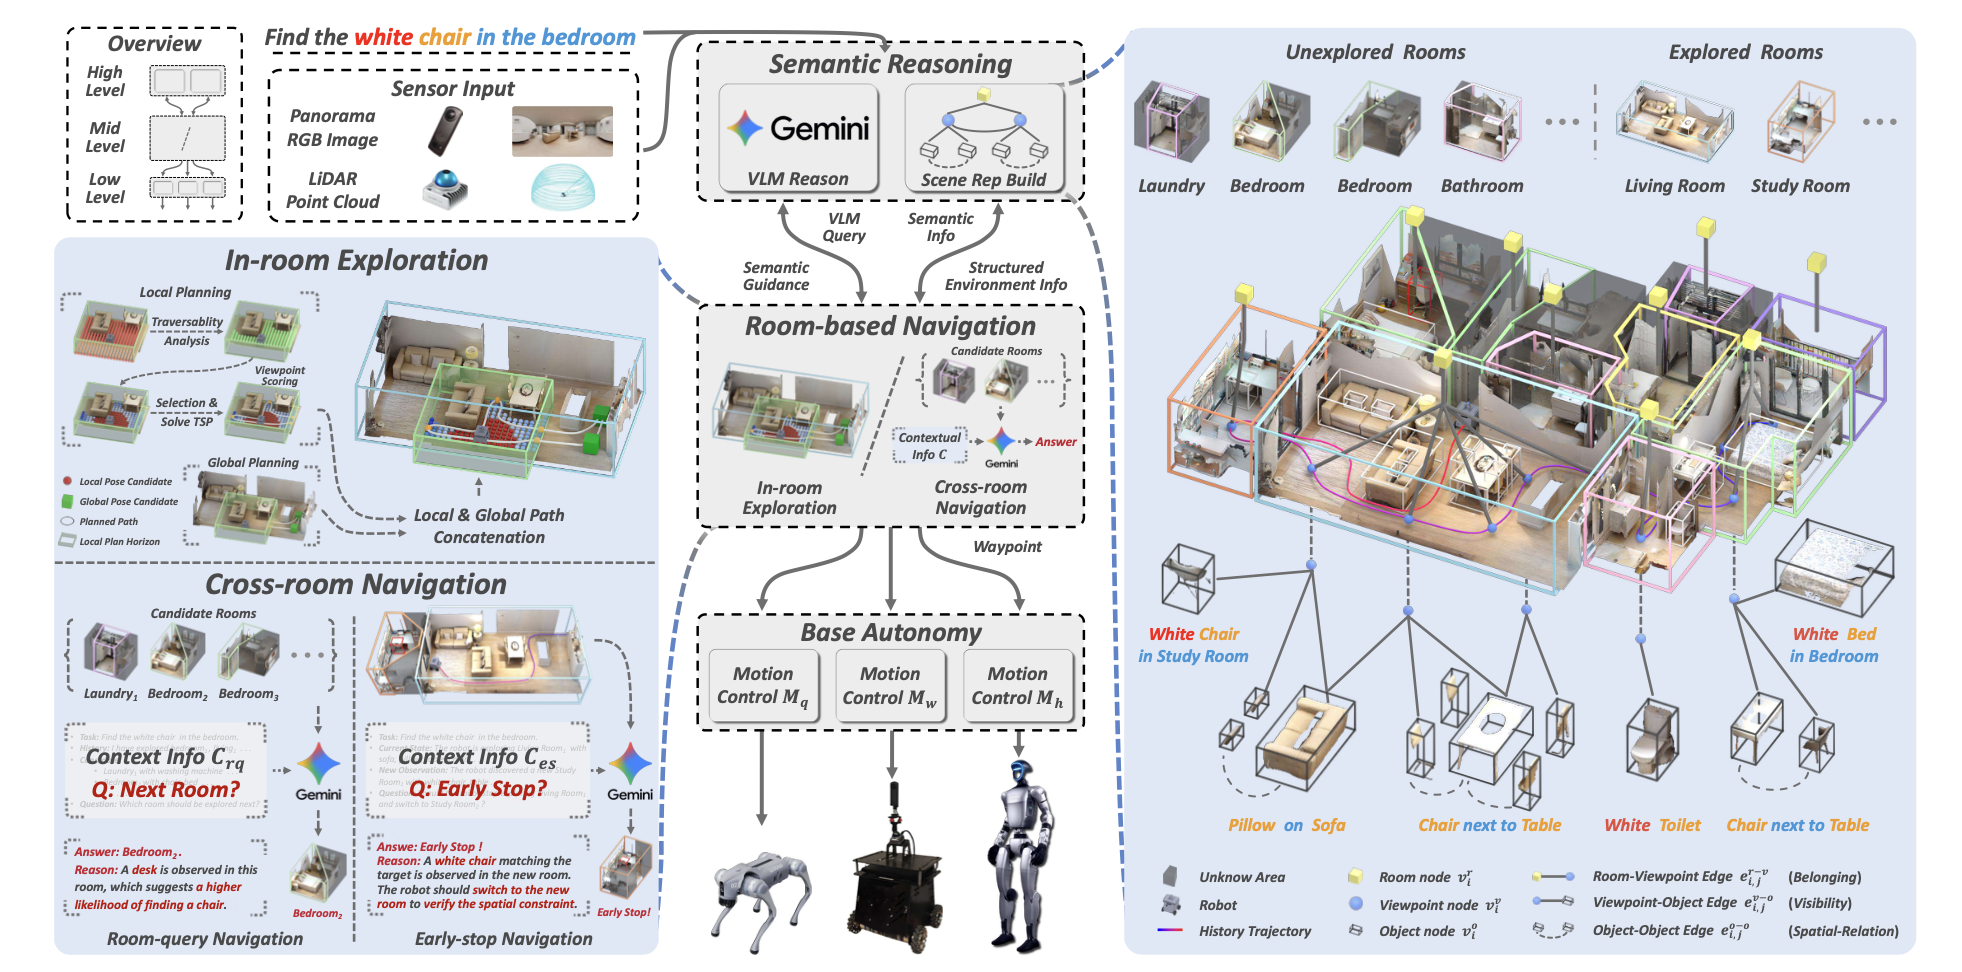
Figure 2 · Semantic Reasoning、Room-based Navigation 与 Base Autonomy 图片暂未加载,请通过图片链接查看。
High-level · 语义推理 构建房间—视点—物体三层场景表示,利用 Gemini 判断目标约束,并为跨房间搜索提供语义指导。 Mid-level · 房间导航 以房间作为 VLM 的最小语义规划单元:房内采用经典覆盖规划;跨房间时结合任务、房间信息与探索历史决定下一步。 Low-level · 运动执行 接收规划航点,通过各机器人对应的运动控制模块完成跟踪、避障与地形可通行性检查。 执行流程 全景 RGB/点云更新场景图 → 在当前房间内规划覆盖路径 → 发现新房间时判断是否提前切换,当前房间搜完时查询下一房间 → 输出航点并执行 → 新观察继续更新;发现候选目标后核验类别、属性与空间约束。
3. Scene Representation · LiDAR 与图像怎样组成场景图
点云提供几何结构,图像提供语义与可复查的视觉证据。 使用全景 RGB、LiDAR 和位姿建立三层场景图,记录房间边界、代表视点和物体实例。
维护关系:房间—房间 :门口连通,房间—视点 :视点归属,房间—物体 :物体所在房间,视点—物体 :哪里看见物体,物体—物体 :要求的空间关系。
属性和物体关系采用按需推理 :
检查自身属性: 任务要求“白色椅子”时,先按类别检索椅子节点,再把对应 RGB 图像交给 VLM 判断颜色,并将结果追加到节点。检查物体关系: 任务要求“桌子上的杯子”时,找到同时看见杯子和桌子的历史视点,使用视点的 RGB 图像判断关系,添加物体—物体边。检查房间归属: 结合房间类型和物体归属关系,判断候选是否处在要求的房间。例如发现书房里的白椅子,仍需核验它是否满足“卧室里”。4. In-room Exploration · 怎样高效搜完一个房间
房内探索采用局部与全局两级覆盖规划 。它评估的是候选位置能够新增观察多少空间表面,并据此安排访问路线。
采样与过滤: 在局部规划窗口内生成候选位姿,保留可通行的候选。这里的规划候选与场景图中已访问的 Viewpoint Node 承担不同角色。计算覆盖收益: 将自由空间与障碍/未知空间的边界作为待观察表面;候选能够覆盖的表面点,需要位于覆盖距离内且从该位姿可见。得分为其中尚未被覆盖的点数。抽样选点并求解路径: 按覆盖得分引导随机抽样,每选一个候选就更新未覆盖集合,直到剩余候选得分均低于阈值。对选出的候选求解旅行商问题(TSP),得到局部访问路径;重复这一过程,保留代价最低的路径。衔接局部与全局路径: 随着窗口滚动,将已选中但移出局部窗口的候选转入全局规划范围,再通过 TSP 生成全局路径,转成航点执行。5. Cross-room Navigation · 什么时候向 VLM 查询
跨房间决策由两类事件触发,VLM 根据当时的上下文判断哪个房间值得继续探索。
6. Base Autonomy · 怎样适配轮式、四足与人形机器人
中层输出统一的 waypoint,底层根据本体转换为运动命令,并完成航点跟踪、碰撞避免和地形可通行性分析。SysNav 将上层语义与规划模块复用于不同平台,Go2 与 G1 的运动执行使用各自内置的 locomotion policy。
真机与仿真使用不同的传感配置。 三个真机平台均安装 Livox Mid-360 LiDAR 和 Ricoh Theta Z1 全景相机,Go2/G1 还使用自带 LiDAR 辅助运动控制。Habitat 仿真使用 640×480 RGB-D 和位姿,将深度转换为点云后输入系统。
评测基座 Gemini-2.5-Flash 负责语义推理;YOLOv8xworldv2 负责开放词汇物体检测,SAM2.1_hiera_b+ 负责分割。 实验数据 仿真共 8,195 个 episode:HM3D-v1 2,000 条、HM3D-v2 1,000 条、MP3D 2,195 条,以及 HM3D-OVON val-unseen 3,000 条。真机共 190 次,其中 112 次定量比较均在轮式平台上进行,另外 78 次为包含轮式、四足、人形及建筑尺度案例的定性测试。 外部组件与执行 几何分房、实例点云融合、覆盖采样、TSP 和 Base Autonomy 共同支撑导航;语义导航采用零样本设定,底层复用本体运动能力。仿真报告 SR/SPL;真机比较报告 SR、时间惩罚成功率 SPT 和成功任务的平均耗时 AT。 官方代码 已公开,包含语义建图、VLM 节点、探索规划与底层导航等模块,并提供轮式、Go2 和 G1 平台的运行说明。
本篇结果: HM3D-v1 ObjectNav / Gemini-2.5-Flash;YOLOv8xworldv2 + SAM2.1_hiera_b+ · HM3D-v2 ObjectNav / Gemini-2.5-Flash;YOLOv8xworldv2 + SAM2.1_hiera_b+ · MP3D ObjectNav / Gemini-2.5-Flash;YOLOv8xworldv2 + SAM2.1_hiera_b+ · HM3D-OVON / Gemini-2.5-Flash;YOLOv8xworldv2 + SAM2.1_hiera_b+
回到实验总表 ↑ 回到论文目录 ↑
17 AgentVLN Agent Framework Tool Create Waypoint prediction
AgentVLN: Towards Agentic Vision-and-Language Navigation
2026.03 首次预印本原论文 ↗ · 官方代码 ↗
1. 需要解决的问题
VLM 能理解图像中的地标与语言指令,但把“往那里走”准确变成三维空间中的运动,仍然存在表示和尺度上的差距。 AgentVLN 希望让模型在熟悉的图像空间做语义选择,再通过感知与规划技能完成几何计算和运动执行。
二维语义与三维路径不对齐: 底层生成的是三维轨迹,VLM 处理的是二维图像,需要明确说明地图中的可行路径对应画面中的哪个位置。长距离执行容易积累误差: 遮挡、盲区或偏航会让当前可行路径与指令失去对应,需要结合近期历史进行短距离探索和纠偏。目标定位存在尺度歧义: 对于“沙发后面”等空间描述,单张 RGB 难以提供可靠的距离与深度信息,模型需要按需获取几何证据。2. Framework · VLM-as-Brain 与可调用技能库
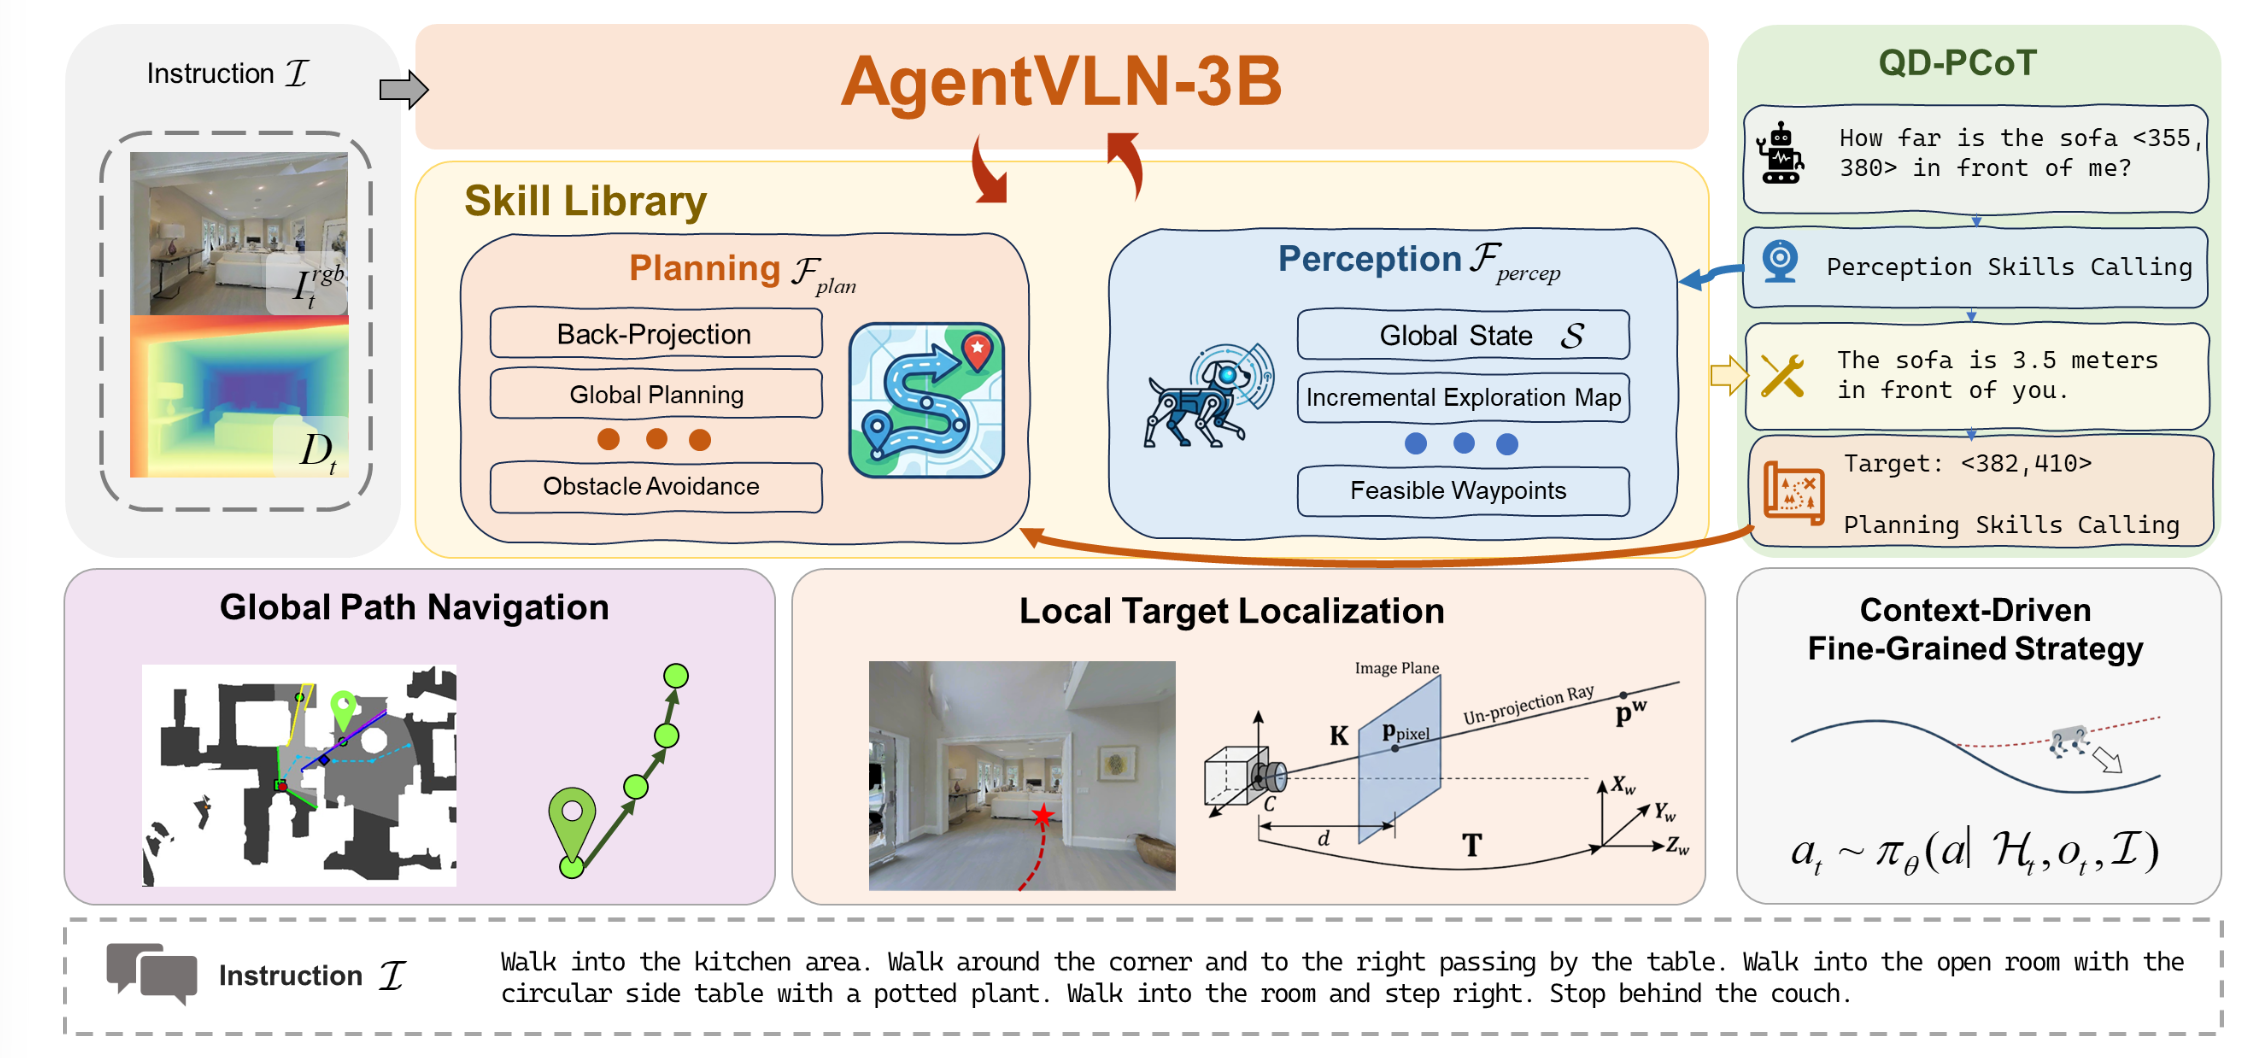
Figure 2 · 技能调用、全局路径导航与局部目标定位 图片暂未加载,请通过图片链接查看。
AgentVLN-3B 以经过指令微调的 Qwen2.5-VL-3B 作为控制中心,根据导航指令、当前观察和近期历史,决定查询什么信息、选择哪个目标以及调用哪项技能。工具由预先实现、可替换和扩展的技能函数组成,模型学习的是调用时机与参数。
因此,论文用部分可观测半马尔可夫决策过程(POSMDP) 描述系统:高层一次决策选择技能,技能执行时长可以变化;感知查询与跨多个时间步的运动执行共同组成导航过程。
执行流程 指令+当前观察+历史 → 感知技能结合 RGB-D 与位姿更新地图并投影可行航点 → VLM 选择路径、查询信息或输出短动作 → 调用规划技能执行 → 更新观察;目标出现后,按需查询几何信息 → 预测目标像素 → 反投影为三维目标并到达。
3. Global Path Navigation · Waypoint 如何与图像对齐
全局导航采用三维几何候选 → 二维视觉提示 → 语义选择 → 三维执行 的映射,让 VLM 能直接把指令中的门、走廊或转弯方向与可行路线对应。
反投影建图: 读取 RGB-D、相机内参和当前位姿,将有效深度像素还原为相机坐标中的三维点,再转换到世界坐标,增量更新占据栅格地图。产生可行候选: 底层几何与规划模块根据地图提供三维路径点,使候选具有几何与可达性依据。投影回当前图像: 用当前相机位姿的逆变换和透视投影,将这些三维点映射到 RGB 图像,形成像素对齐的路径提示。VLM 做语义选择: 结合指令、当前观察和历史,在图像空间选择匹配的路径点;绿色点表示提示,红圈表示模型选择或预测的航点。恢复三维并执行: 将选择对应回世界空间目标,调用规划技能完成路径生成和多步运动;技能结束后用新的观察继续决策。全局阶段的重点是选择已有几何候选,局部阶段则进一步预测目的地像素。 两种输出都通过几何映射接入底层导航。
4. Context-driven Strategy · 遮挡或偏航后怎样恢复
当当前画面中没有与指令语义相关的有效路径投影 时,模型结合历史上下文与当前观察,输出 Forward、Left 或 Right 动作
进入狭窄通道后暂时看不见有效候选,系统可以先转向或短距离前进,重新观察环境;恢复可行路径提示后,再继续交替调用感知与规划技能。
5. Local Target Localization · QD-PCoT 如何查询后定位
当当前观察与指令中的目的地描述明显匹配时,系统进入局部目标定位。Query-Driven Perceptual Chain-of-Thought(QD-PCoT) 处理此时的尺度与空间歧义:模型先提出缺失信息的问题,通过技能获得证据,再决定目的地像素。
提出查询: 例如框架图中的“前方这个像素位置的沙发离我多远?”。查询由模型结合当前目标和不确定的空间关系生成。调用感知技能: 技能读取深度等几何信息,并以文本形式返回结果,例如“沙发距离约 3.5 米”。这个数值来自感知反馈。将反馈加入上下文: 模型结合新增信息继续推理,必要时进行多轮问答,最终输出与指令一致的目标像素坐标。将像素变成可执行目标: 从深度图读取该像素的深度,利用相机内参反投影到相机坐标,再用当前位姿变换到世界坐标,交给规划技能执行。6. AgentVLN-Instruct · 如何训练技能调用与阶段切换
AgentVLN 使用 Habitat 构建指令微调数据,按目标是否可见 组织从全局导航到局部定位的监督信号:
全局路径阶段: 监督模型调用技能并选择与专家路线对齐的航点,学习如何将指令对应到图像中的可行路径。偏航恢复样本: 向轨迹加入扰动;可视航点缺失时,提供精细动作序列,训练模型恢复观察与路线。局部定位阶段: 构造多轮感知问答与 CoT,监督主动查询、利用工具反馈以及输出目标像素。训练时冻结视觉编码器和多模态投影层,对语言模型部分进行指令微调,并混入 LLaVA-Video-178K 以保留通用多模态能力。技能库承担几何与运动功能,导航决策和调用能力则通过这些数据训练获得。
评测基座 Qwen2.5-VL-3B,经 AgentVLN-Instruct 指令微调。输入观察为 640×480、110° 视场角,历史窗口为 8 帧。 实验数据 R2R-CE 与 RxR-CE 的 Val-Unseen。论文主结果分别为 SR 67.2%/SPL 64.7%,以及 SR 69.5%/SPL 61.3%;另展示 Go2 四足机器人在室内外的导航案例。 外部组件与执行 系统使用深度、相机标定与位姿支持地图和像素—三维映射。真机配置包括 RealSense D455、RTAB-Map、路径规划和机器人控制软件,VLM 在 Jetson 平台本地运行;所提供正文未列出具体推理时延或真机成功率统计。 官方仓库 已公开训练、数据生成与 Habitat 推理/评估代码,开源状态标为“已开源”。
本篇结果: R2R-CE / 微调Qwen2.5-VL-3B · RxR-CE / 微调Qwen2.5-VL-3B
回到实验总表 ↑ 回到论文目录 ↑
18 GSMem: 3D Gaussian Splatting as Persistent Spatial Memory for Zero-Shot Embodied Exploration and Reasoning
2026.03 首次预印本原论文 ↗ · 项目页 ↗
1. 需要解决的问题
过去看过一个地方,不代表之后还能从记忆中找回当时没注意到的细节。 GSMem 关注的是记忆的 post-hoc re-observability(事后可重新观察) :当新的问题出现时,能否利用已有空间记忆,换一个更合适的视角重新检查目标区域。
对象图会遗漏未被识别的内容: 如果建图时漏检或错认了某个物体,后续只查询对象标签就很难找回它。历史照片受拍摄角度限制: 即使保存了相关区域的图片,目标也可能太小、被遮挡或角度不合适,无法支撑细粒度判断。重新走回去看有运动成本: 长时导航中会连续收到新目标,如果每次都需要物理返回已经探索的区域,历史记忆的复用效率就很低。2. Framework · 可检索、可重新渲染的空间记忆
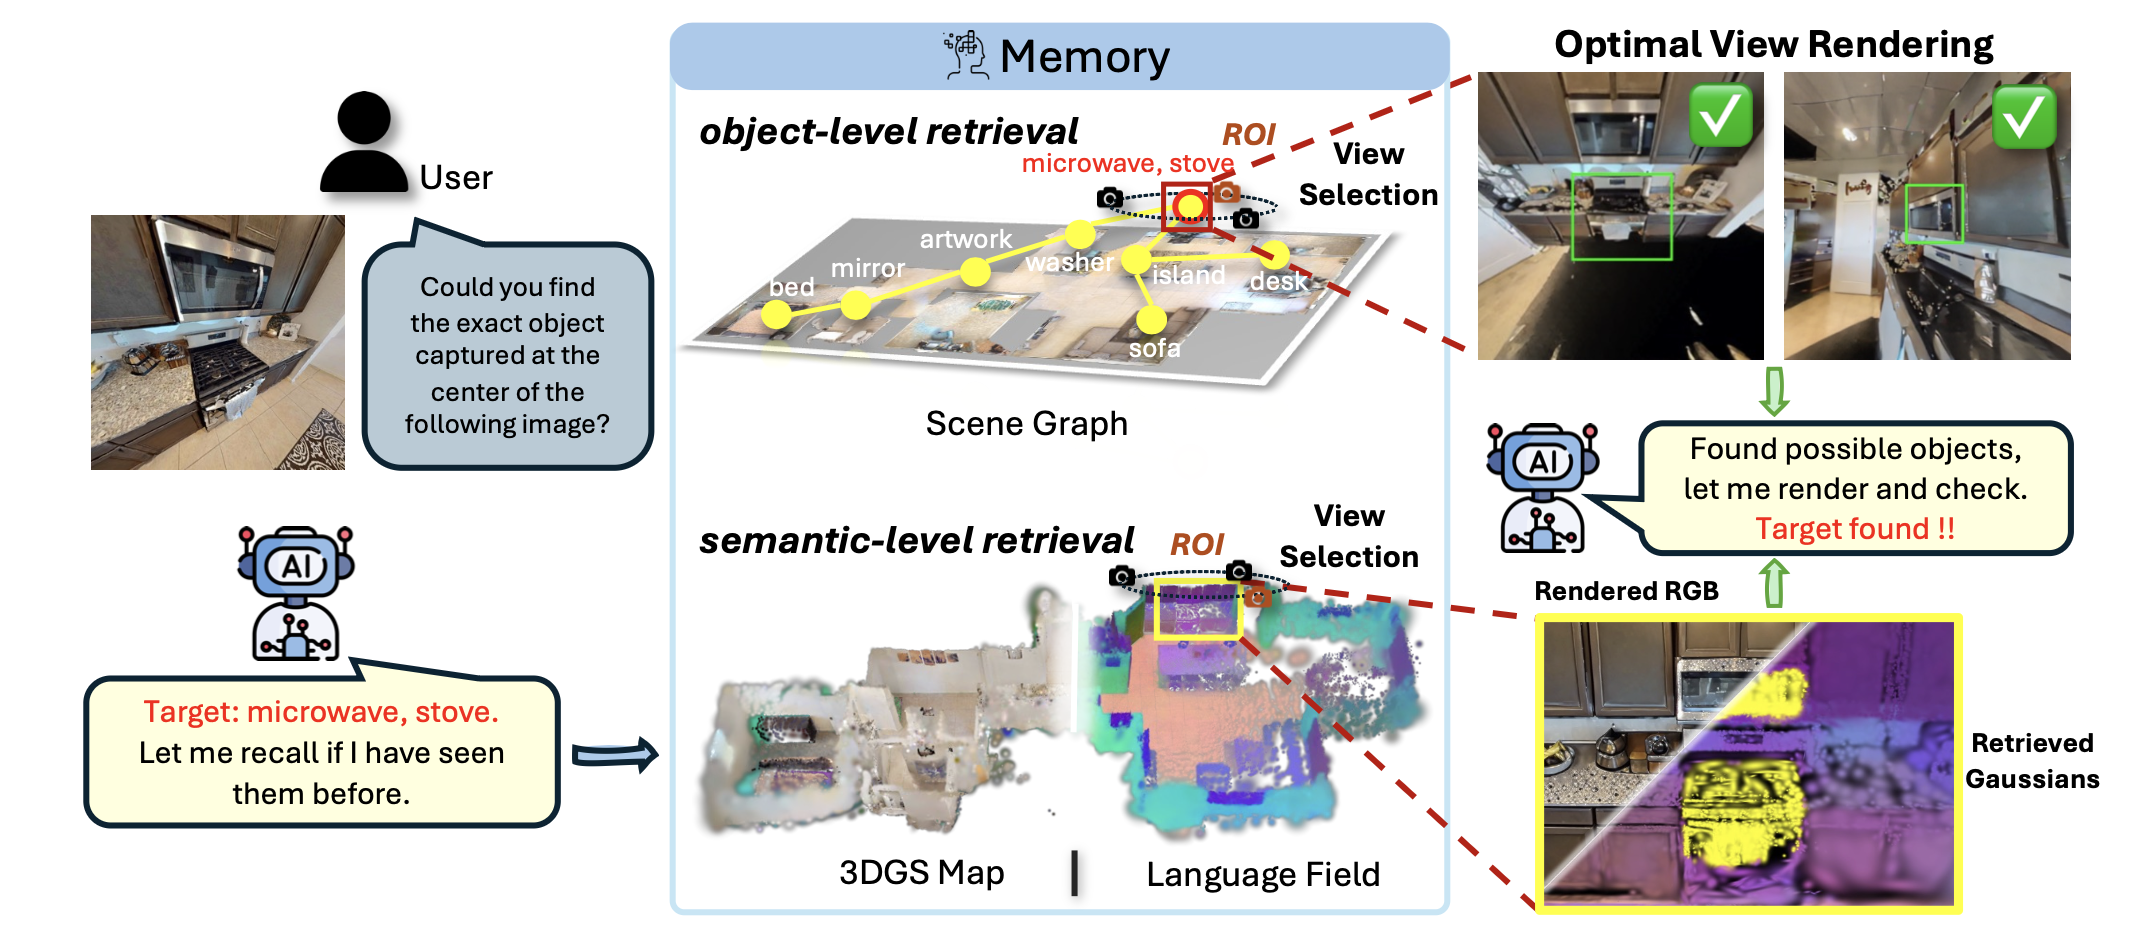
Figure 2 · Multi-level Retrieval-Rendering:两级检索 → 视角选择 → 渲染核验 图片暂未加载,请通过图片链接查看。
GSMem 将探索过的环境保存为持续更新的 3D Gaussian Splatting 空间记忆 ,同时维护对象图和语言特征场。收到问题后,系统先检索可能相关的空间区域,再在地图中选择虚拟相机视角,渲染出适合判断的图像。
执行流程 RGB-D 观测更新记忆 → 对象级/语义级检索 ROI → 选择虚拟视角并渲染 → VLM 核验 → 回答问题或确认导航目标;证据不足则继续探索 → 新观测补充记忆。
3. Memory Building · 如何把观察写入空间记忆
选择关键帧: 采集三个周围方向的 RGB-D 视图,预训练光流网络比较当前帧与上一关键帧;平均光流超过阈值时,当前帧加入关键帧集合。增量优化 3DGS: 使用最近 10 个关键帧组成的滑动窗口,抽取两个历史关键帧。将渲染出的 RGB 和深度与真实观测对齐,更新高斯几何。更新语言特征场: 提取像素级 CLIP 特征,从 768 维压缩到 32 维,再按 RGB-D 渲染时的 alpha blending 权重,将像素特征反向聚合到对应高斯,融合已有特征。同步维护对象与几何结构: 沿用 ConceptGraphs 的检测、匹配和合并流程形成对象图;另维护 frontier map 与 TSDF 地图,为后续区域检索、视角过滤和探索提供支持。4. Multi-level Retrieval · 两路检索怎样找到待检查区域
对象级检索: 每一步将问题与对象图中的物体列表交给 VLM,按语义相关性排序,选出 top-K 对象;每个对象对应一个三维兴趣区域(ROI)
语义级检索: VLM 从任务中提取相关物体或语义实体,编码为 CLIP 文本特征。用这些特征查询语言场,选出余弦相似度超过阈值的高斯。
高相似度的高斯可能分散在多个地方,因此还需要进行空间聚类 :用 KD-Tree 查找一定距离内的邻居、建立邻接图,将连通分量作为候选簇;过滤过小的簇,再按平均语义相似度保留排名靠前的 ROI,两路检索并行提供候选区域。
5. Spatial Recollection · 找到区域后怎样“换个角度再看”
检索只确定看哪里 ,视角选择进一步决定从哪里看才能看清 。这一步在地图中搜索虚拟相机位姿,无需机器人先走到每个候选位置。
围绕 ROI 采样: 以区域的三维包围盒为中心,采样 36 个水平方位角(间隔 10°)和三个俯仰角(−10°、0°、15°),共得到 108 个候选视角。先做几何筛选: 用 TSDF 排除位于障碍内部的相机位置。检查包围盒的 14 个代表点是否可见,评价目标在图像中的投影面积是否接近期望。再检查渲染覆盖: 前一阶段按“可见性+投影尺度”选出 10 个视角,为其渲染不透明度图,计算 ROI 内平均不透明度;最终按“可见性+投影尺度+不透明度”之和选出最佳视角。渲染并核验: 从最佳视角渲染目标区域;对于有对象检测记录的候选,还在其最高置信度检测位姿上重新渲染一张补充图。渲染图经过单步扩散模型增强后,交给 VLM 判断是否获得足够证据。6. Hybrid Exploration · 记忆里证据不足时去哪探索
如果当前记忆无法支持回答或目标确认,系统从占据地图提取已知自由空间与未知区域交界处的 frontier,并为每个候选计算两种分数:
语义相关性: VLM 根据任务与 frontier 的对应观察,判断该方向有多大可能提供有用信息。几何信息增益: 估计新增观察对 3DGS 几何确定性的帮助。论文从熵降低与 Fisher 信息出发,实际采用增量 Fisher 信息矩阵的迹作为高效代理分数,由渲染梯度计算。选择规则是阈值切换 :最高语义评分超过阈值时,选择语义评分最高的 frontier;否则选择几何信息增益最高的 frontier。
评测基座 主实验使用 GPT-4o,结合预训练 CLIP、语义特征压缩模型和单步扩散增强模型;导航与问答决策无需任务专门训练,场景地图持续在线优化。 实验数据 A-EQA 使用 63 个 HM3D 场景中的 184 个问题,LLM-Match 为 55.4,LLM-Match SPL 为 43.8。GOAT-Bench Val-Unseen 包含 36 个场景、360 个 episodes 和超过 2600 个子任务,SR 为 67.2%,SPL 为 46.9%。A-EQA 的效率加权问答评分与导航 SPL 分属不同指标。 外部组件与执行 依赖 RGB-D、相机位姿、3DGS 建图、对象检测与地图更新。论文约 1.2 秒/步的运行时间估计使用了单独配置:RTX 4090 运行导航框架,H100 部署 Qwen3-VL-8B,并去掉单步扩散;该时延对应修改后的多进程配置。 官方仓库 目前仅包含项目展示网页与静态资源,未公开方法实现,开源状态标为“未开源”(2026-10-09 核验)。
本篇结果: A-EQA / GPT-4o · GOAT-Bench / GPT-4o
回到实验总表 ↑ 回到论文目录 ↑
19 Uni-LaViRA Memory Tool Create
Uni-LaViRA: Language-Vision-Robot Actions Translation for Unified Embodied Navigation
2026.05 首次预印本原论文 ↗ · 官方代码 ↗
1. 需要解决的问题
能否把 LaViRA 的 Language–Vision–Robot 三层接口扩展为统一的具身导航系统,并让它在长任务和错误恢复中持续跟踪目标?
不同任务需要共享决策接口: VLN-CE 要按路线指令前进,ObjectNav 要寻找目标物体,EQA 要探索到能够回答问题的位置,Aerial-VLN 还涉及三维飞行。它们都需要理解任务、定位视觉目标,再转换为机器人动作。长指令中的任务进度容易丢失: 近期观察的滑动窗口不能持续提醒模型还有哪些子目标未完成,绕路后容易偏离原任务,也可能早停。回到旧位置后仍可能重复错误: 如果回溯只恢复位置,却没有保留走错的方向和沿途证据,模型下一次可能仍作出相同选择。2. Framework · 三层动作接口 + 任务记忆 + 失败重规划
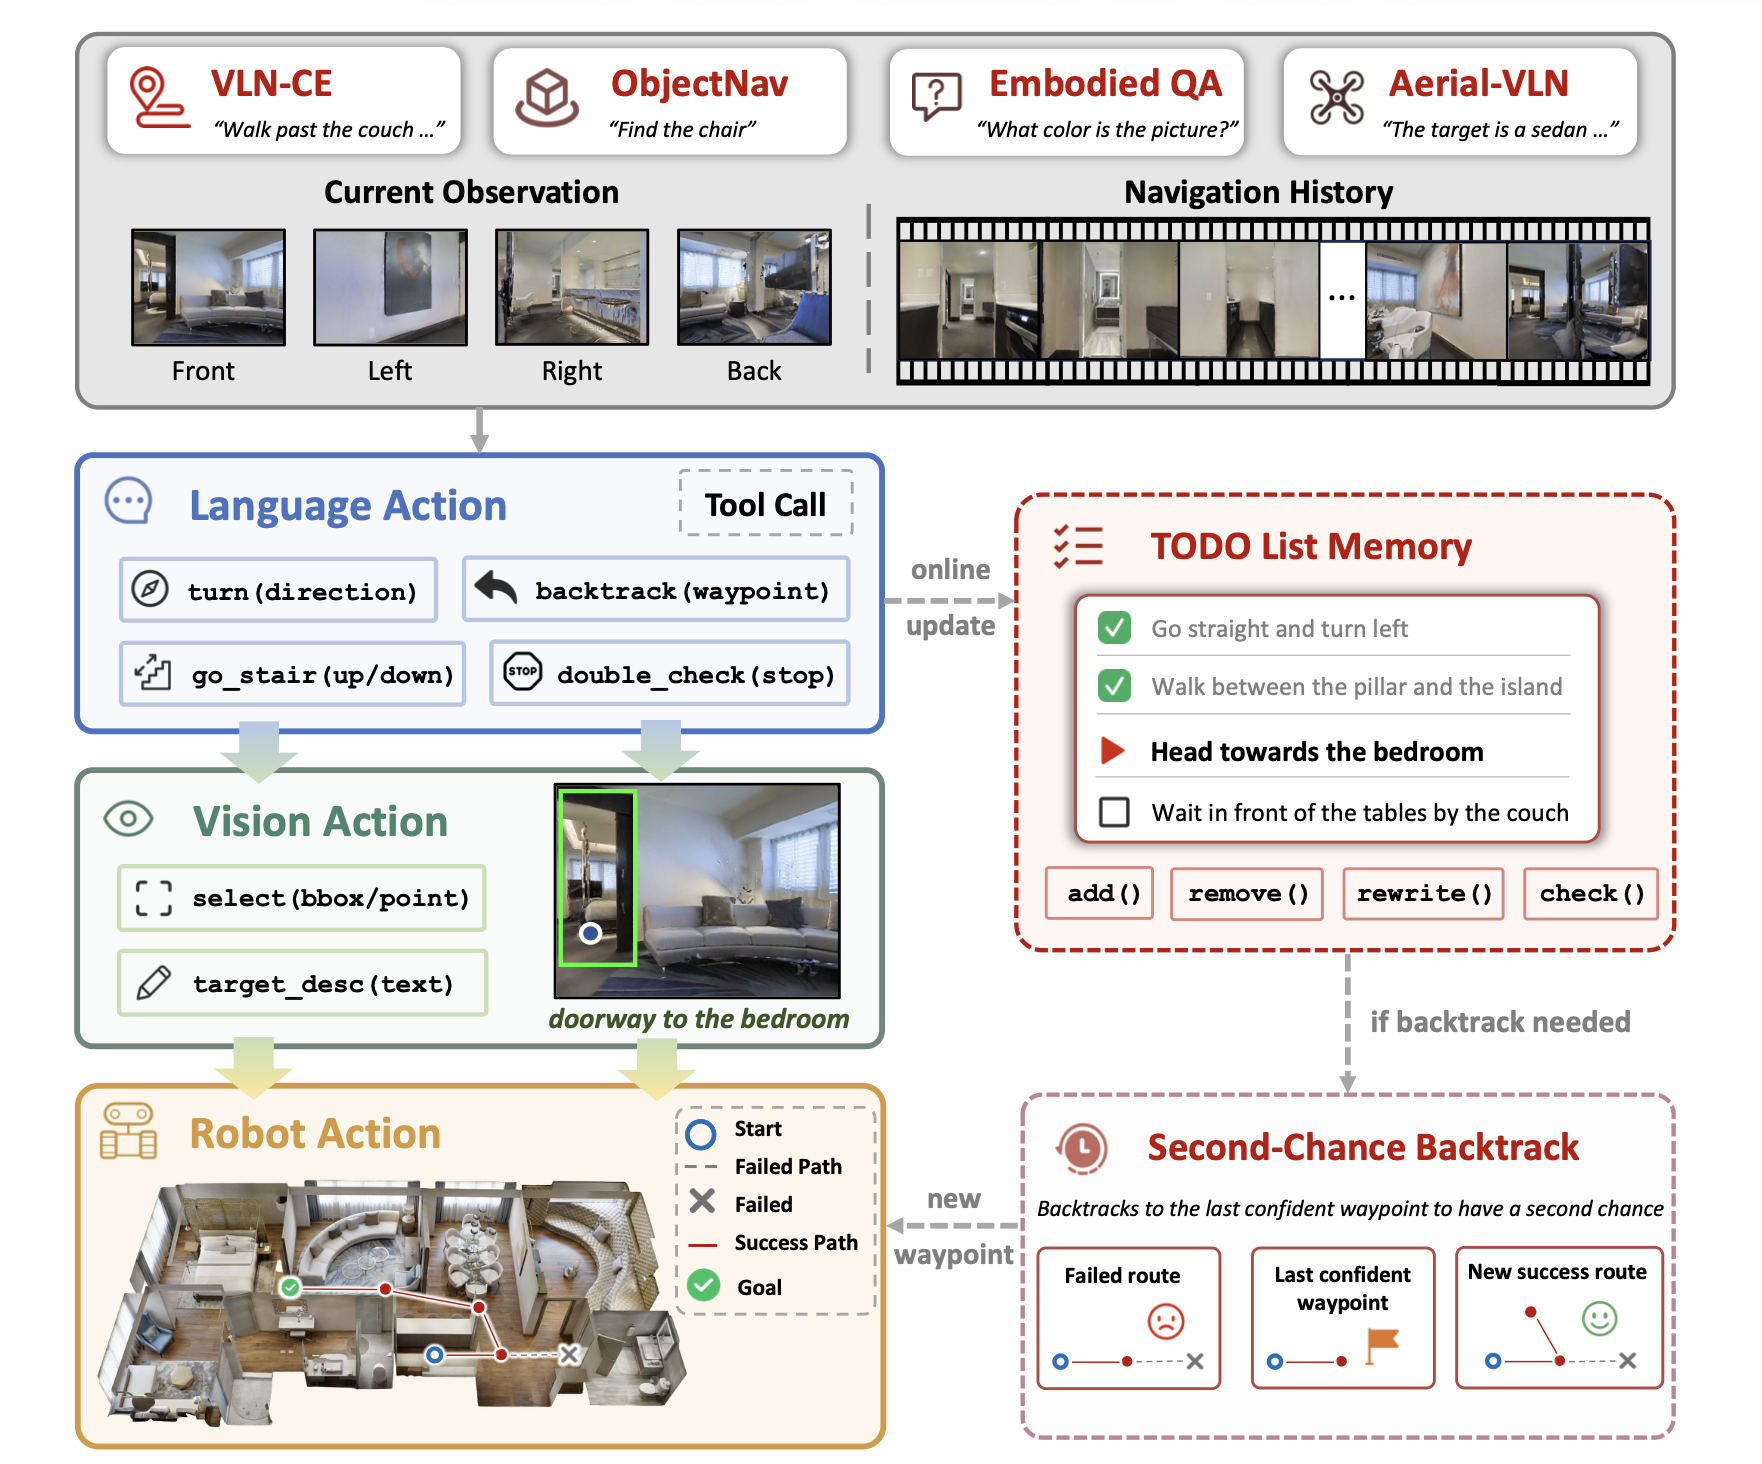
Uni-LaViRA 延续 Language Action → Vision Action → Robot Action :在这条流程中加入 TODO List Memory(TDM) 跟踪未完成子目标,再用 Second-Chance Backtrack(SCB) 支持带失败证据的重新决策。
Figure 2 · Uni-LaViRA 统一导航框架 图片暂未加载,请通过图片链接查看。
Language Action: 读取任务、当前多方向图像、带简短描述的历史航点和沿途 RGB 观察。每轮更新 TODO,再选择一个高层工具;主实验由 Gemini-3.1-Pro 承担。Vision Action: Qwen3.5-27B 读取任务、进度描述和所选方向的单张图像,输出目标框或像素点,以及目标文字描述。框不易定义时可以直接选点,提示同时要求避免过近的目标。Robot Action: 读取目标像素的深度,结合相机内参反投影到三维,再通过位姿转换到世界坐标。仿真地面导航使用二维占据图与 FMM;空中导航使用三维体素图与自由空间中的可见性图规划。执行闭环 任务与初始观察 → 初始化 TODO → 当前观察 + 历史 + TODO → 更新清单并选择工具 → 视觉定位 → 几何投影与执行 → 新观察。选择 backtrack 时进入带失败证据的重规划;候选终点经 double_check 核验后停止。
3. 工具接口 · 模型可以调用哪些动作
4. TODO List Memory · 怎样持续记住还有什么没完成
TDM 保存的是一个有序的子目标清单。 每项包含 content(要完成什么)、status(pending 或 completed)和 result。
初始化: episode 开始时,用任务和初始全景调用一次高层模型,生成全部处于 pending、result 为空的清单。
每轮先更新清单,再选动作: 提示中重新呈现当前 TODO,模型输出更新操作和动作推理,分别写入 reasoning_todo 与 reasoning_action。原文定义四种更新操作:
update(i, status=completed, result=r):将第 i 项标记为完成,并写入支持这一判断的观察。rewrite(i, content=c):细化尚未完成项目的描述。add(content=c, index=j):插入新的子目标;不指定位置时追加到末尾。remove(i):删除已经不再相关的子目标。5. Second-Chance Backtrack · 回来以后怎样避免再走错
SCB 将空间回溯与失败分析连在一起。 每次调用高层模型的位置都会记录为地图航点,存入固定容量的缓冲区。模型根据任务和观察选择 backtrack(waypoint),随后执行以下流程:
返回选中的历史航点: 地面端在当前累积地图上用 FMM 重新规划返回路径,把后来发现的障碍也纳入规划;空中使用三维地图与对应规划器。组织失败证据: 重规划输入包括原任务、返回航点的全景、上次离开该点时选择的方向,以及从该点到失败位置的第一视角图像序列。专门调用高层重新决策: 要求模型分析原方向为什么失败,再从剩余方向中选择新的方向。之后重新调用视觉层定位目标,并恢复执行。同步修正 TODO: 清单在回溯期间保留;重规划可以把失败子目标保持或恢复为 pending,也可以改写描述,使任务进度与恢复行动一致。评测基座 仿真主实验使用 Gemini-3.1-Pro 进行 Language Action 规划,Qwen3.5-27B 进行 Vision Action 定位。真机部署按平台使用本地量化 Qwen3.5 或远程 API。 实验数据 R2R-CE、RxR-CE、HM3D-v2、HM3D-OVON、MP3D-EQA 和 OpenUAV 六个基准,各取 100 条分层子集并运行 3 个独立种子,报告均值与标准差。前五项来自 val-unseen,OpenUAV 使用 UM 未见地图测试集。另在轮式、人形、四足和无人机四类平台展示定性真机导航。 外部组件与执行 RGB-D、相机内参与位姿、在线地图、FMM/三维路径规划与机器人控制器。论文真机地面端采用预训练 NavDP;当前官方 Habitat 实现 还使用 GroundingDINO/SAM 建图,并调用 NavDP 处理楼梯。因此这里的免训练指上层规划与定位无需导航专用微调,系统仍使用已预训练的感知和导航组件。 本篇结果: R2R-CE / Gemini-3.1-Pro+Qwen3.5-27B · RxR-CE / Gemini-3.1-Pro+Qwen3.5-27B
回到实验总表 ↑ 回到论文目录 ↑
20 Bridging the 2D-3D Gap: A Hierarchical Semantic-Geometric Map for Vision Language Navigation
2026.06 首次预印本原论文 ↗ · 官方代码 ↗
1. 需要解决的问题 HSGM 聚焦 VLN 中的语义–几何鸿沟(Semantic–Geometric Gap) :VLM 擅长语言与二维图像理解,但对三维空间布局、跨视角位置关系,以及动作如何改变空间状态的理解仍不稳定。这使得“理解要去哪里”和“可靠地走过去”之间存在断层。
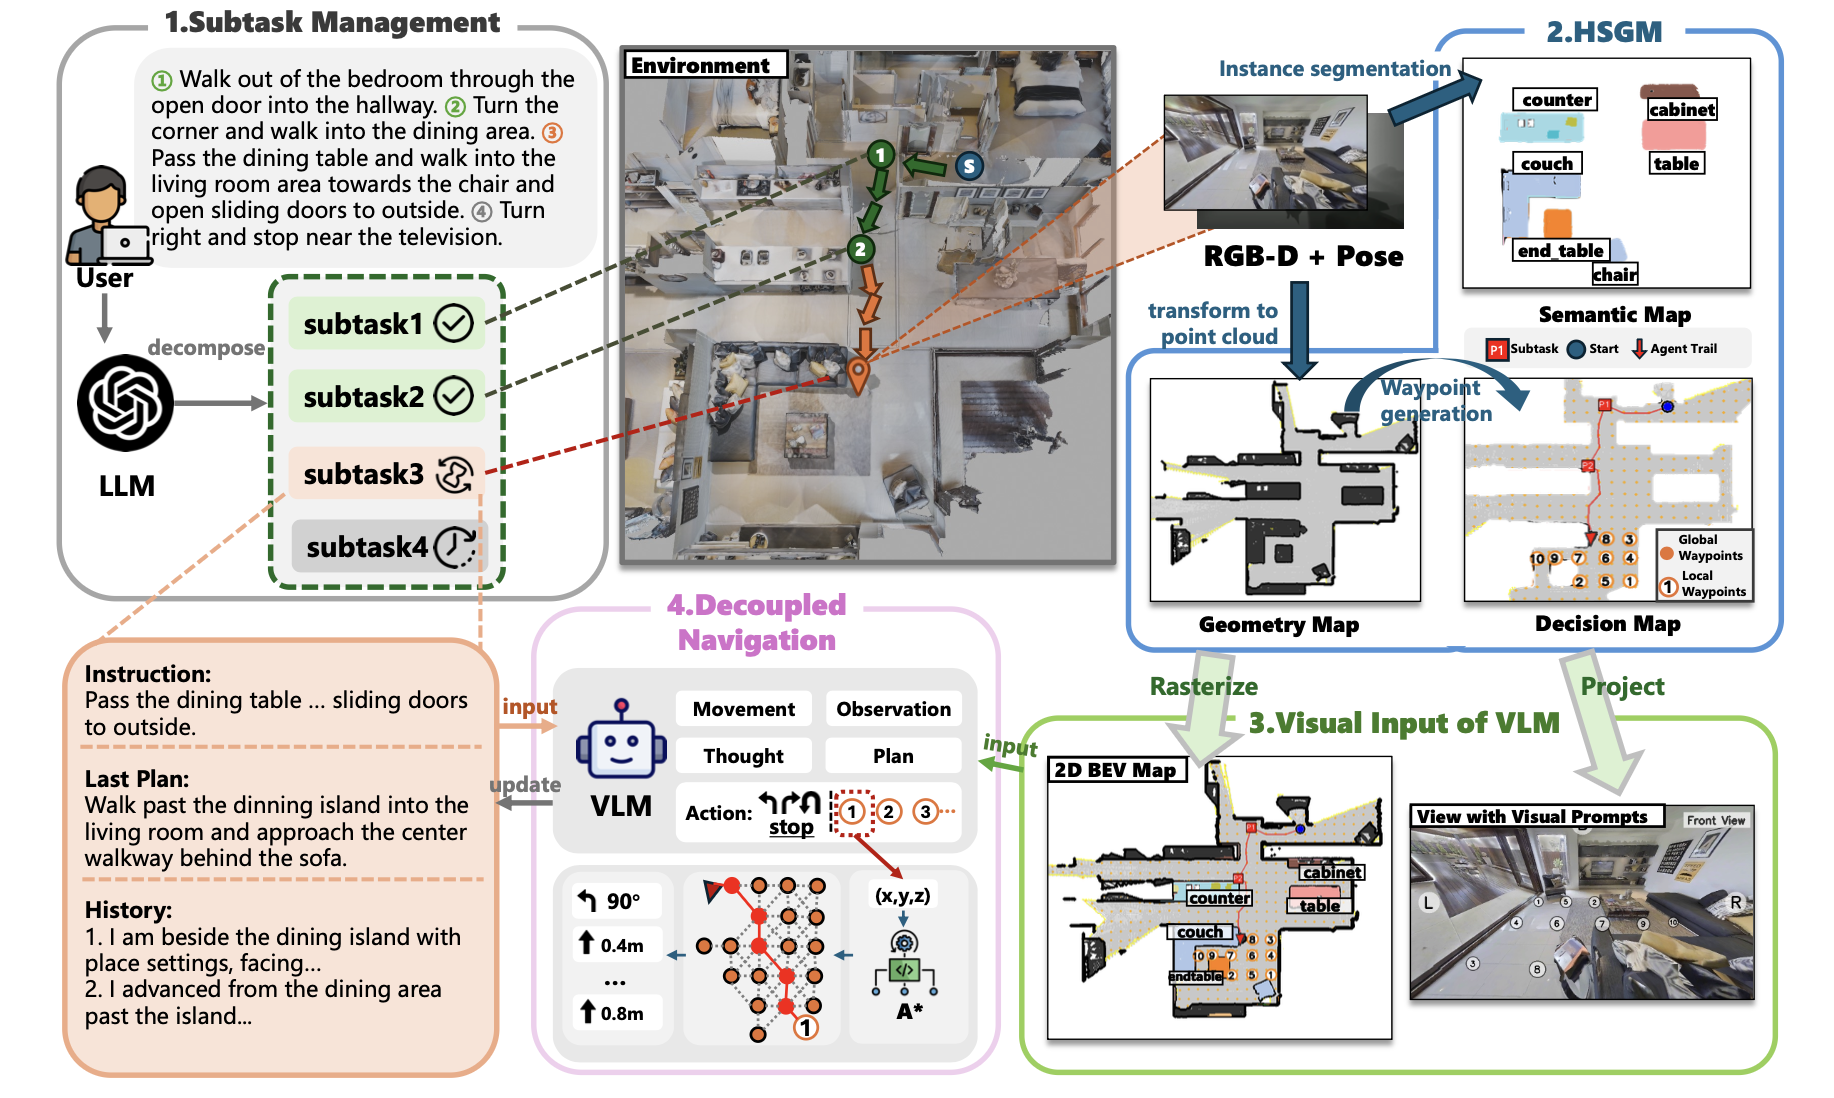
跨视角的空间关系难以保持: 连续导航输入是一串来自不同时间和视角的二维图像。模型可能在单张图中认出桌子与门,却难以把它们放进统一的度量空间,持续判断自己在哪里、经过了哪里,以及“从两件物体之间穿过”对应哪条实际路径。语义意图难以直接变成运动: “绕过沙发到门口”是语义计划,具体转多少、前进多远、机器人能否穿过狭窄通道,还需要几何依据。让 VLM 同时承担这些判断,容易产生不可达目标或碰撞。2. Framework · 三维建图,二维呈现,分层执行 在线维护三维 HSGM,将其整理成 VLM 可读的二维 BEV,再由 VLM 选择经过几何检查的 waypoint,交给 A* 规划并执行。
Figure 2 · HSGM 完整架构 图片暂未加载,请通过图片链接查看。
整体流程 指令分解为有序子任务 → RGB-D/位姿更新三层 HSGM → 生成全局航点图与局部候选 → BEV + 带候选编号的第一视角 → VLM 选择航点、转向或完成当前子任务 → A* 规划与执行 → 新观测更新地图和进度。
3. 三层 HSGM · 每层到底保存什么
三层共享同一空间基础:几何层提供可通行性,语义层给出物体含义,决策层把环境转换为可选动作。
4. Waypoint Generation · 候选点具体怎么采样 先区分全局图和局部候选。 全局图覆盖已建模的可通行空间,用于连接路径;局部候选来自当前视野内的可通行点云,是本轮给 VLM 的离散选项。候选数量由几何采样与过滤结果决定。
全局航点图: 对点云去噪、体素降采样,再用机器人圆柱占用模型检查候选位置是否与障碍相交。通过检查的点成为图节点;两点的欧氏距离不超过 1.0 m 、高度差不超过 0.3 m 时,进一步沿连线插值检查可通行性与碰撞,合格后连边。图表达“机器人能站在哪里”和“哪些位置之间能走通”。
局部候选生成(Algorithm 1): 每步对当前视野重新执行以下流程。
取当前可通行点云并去噪: 采样范围是当前视野中已识别的可通行区域,候选需要有观测与几何依据。体素降采样: 用较粗的空间分辨率产生稀疏候选。这一操作控制候选的空间密度,把连续区域整理成便于编号和选择的位置集合。检查机器人能否占据该位置: 以候选为中心放置圆柱体,检查其与障碍点云是否相交。。按距离过滤: 保留距机器人 0.3–3.0 m 、距最近障碍点 0.3–2.0 m 的候选。前一条件控制单次目标距离,后一条件保留一定安全间隔。检查是否存在路径: 在全局航点图上检查位置能否到达候选。点附近没有碰撞,与当前位置连通;最终通过检查的点加入局部候选集合。5. BEV 与视觉标记 · 怎样让 VLM 看懂三维空间 三维 HSGM 被栅格化为以智能体为中心的二维鸟瞰图(BEV) 。几何通道画出障碍和可通行区域;语义通道在物体几何中心标注类别;状态信息叠加当前位置、历史轨迹和已完成子任务的位置。多楼层导航时,BEV 随当前楼层切换。
局部候选被赋予数字编号,并用同一套编号同时标在 BEV 和正面第一视角图上 ;已访问与未访问候选用不同颜色区分。模型可以把眼前的视觉线索与俯视图中的空间布局对应起来。例如,“门口的 3 号点”同时有图像中的外观依据、地图中的相对位置,以及后台保存的三维坐标。
VLM 接收这些视觉输入,以及当前子任务、上一计划和历史轨迹描述。三维地图负责保存度量信息与执行依据,二维视图把空间结构给模型。
6. Decoupled Navigation · VLM 选目标,A* 负责走过去 高层选择: VLM 按 Movement、Observation、Thought、Plan、Action 的结构组织决策,输出一个局部航点编号,或选择左转 90°、右转 90°、掉头 180°,也可以用 STOP 表示当前子任务完成。候选编号在执行端对应具体三维坐标。
低层执行: 选中 waypoint 后,A* 在全局航点图上按节点间欧氏距离搜索路径,再将路径分段转换为转向与前进:先对准下一路径节点,再移动到该节点。VLM 给出语义上的目的地,几何图和控制器完成中间运动。路径跟随阶段继续感知与更新地图,高层决策时才查询 VLM。
子任务推进与恢复: 开始时由同一基座模型把长指令拆成有序子任务,每个子任务要求有明确终止状态,且不超过三条运动指令。进度管理器记录 pending、in progress、done;普通子任务收到 STOP 后推进下一项,最后一项需要连续两次 STOP 确认。
评测基座 GPT-5 承担指令分解与高层视觉规划;YOLO-E 提供物体实例分割。 实验数据 Habitat/Matterport3D 上的 R2R-CE 完整 val-unseen,以及 RxR-CE val-unseen 随机抽取的 500 条英语 episode;消融使用 R2R-CE 的 300 条子集。 外部组件与执行 RGB-D 与位姿、三维点云建图、实例融合、体素降采样、圆柱碰撞检查、图连通性检查、BEV 栅格化及 A* 路径规划。框架无需额外导航训练,依赖预训练 VLM 与视觉模型。 本篇结果: R2R-CE / GPT-5 + YOLO-E · RxR-CE / GPT-5 + YOLO-E
回到实验总表 ↑ 回到论文目录 ↑
21 SpaceVLN Agent Framework Memory CoN
SpaceVLN: A Zero-Shot Vision-and-Language Navigation Agent with Online Spatial Cognitive Memory and Reasoning
2026.06 首次预印本原论文 ↗ · 项目页 ↗
1. 需要解决的问题
Agent 没有持续维护一个“我现在在哪、已经过哪些空间、这些空间如何连接、当前任务进行到哪一步”的空间认知状态。 单步视觉理解和按时间排列的历史记录,难以把跨房间、走廊与楼层的导航经历组织成稳定的空间关系,长任务中容易迷失位置或判断错进度。
历史有顺序,但缺少空间结构: 需要把观察关联到具体区域、地标和已走过的路径,区分“曾经看到”“已经到达”和“当前可以通行”。任务进度缺少可核验的空间锚点: “离开卧室 → 穿过走廊 → 进入浴室”不仅是文字步骤,还需要用当前位置和地标证据判断每一步是否完成。未知环境中需要边走边建、边执行边修正: 预先构建的场景图需要额外探索;一次生成完整路线又难以适应新观察、局部受阻和执行偏差。2. Framework · 空间记忆支撑任务进度推理
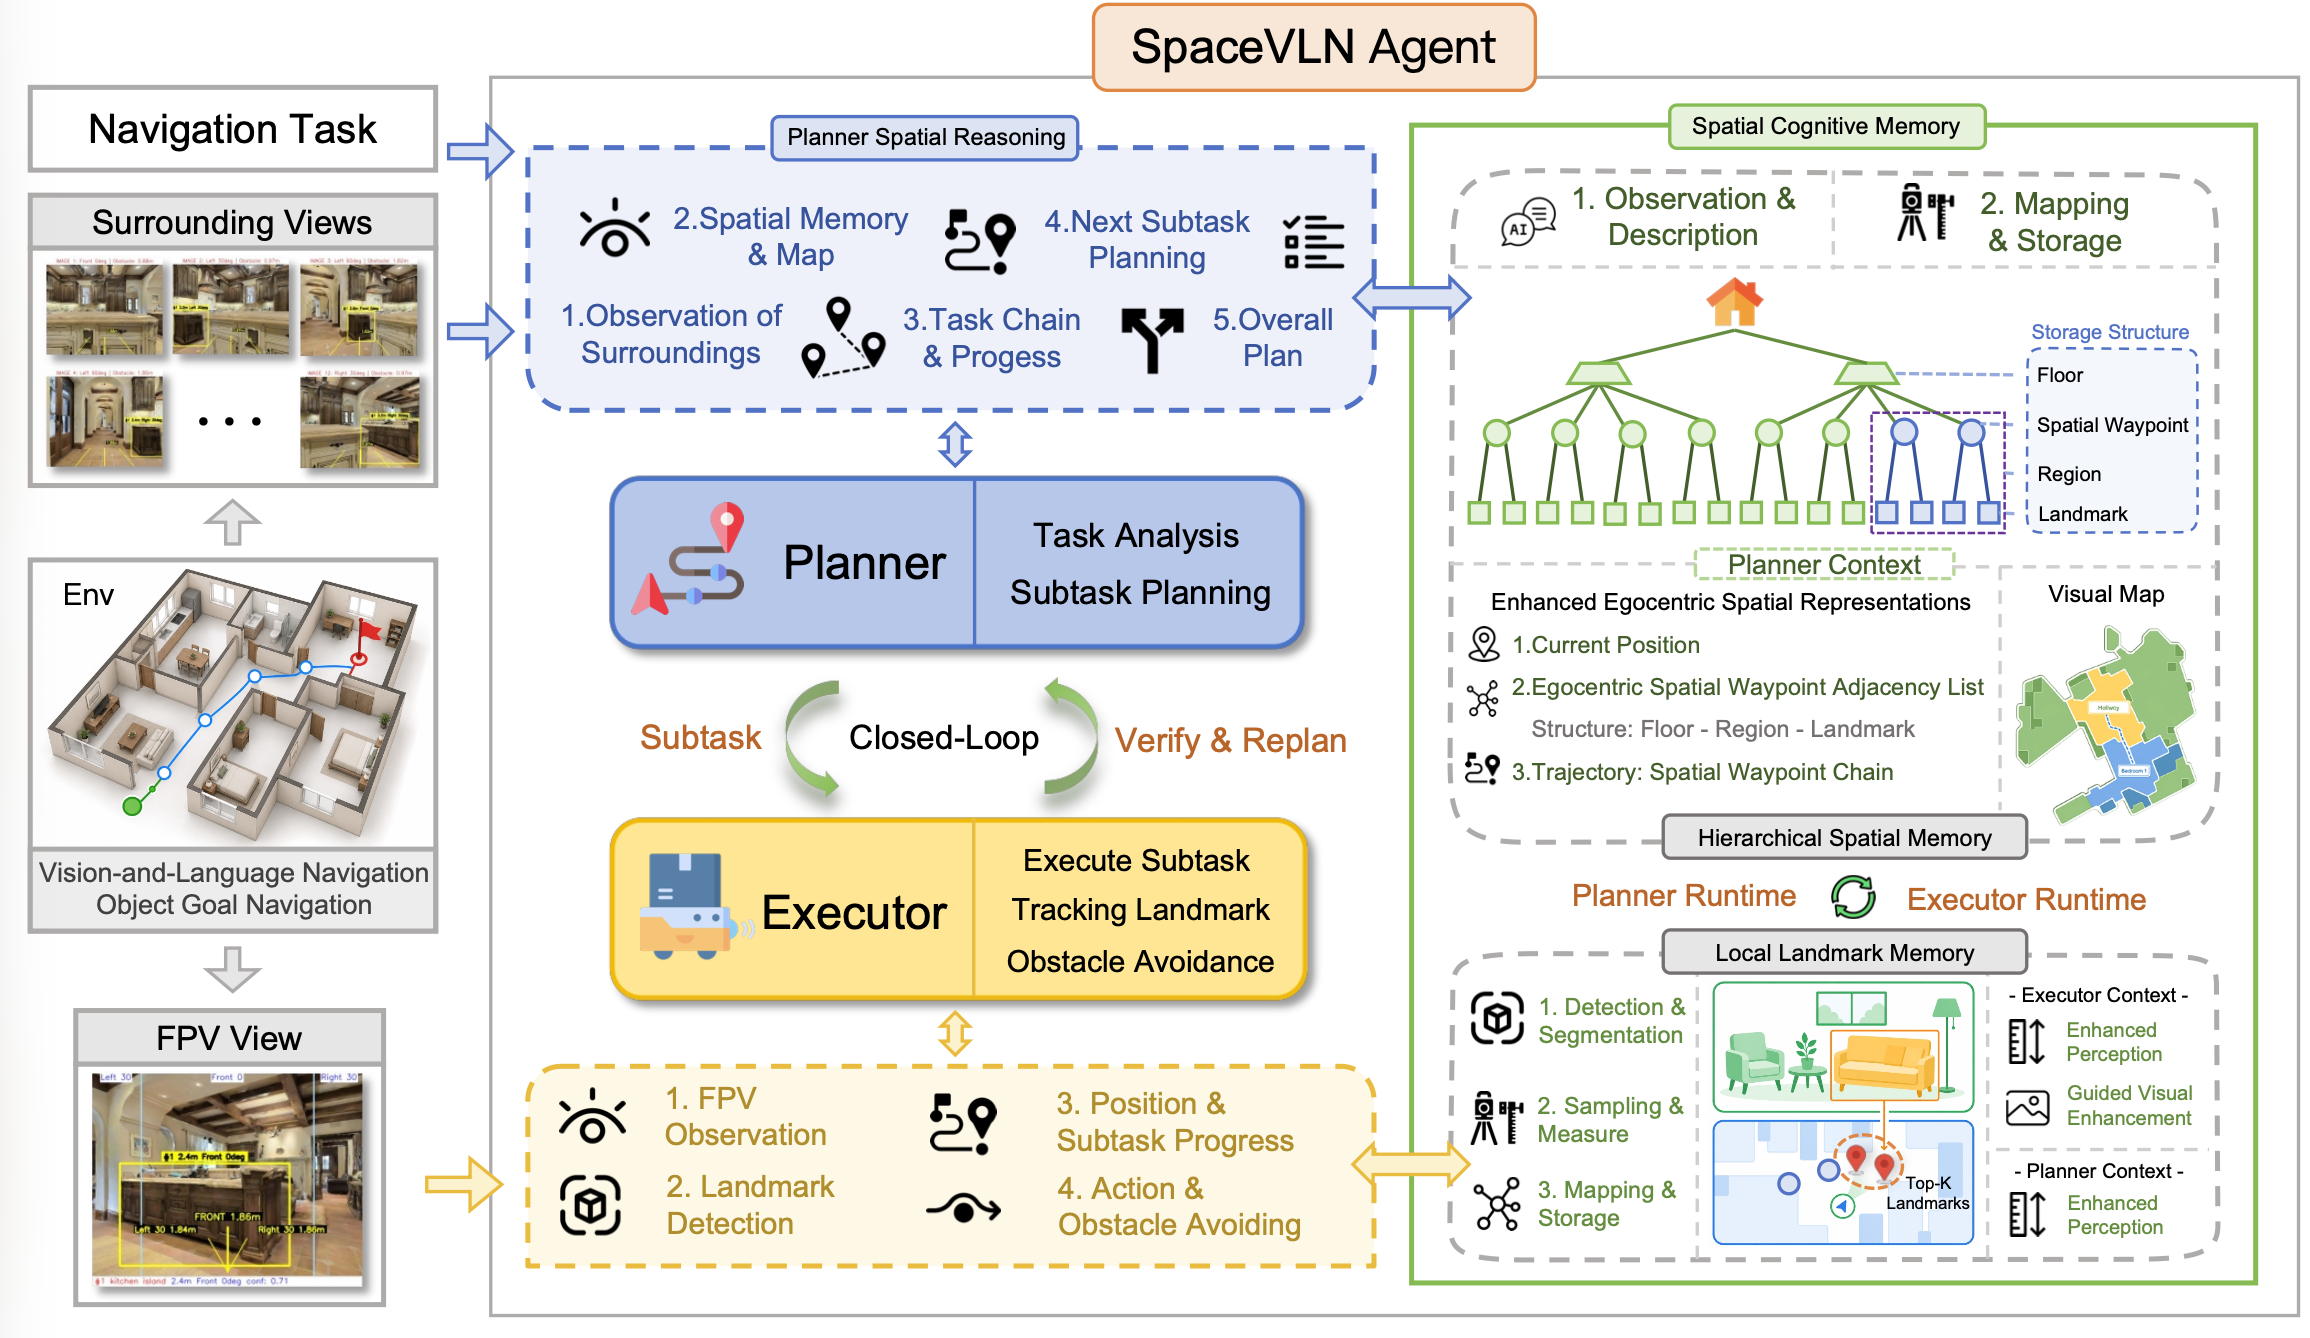
SpaceVLN 的主线是 Spatial Cognitive Memory + Task-Guided Spatial Reasoning :先把探索过的空间组织成在线记忆,再让 VLM 基于空间关系与当前证据判断任务进度,生成下一阶段目标。
Figure 2 · SpaceVLN 整体框架 图片暂未加载,请通过图片链接查看。
执行闭环 空间记忆 + 当前环视 → Planner 定位进度并选择下一阶段 → Executor 跟踪地标、避障执行 → 汇总执行结果与地标证据 → 更新空间记忆、核验进度 → 继续当前阶段或重新规划。
3. Stagewise Closed-Loop · 把整条任务拆成可核验的阶段
一个阶段由“空间状态 + 识别线索”定义。 空间可以是房间、连接区域或楼层转换处;线索可以是物体、地标或入口。
Planner 定位当前进度: 读取任务、每隔 30° 采集的 12 个方向视图、空间记忆和上一阶段反馈,构造有序的空间—地标锚点链。只下发下一阶段: 输出当前锚点、任务链、下一个未验证锚点、所选方向、子指令、追踪地标和全局完成标记。Executor 执行当前子任务: 读取第一视角 RGB-D、局部地标候选和障碍距离,在前进、左转、右转和停止中选择动作。阶段结束后重新核验: 到达阶段目标、Executor 请求停止、局部阻塞或阶段预算耗尽时,返回执行记录和阶段末地标池。Planner 根据新环视和记忆判断应继续、进入下一阶段,还是修正计划。4. Hierarchical Spatial Memory · 怎样持续保存空间结构
持久保存的基本单元是 Spatial Waypoint(SWP)。 每个 SWP 记录度量位姿、所属楼层、区域类型和局部地标集合。系统同时保留 SWP 图 与实际执行过的 SWP 链 ,分别表达空间连接和真实行走顺序。
先维护在线度量地图: RGB-D 与位姿投影得到已探索区域、可通行空间、障碍及轨迹,地图按 tile 存储已访问区域。在规划边界写入空间锚点: 从 Planner 输出的当前锚点解析区域和地标,与当前位姿、楼层一起生成 SWP;先追加到执行链,再进行区域聚合和重复节点合并。合并重复观察并维护连通性: 区域标签和度量空间支持一致的航点可以合并,门口、走廊和楼梯等连接证据用于避免误合并不同空间。图中的邻接既来自当前地图推断的可达关系,也来自执行链中连续经过的航点。转换成 Planner 可读的表示: 围绕当前位置组织空间邻接表,按楼层、区域列出 SWP 及地标,标记起点、上一位置、相对距离、方向与已知连接路径;同时提供已走的 SWP 链和渲染地图。例如,Planner 可以读到“当前在二楼卧室;上一个航点在床尾;浴室门口位于后方;某处虽然距离很近,但需要经过另一个航点才能到达”。这样,历史被组织为位置、关系和路径,能够直接支撑当前定位与进度判断。
5. Local Landmark Memory · 当前阶段具体跟踪什么
局部地标记忆围绕 Planner 指定的活动地标构建,例如“玻璃餐桌”或“通往浴室的门口”。它在一个阶段内持续融合观察,进入新阶段时重新初始化 ,避免上一子任务的检测结果干扰当前目标。
按目标检测与分割: 将地标描述规范化为查询词,只对这些词调用 GroundingDINO 与 RepViT-SAM,过滤过小、重复及过时的检测。用深度定位并融合: 将检测区域通过深度投影到空间,按类别、度量位置接近程度和置信度融合实例;每个实例保存类别、融合位置、相对距离、方位和置信度。压缩成 top-k 地标池: 按置信度降序、距离升序排序,同时提供“当前是否可见”和“是否已经到达”的标记。暂时离开当前视野的地标仍可通过本阶段记忆支持跟踪。用于执行与阶段反馈: Executor 结合地标池、第一视角和障碍距离选择动作。门口、通道、楼梯等入口类目标结合类别和深度轮廓识别,并采用类型相关的到达阈值;阶段末地标池摘要交回 Planner,帮助核验是否到达了指定锚点。6. Spatial-CoT · 怎样把记忆变成下一步决策
Planner 的推理按五个字段组织: 逐方向分析观察 → 结合地图与空间记忆定位 → 对齐任务链并判断进度 → 选择下一阶段 → 汇总短期与整体计划。它要把“看到了什么”与“已经走到指令哪一步”联系起来。
Executor 的推理按四个字段组织: 第一视角内容 → 目标地标核验 → 阶段位置与进度 → 考虑障碍后的动作选择。推理范围限定在当前子任务,模型输出还要落在当步允许的动作集合中。
例如,记忆显示已经从健身房经过客厅进入厨房,而当前右侧可见餐厅。此时 Planner 需要区分“厨房中岛”和指令要求的“餐厅玻璃餐桌”,把下一阶段设为进入餐厅并接近目标桌;Executor 再根据桌子的方位、距离和前方障碍决定如何移动。
运行时还会检查字段完整性与方向标签;前进无效时暂时屏蔽前进动作,连续转向过多时限制转向。如果没有可推进的动作,就把阻塞证据交回 Planner 重规划。Spatial-CoT 因而与空间记忆、阶段接口和实际执行反馈共同工作。
评测基座 主实验由 Qwen3.5-Plus 担任 Planner,Qwen3.5-Flash 担任 Executor;使用冻结的基础模型,无导航任务专用训练。 实验数据 R2R-CE val-unseen 全部 1,839 条;RxR-CE val-unseen 的 en-US 子集 2,433 条;GN-Bench 复杂指令子集 1,000 条;HM3D-OVON val-unseen 3,000 条。另在 TX-Q1 轮式机器人上评测 50 条自定义室内导航任务。 外部组件与执行 依赖 RGB-D、度量位姿、在线占据建图、GroundingDINO 和 RepViT-SAM。Executor 选择参数化基本动作,由控制器拆成仿真中的 0.25 m 前进与 30° 转向,或真机运动指令;真机以 RealSense D435i 获取 RGB-D、Livox Mid-360 提供位姿估计输入。 本篇结果: R2R-CE / Qwen3.5-Plus+Qwen3.5-Flash · RxR-CE / Qwen3.5-Plus+Qwen3.5-Flash
回到实验总表 ↑ 回到论文目录 ↑
22 AgenticNav Memory Tool Create
AgenticNav: Zero-Shot Vision-and-Language Navigation as a Tool-Calling Harness
2026.06 首次预印本原论文 ↗
1 · 要解决什么问题
许多零样本 VLN-CE 方法依赖经过训练的 waypoint predictor ,把全景 RGB-D 观察转成少数可导航候选点,再交给 VLM 选择。这一接口把语义推理连接到机器人行动,但也决定了模型能够选择哪些动作、获得哪些空间证据,以及如何使用历史。论文指出三个主要问题:
少量 waypoint 候选点限制了动作空间。 即使 VLM 在图像中看到了符合指令的方向或位置,只要 waypoint predictor 没有提出相应候选点,模型就无法通过这一接口选择它。导航表现因此同时受候选点覆盖范围和 VLM 决策能力影响。Depth 没有真正暴露给 VLM。 深度虽然被 waypoint predictor 使用,VLM 却难以主动获取某个门口、地面点或障碍物的准确距离。直接提供整张深度图,也不容易让模型读出可靠的数值关系;模型需要的是与当前决策相关、可以明确查询的几何证据。Memory 中包含太多无关历史。 持续把历史文本或图像追加到提示词中,会扩大上下文并分散注意力;而从先前 episode 检索经验,又改变了每个回合独立、无先验任务经验的零样本设定。需要让模型在当前 episode 内按需取回关键观察。
设计思路 · 让模型主动调用行动、深度和记忆接口
AgenticNav 把三类能力封装成工具:
像素目标选择 (Action Tool / move_to)局部深度查询 (Depth Tool / query_depth)历史图像召回 (Recall Tool / recall)
分工边界:
VLM 负责决策 :此刻缺什么证据、何时查询、目标往哪里走;工具负责执行 :数值几何反投影、缓存数据访问、执行前的几何安全检查。
2 · Framework:VLM 如何通过工具完成导航
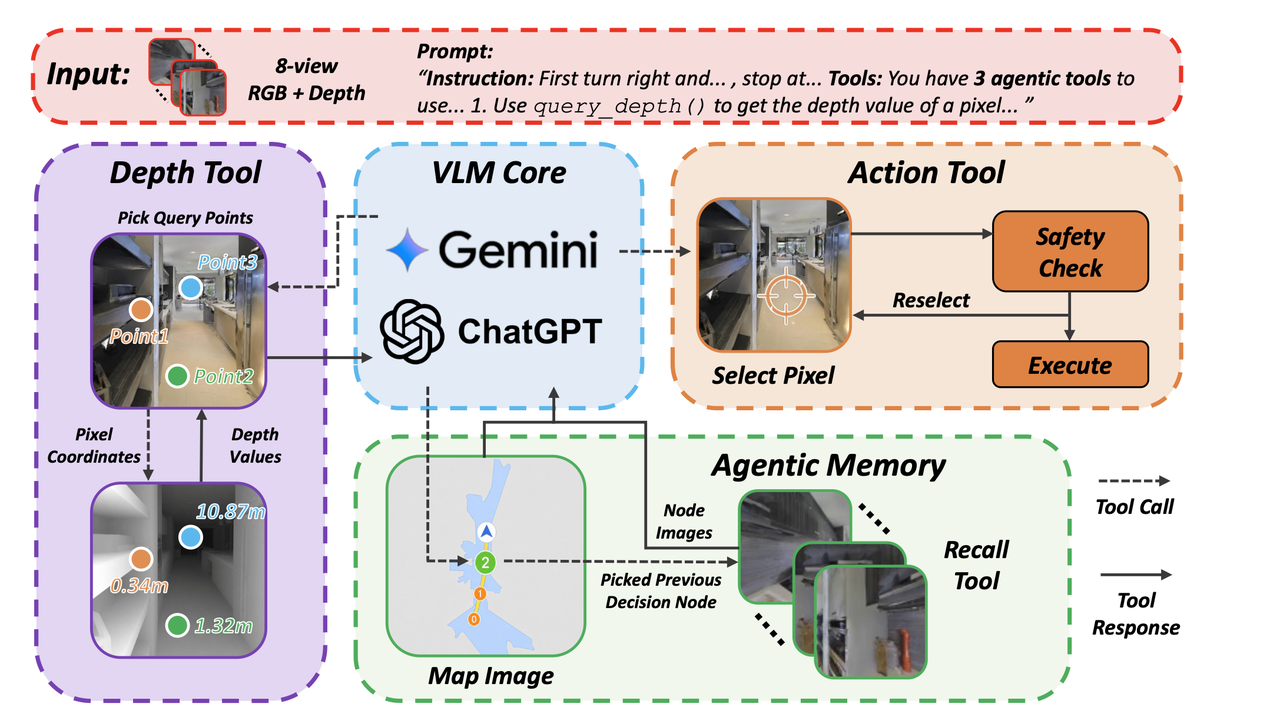
图 1 · AgenticNav Framework(论文 Figure 2)· 查看本地图 ↗ 本地图暂未加载,请检查 pic/AgenticNav.png。
框架接收指令和按朝向编号的多视角 RGB-D 观察,默认为 8 个视角。VLM 的默认输入是 RGB 图像、紧凑地图图像和当前对话/工具历史;对齐的深度图保留在工具侧。 因此,图里的“RGB + Depth”描述系统输入,并不表示 VLM 默认直接读取整张深度图。视角 0 与智能体当前朝向对齐,其余视角按相对偏航角编号。
三类核心能力:Depth Tool、Agentic Memory/Recall Tool 和 Action Tool。实际是四个可调用接口,其中还包括终止接口 stop():
观察与推理。 VLM 结合指令、当前多视角 RGB、地图和工具历史,判断当前进度、目标位置及需要补充的信息。按需查证。 模型可以多次查询深度或召回历史图像,读取工具反馈后再做决定;查询和召回的顺序由模型选择。提交像素目标。 通过 move_to(k, u, v) 直接选取图像中的目标点,可选范围受当前视野、深度有效性和几何安全条件约束。转换与检查。 Action Tool 使用深度、相机内参及视角变换,把像素反投影到智能体坐标系的三维点,再计算地面方向角和移动距离。执行或重选。 工具将有效深度反投影成空间点,通过则 Execute,否则 Reselect,要求模型重选。后续决策继续使用新的观察和回合内记忆。
查看完整流程图 ↗ 流程图暂未加载,请通过上方链接查看。
3 · Depth Tool:把深度变成可查询的数值证据
Depth Tool 让 VLM 先在 RGB 图像上读取需要位置的真实深度,模型比较门口、通道地面或地标附近的点,工具负责准确取数和动作几何计算。
3.1 · 输入:批量指定“哪个视角、哪个像素”
query_depth(P) 接收查询集合 $$\mathcal{P}$$ P $$p_i=(k_i,u_i,v_i)$$ p i = ( k i , u i , v i ) $$k_i$$ k i $$(u_i,v_i)\in[0,1]^2$$ ( u i , v i ) ∈ [ 0 , 1 ] 2 $$u_i$$ u i $$v_i$$ v i
3.2 · 输出:深度、邻域统计与动作预览
像素深度 $$d_i$$ d i 在与 RGB 对齐的深度图中采样,返回所选像素的深度,单位为米,是传感器深度值。
邻域统计 $$s_i^{5\times 5}$$ s i 5 × 5 返回所选像素周围五乘五邻域的最小、平均和中位深度,帮助 VLM 判断该点是否位于稳定表面或深度边界附近。
动作预览 $$(\hat{\theta}_i,\hat{\rho}_i)$$ ( θ ^ i , ρ ^ i ) 返回同一像素若随后交给 move_to 时对应的相对偏航角和可执行前进距离。
4 · Agentic Memory:地图常驻,历史图像按需召回
AgenticNav 的记忆只覆盖当前 episode ,原文将其定义为:
$$M_t=(B_t,C_t)$$ M t = ( B t , C t )
4.1 · $$B_t$$ B t
地图图像概括已经走过的轨迹和历史决策节点,并在每一步加入提示词。模型可以借助地图理解当前位置与过去路径的关系,也可以用节点编号指明想要回看的地点。这一部分保留历史的空间概览,避免每次都展开全部历史图像。
4.2 · $$C_t$$ C t
过去观察到的图像保存在有界缓存中,可按历史节点和视角访问。保存了历史图像,并不意味着每次推理都把这些图像传给 VLM。 只有当前决策确实需要某个地点的视觉细节时,模型才主动发起召回。
4.3 · Recall Tool:取回指定节点、指定视角的原图
调用 recall(p, k) 时,$$p$$ p $$k$$ k
$$R_t(p,k)=C_t[p,k]$$ R t ( p , k ) = C t [ p , k ]
Memory 的信息流 历史观察 → 回合内图像缓存;历史轨迹 → 紧凑地图 → 每步提供给 VLM;需要视觉细节时 → recall(节点, 视角) → 只返回请求的缓存图像 → 支持当前决策
评测基座 GPT-5.5、Gemini-2.5-Pro(主实验);另有 Qwen3.6-27B 等基座对照。
实验数据 沿用 Open-Nav 协议的 R2R-CE val-unseen 固定 100 条导航 episode。
外部工具调用 Depth Tool(query_depth)查询像素深度;Recall Tool(recall)召回历史图像;Action Tool(move_to)将像素目标反投影为运动并进行几何安全检查;stop 终止任务。
本篇结果: R2R-CE / GPT-5.5 · R2R-CE / Qwen3.6-27B
回到实验总表 ↑ 回到论文目录 ↑
23 History to Future: Evolving Agent with Experience and Thought for Zero-shot Vision-and-Language Navigation
2026.06 论文集月份原论文 ↗
1. 需要解决的问题
只根据当前观察判断下一步,容易重复以前的错误,也难以确认自己已经执行到指令的哪一步。 EvoNav 希望把历史经验与未来预期同时放入决策:先推断接下来要做什么、会遇到什么地标,再检索相关的导航经验,辅助当前方向选择。
导航进度判断缺少前后关联: 当前场景可能与指令中的多个阶段相似,仅凭眼前图像容易提前跳过子任务或重复执行。完成过的任务没有转化为经验: 失败原因、成功路线和绕路情况如果不被总结,后续相似任务仍可能重复同样的决策。任务经验和视觉参考承担不同作用: 一条相似任务的总结能提供整体指导,而曾经见过的场景图像能帮助判断当前要寻找的地标。2. Framework · Future Thought + History Experience
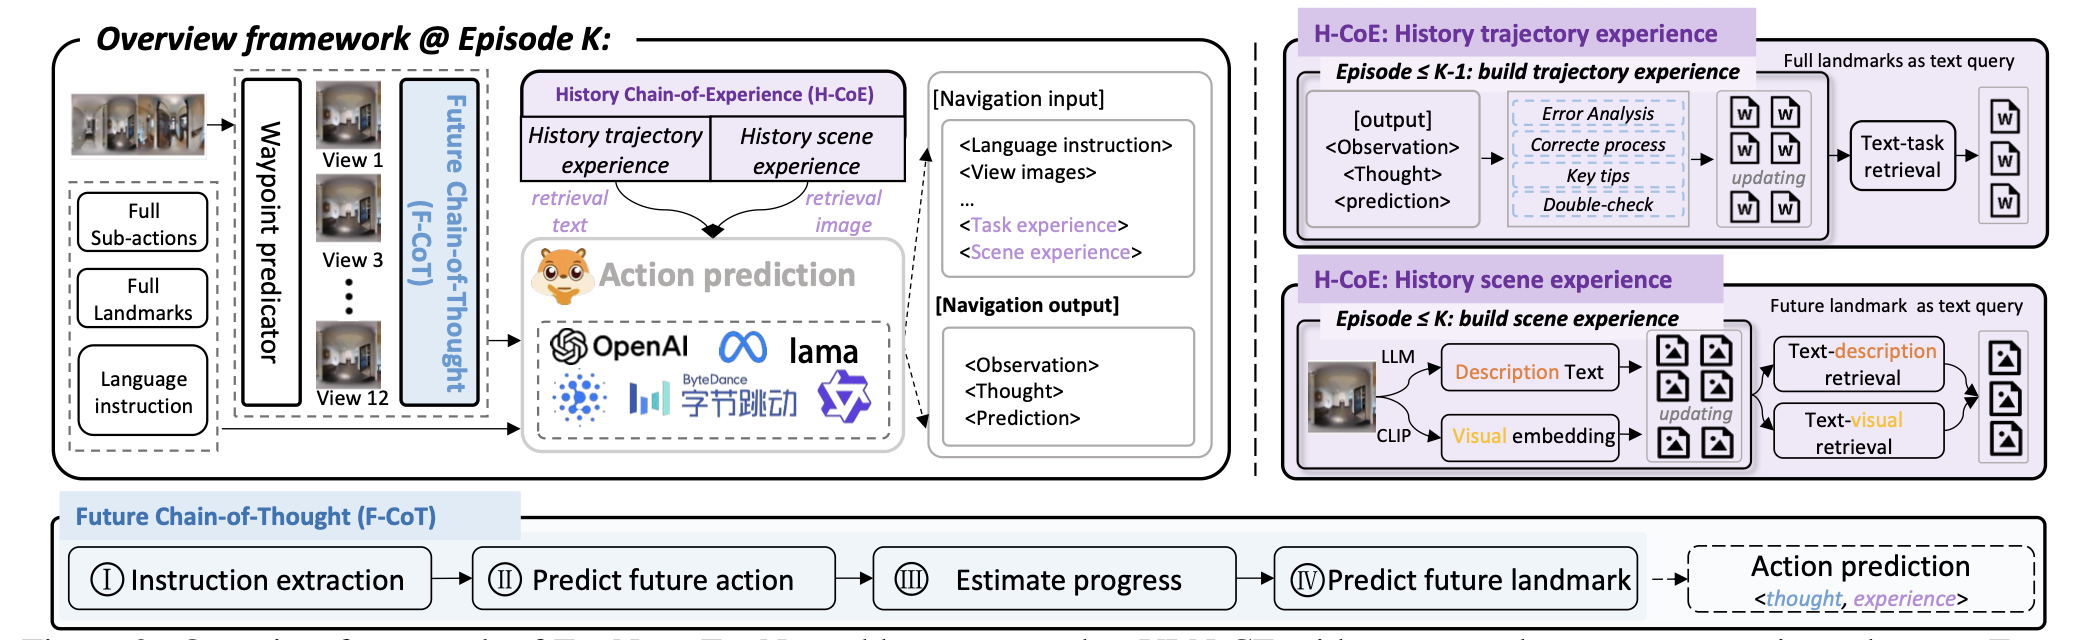
Figure 2 · F-CoT 未来推理链与 H-CoE 历史经验链 图片暂未加载,请通过图片链接查看。
每一步接收周围 12 个方向的 RGB-D 观察 ,由已有的 waypoint predictor 提供可行候选。LLM 将指令拆成子动作与地标,结合 F-CoT 的进度推理,以及 H-CoE 从经验库召回的轨迹总结和场景图像,选择当前要前往的候选航点。
“Evolving”主要体现在经验库不断积累,并改变后续决策的上下文 。导航过程中不更新 LLM 权重,waypoint 候选模块则沿用已有的训练模型。
3. F-CoT · 用未来动作辅助判断当前进度
Instruction Extraction: 解析完整指令,得到按时间组织的子动作列表,以及指令中出现的空间地标列表。Predict Future Action: 结合完整指令、当前观察和此前路径历史,预测接下来还需要执行的动作;起点的历史设为“Step 0 start position”。Estimate Progress: 用未来动作对照子动作列表、地标列表和已走路径,判断哪些动作已完成。未来预期为当前进度判断提供额外线索。Predict Future Landmark: 根据已完成进度推断下一步相关地标。若下一动作明确提到物体,必须匹配并输出原地标列表中的名称;若只要求“左转”“右转”“向前走”,则输出 None。F-CoT 在语言层面组织未来动作与地标预期。它产生的下一地标既用于方向判断,也成为后续场景经验检索的查询。
4. H-CoE · 轨迹经验怎样从一个任务传到下一个任务
先在 episode 完成后评估,再总结经验。 论文计算 NE、SR、OSR 和 SPL,并将这些评测结果连同完整的观察、推理和动作历史交给 LLM。
系统用 Chroma 向量数据库 保存任务指令、地标、完整轨迹与经验总结。处理新 episode 时,以整条指令中的全部地标 作为文本查询,通过余弦相似度召回 top-K 轨迹经验。
5. H-CoE · 场景经验怎样通过两路检索提供图像
场景记忆按导航步更新。 观察图像写入经验库,建立两类索引:一类是 LLM 生成的场景描述及其文本向量,另一类是 CLIP 提取的图像外观向量。
确定查询: 使用 F-CoT 预测的未来地标作为查询文本,例如接下来要找的“厨房”。Text-description retrieval: 比较查询与历史场景描述的文本相似度,召回描述相符的场景图像。Text-visual retrieval: 用 CLIP 将查询文本与历史图像映射到共同特征空间,比较图文相似度,召回外观相关的图像。合并视觉参考: 将两路召回的场景图像作为 scene experience,连同轨迹经验和未来推理一起送入动作决策。场景库能够包含更早 episode 和当前 episode 已完成步骤 的观察。因此,轨迹总结按任务写入,场景图像按步骤写入。
6. Action Prediction · 将未来预期与历史经验用于当前选点
决策模块接收指令、子动作与地标列表、当前候选视图、路径历史、进度判断,以及召回的两类经验。它先描述可见物体和空间关系,再结合未来地标与经验进行判断,输出 Observation、Thought 和 Prediction,其中预测结果指定要移动到的候选视点。
执行流程 RGB-D 与候选航点 → F-CoT 推断动作、进度和未来地标 → 按全部地标检索轨迹经验、按未来地标检索场景图像 → 融合信息选点 → 执行并更新历史与场景记忆;episode 结束 → GT 评分 → 总结并写入轨迹经验。
评测基座 主结果包含 Gemini-2.5-Pro 与 GPT-4o,并测试多种开放与闭源多模态模型。核心机制通过提示流程、检索和经验写入实现。 实验数据 R2R-CE 采样评测中,Gemini-2.5-Pro 的 SR 为 43%、SPL 为 37.77%;GPT-4o 的 SR 为 30%、SPL 为 24.91%。NavRAG-CE 上,Gemini-2.5-Pro 的 SR 为 30%、SPL 为 17.60%。真机使用全向轮式机器人,在实验室、走廊、电梯厅和自习室四种环境中,每种评测 20 条指令。 外部组件与执行 依赖已有 waypoint predictor、12 视角 RGB-D、CLIP 与 Chroma。经验库随已完成任务和步骤增长,轨迹总结还使用 GT 评测指标;理解或比较结果时,需要同时考虑经验初始化和积累过程。 本篇结果: R2R-CE / Gemini-2.5-Pro · R2R-CE / GPT-4o
回到实验总表 ↑ 回到论文目录 ↑
24 Minimal-Interface Probe Harness Framework
Embodied Agents Take Control: Minimal-Interface Zero-Shot Agents Rival Industrial-Scale Policies in Vision-and-Language Navigation
2026.07 首次预印本原论文 ↗ · 官方代码 ↗
个人评语 相当于把react的范式套在了 VLN 上,主要是用做一个 Probe 来查看具体的增益是在agent架构上还是基模上
1. 需要解决的问题 已有 VLN 系统通常同时引入强基座、地图、记忆、waypoint predictor 和专用控制流程,因此难以回答:导航能力究竟来自模型本身,还是来自人为编写的导航模块与执行流程? 当模型已经具备多轮视觉理解、推理和工具调用能力时,还需要多少导航专用支持?
本文把问题收缩为一个能力探针:仅提供单目 RGB 和基础动作,让通用 coding agent 自己组织观察、移动、纠错与停止,检验它能否完成零样本导航。原文也明确将这一设置称为诊断性实验,而非新的导航架构。
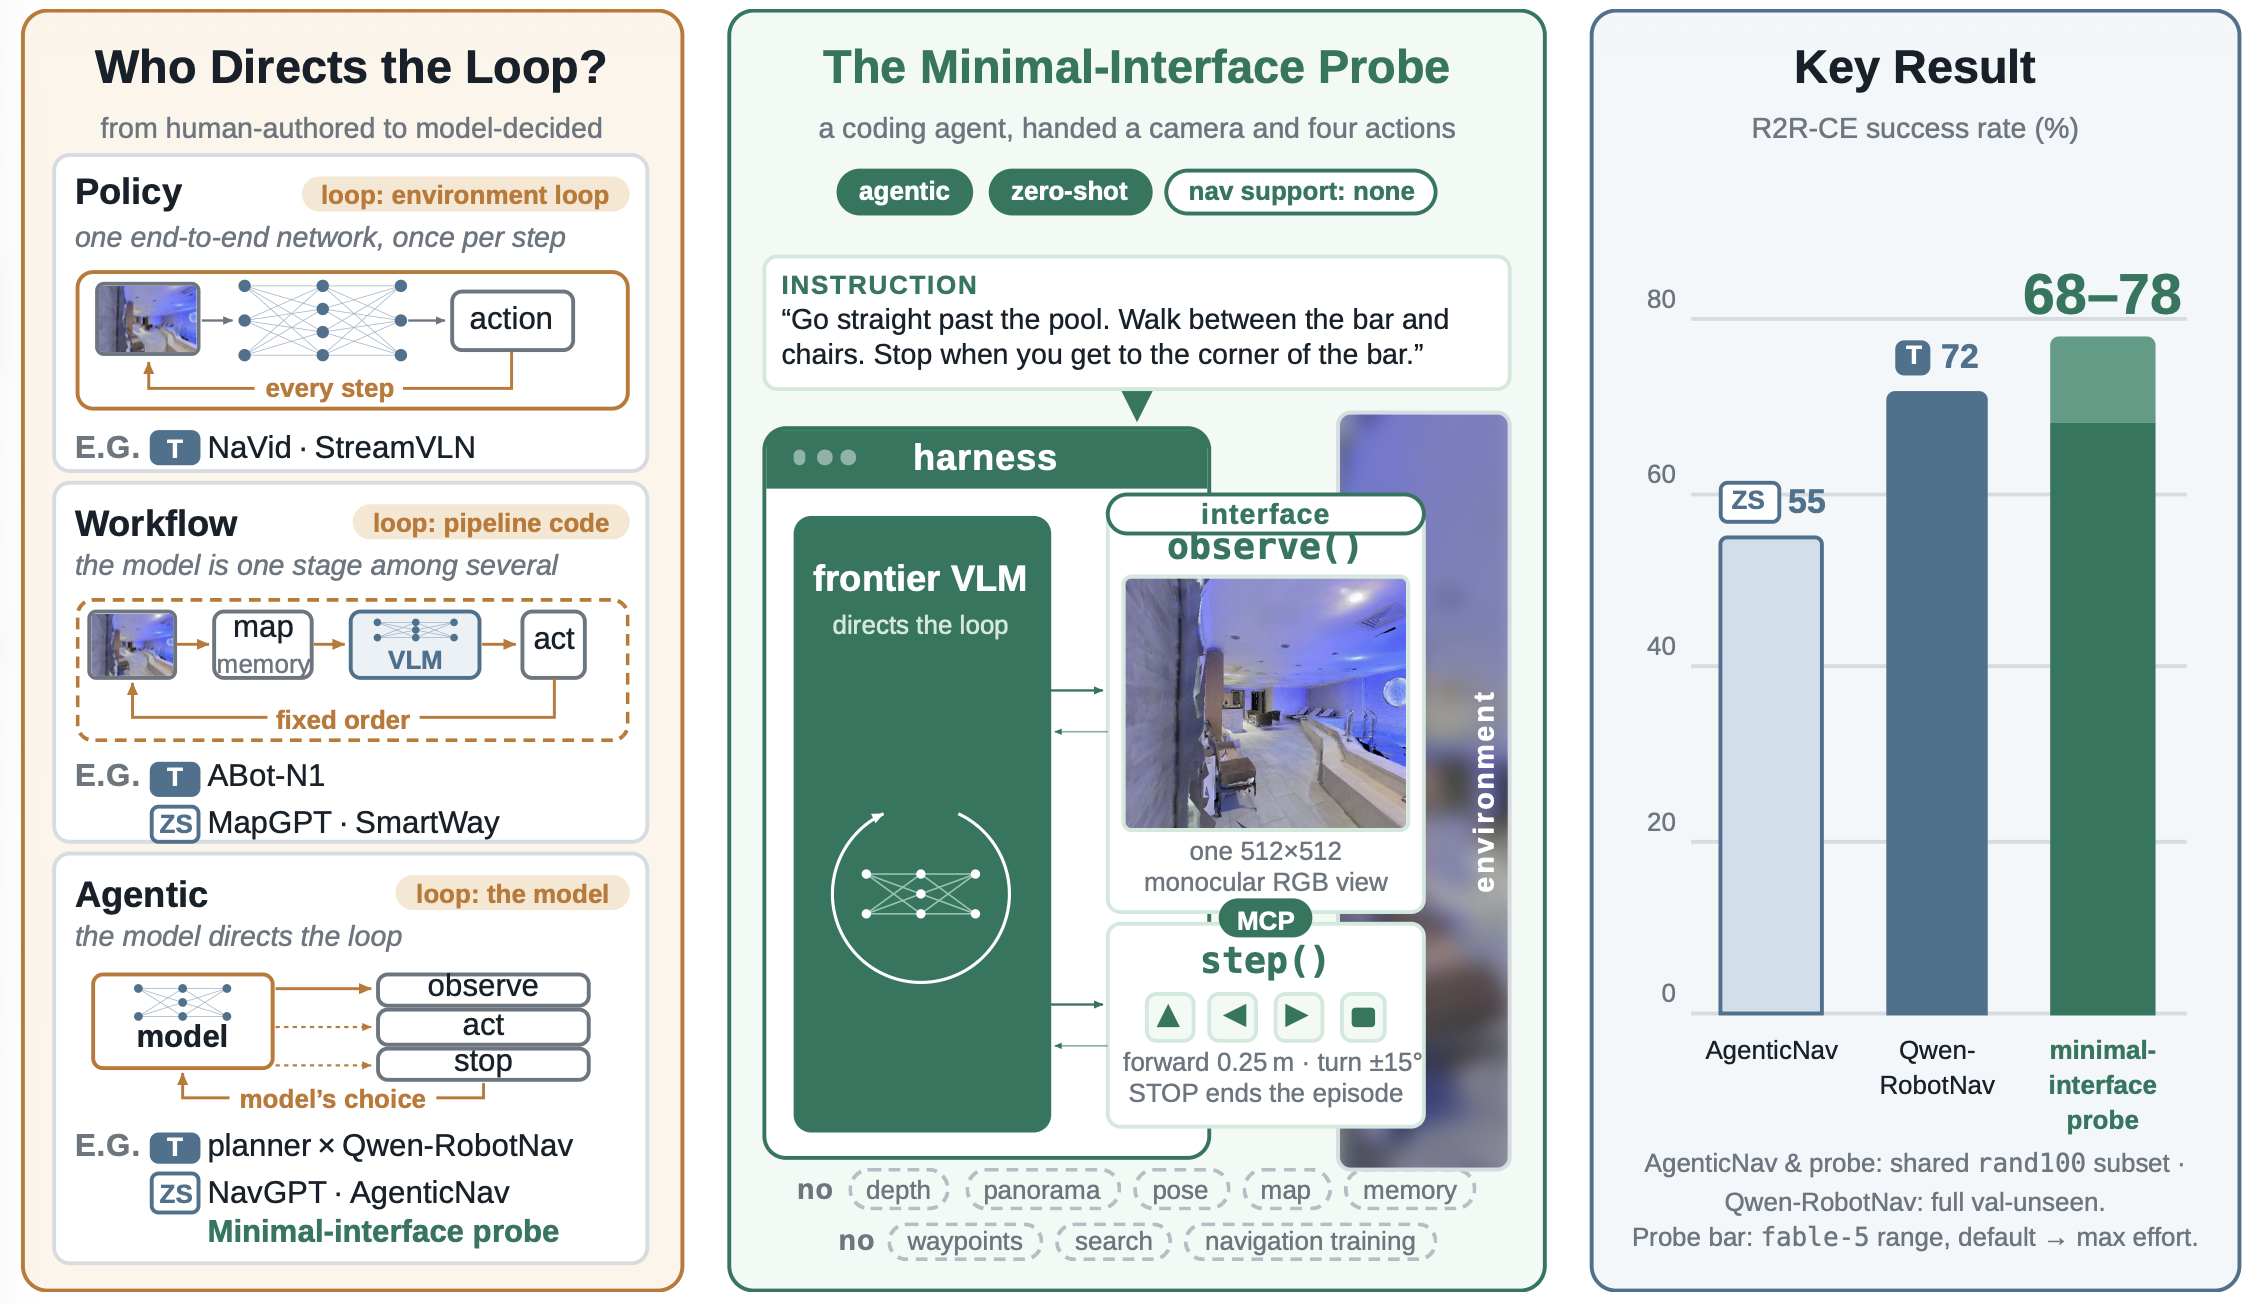
2. Framework · 谁掌握交互循环 论文按控制权区分三种组织方式:Policy 在外部环境循环的每一步输出动作;Workflow 由人工管线规定感知、记忆、规划和执行的调用关系;Agentic 则让模型选择工具、动作序列和终止时机。Minimal-Interface Probe 使用第三种方式。
Figure 1 图片暂未加载,请通过图片链接查看。
建立独立会话: 每条 episode 将导航指令与固定任务说明交给 mini-swe-agent、Claude Agent SDK 或 Codex CLI。模型读取视觉与历史: 调用 observe() 获取前向 RGB,结合指令、之前的图像和工具记录推断当前位置、路线进度及下一步动作。模型提交动作: 通过 step(actions) 执行一组离散动作;模型决定转向多少次、前进多少步,以及何时重新观察。通过下一次观察验证: 工具不会直接报告碰撞或真实位移。模型需要从新旧图像推断是否被挡住、是否走错,并自行提出调整。自主停止: 模型在动作序列中提交 STOP 结束 episode。是否成功由环境在结束后评测,评分和真实目标距离不反馈给模型。3. 最小接口 · 两个工具、四种动作
评测基座 原文报告 Qwen、GPT、Claude 等模型,并比较 mini-swe-agent、Claude Agent SDK、Codex CLI。代表配置为 opus-5/Claude Agent SDK 默认 effort,以及 fable-5/Claude Agent SDK 默认或 max effort;型号沿用所提供 PDF 的标记。 实验数据 主实验为 R2R-CE val-unseen 固定 rand100 的 100 条,与 Open-Nav、AgenticNav 等使用同一子集。Claude SDK 的默认 effort 配置重复 3 次,多数其他配置仅运行一次;另有 RxR-CE、VLNVerse、HM-EQA 和 31 条实体机器人探索实验。 外部工具调用 最小设置只有 observe() 与 step(actions),Waypoint/Hybrid 对照额外使用训练过的候选点预测器。 代码发布范围(2026-10-05 核实):官方重实现,MIT 许可;README 指向原实验代码的归档分支。当前主仓库不包含 waypoint/hybrid 实验分支。 仓库说明 ↗
本篇结果: R2R-CE / opus-5 / Claude Agent SDK · R2R-CE / fable-5 / Claude Agent SDK / max
回到实验总表 ↑ 回到论文目录 ↑
25 HAM-VLN: Harnessing Hierarchical Agentic Memory for Zero-Shot Vision-and-Language Navigation
2026.07 首次预印本原论文 ↗
1 · 要解决什么问题
长程导航需要记住走过哪里、指令完成到哪一步,哪些分支已经尝试失败,零样本导航方法常用两种方式表示历史,分别带来存储与推理上下文:
稠密语义地图(Dense Semantic Maps)。 将语义标签或开放词汇特征存为与像素、体素对齐的张量,规模随着建图区域扩大而增长。地图内容的构建通常独立于当前导航决策;“卧室里的桌子”“通向厨房的走廊”等指令,还需要再与地图中的度量单元匹配。原始视觉历史(Raw Visual Histories)。 将过去的全景图不断追加到模型上下文。轨迹越长,图像越多,重要地标容易被重复或无关细节淹没;走过的死路也没有自然形成可在下次决策中直接使用的失败记录。
两者都保留了过去的观察,但还需要解决哪些信息值得留下、如何组织成与任务相关的状态、何时再次取用 。
2 · Framework:Hierarchical Agentic Memory 如何组织四种记忆
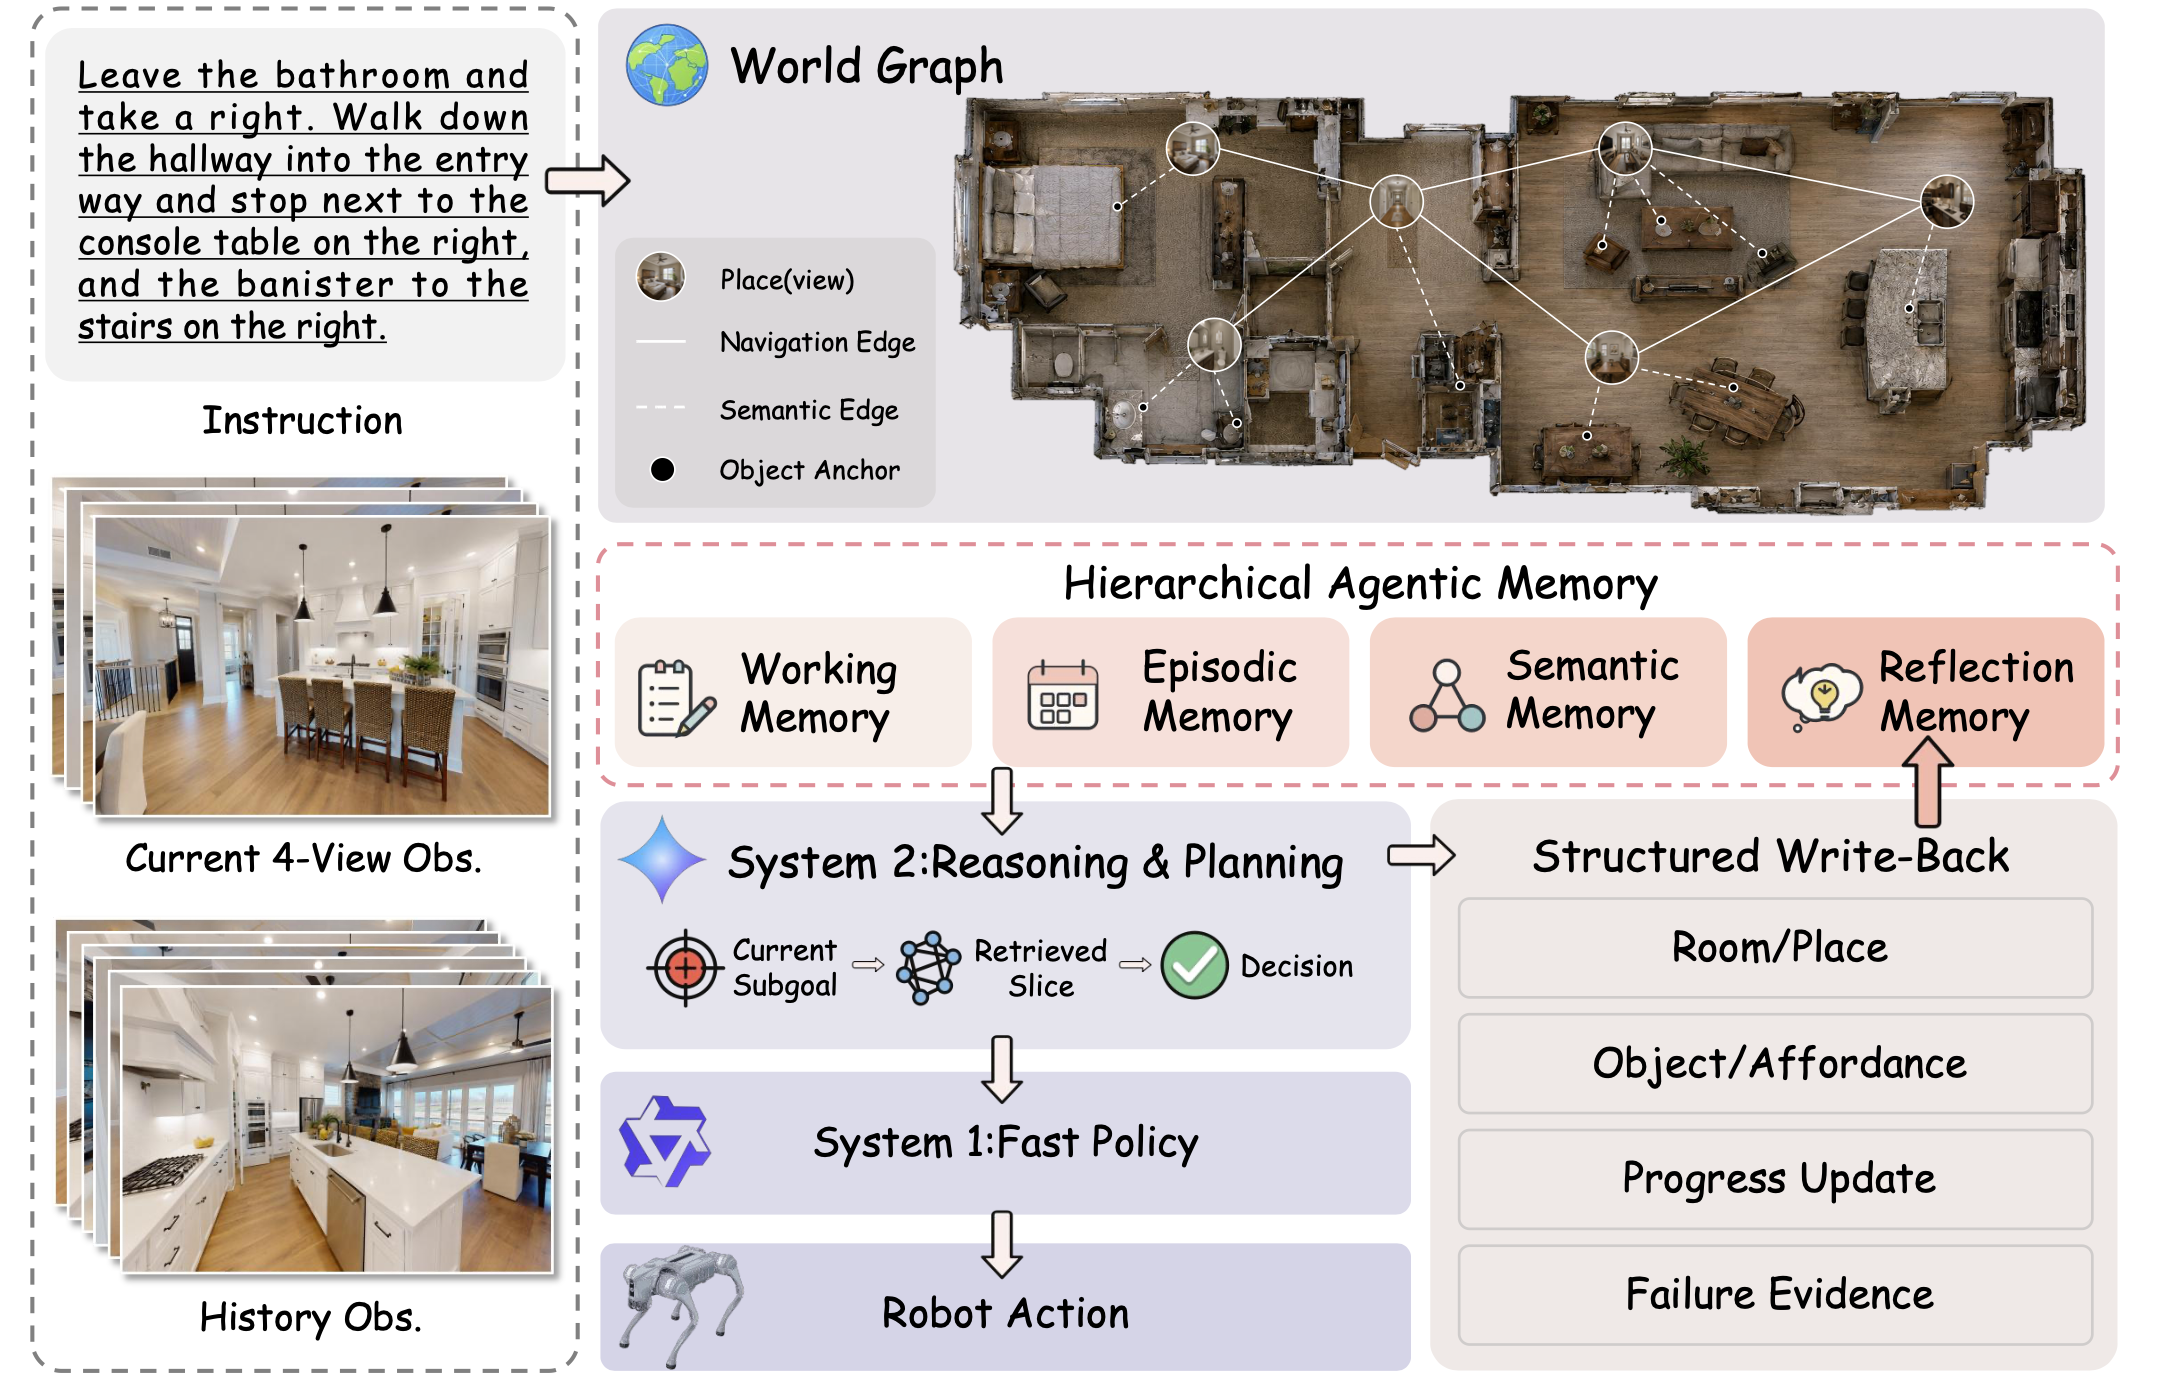
图 1 · HAM-VLN Framework(论文 Figure 2)· 查看本地图 ↗ 本地图暂未加载,请检查 pic/HAM-VLN.png。
System 2 在每个决策 waypoint 读取指令、当前全景和记忆上下文,选择前进方向、返回历史 waypoint 或停止,并输出结构化记忆写入。System 1 根据选中视角与目标描述预测目标框,控制器将框内代表像素通过深度与位姿投影到三维空间,再用 FMM 执行局部路径。
Hierarchical Agentic Memory 提供四种功能视图 。工作记忆保存近期帧;情景、语义和反思记忆从同一个 world graph 中读取各自相关的状态。
此外,系统维护有序的指令进度记录 $$L_t$$ L t $$q_t$$ q t
$$M_t=W_t\oplus L_t\oplus\mathcal{R}(G_t,q_t)$$ M t = W t ⊕ L t ⊕ R ( G t , q t )
其中,$$\mathcal{R}(G_t,q_t)$$ R ( G t , q t ) $$\oplus$$ ⊕
3 · Sparse grounded world graph:稀疏且有几何锚点的世界图
世界图在当前 episode 内持续积累,以地点节点、物体节点和两类边 表示长期状态:
$$G_t=\bigl(\mathcal{V}_t^P,\mathcal{V}_t^O,\mathcal{E}_t^{PP},\mathcal{E}_t^{PO}\bigr)$$ G t = ( V t P , V t O , E t P P , E t P O )
地点节点 $$\mathcal{V}_t^{P}$$ V t P 通过增量 single-link clustering(单链接聚类)形成地点状态,聚合空间锚点、模型撰写的地点语义、访问统计及可选的失败记录。
物体节点 $$\mathcal{V}_t^{O}$$ V t O 将深度定位后的类别观察,与开放词汇描述、软属性关联起来;原文按地点/类别层面整合这些对象信息。
地点—地点边 $$\mathcal{E}_t^{PP}$$ E t P P 记录地点之间的导航连通关系,为再次访问和回溯保留拓扑依据。
地点—物体边 $$\mathcal{E}_t^{PO}$$ E t P O 记录语义包含关系及其置信度,例如某处地点关联哪些物体或地标。
Grounded 如何实现: Grounding DINO 提供开放集检测,SAM 提供分割掩码;系统结合深度将观察投影为空间证据,再与位姿、已有地点和对象进行关联。重复观察被融合到图中,语义描述因此能够关联到可用于导航的几何位置。
4 · Decision-coupled updates:同一次决策完成结构化记忆写入
System 2 每次规划都会产生结构化决策记录:
$$J_t=(a_t,w_t,r_t)$$ J t = ( a t , w t , r t )
动作 $$a_t$$ a t 选择前进方向、回溯目标或停止。写入内容 $$w_t$$ w t 记录地点语义、观察到的对象和指令进度更新。行动理由 $$r_t$$ r t 解释当前决定;发生回溯时,该理由进一步作为被放弃区域的失败证据写回。
这份输出与当前 RGB-D、位姿提取的几何证据共同更新状态:
$$L_{t+1}=\mathcal{U}_L(L_t,w_t)$$ L t + 1 = U L ( L t , w t )
$$G_{t+1}=\mathcal{U}_G\bigl(G_t,w_t,\Gamma(O_t,D_t,P_t)\bigr)$$ G t + 1 = U G ( G t , w t , Γ ( O t , D t , P t ) )
进度更新算子把写入结果应用于指令进度;图更新算子负责观察与地点/物体的关联、重复证据融合和拓扑维护。
$$\Gamma(O_t,D_t,P_t)$$ Γ ( O t , D t , P t ) 模型撰写语义与理由,投影、关联及图维护由自动化程序执行。
5 · Retrieval:按当前子目标读取少量相关地点
5.1 · 先确定查询,再给地点打分
查询来自指令进度中第一个待完成条目。系统使用本地 bge-large-en-v1.5 对当前子目标和各地点状态摘要编码,并按三项得分排序:
$$s_t(p)=\alpha\,\operatorname{rel}(q_t,p)+\beta\,\operatorname{rec}_t(p)+\gamma\,\operatorname{sal}(p)$$ s t ( p ) = α rel ( q t , p ) + β rec t ( p ) + γ sal ( p )
Relevance 当前子目标与地点摘要的向量余弦相似度,反映这处地点与当前任务的语义相关性。
Recency 按上次访问时刻衰减:$$\operatorname{rec}_t(p)=\rho^{t-\tau(p)}$$ rec t ( p ) = ρ t − τ ( p ) $$\tau(p)$$ τ ( p ) $$\rho=0.85$$ ρ = 0.85
Salience 结合地标一致性和对象丰富程度,反映地点中可用导航证据的重要程度。它不是反思记忆或失败惩罚项。
5.2 · 通过拓扑扩展组成图切片
选取得分最高的 3 个地点 作为种子。
扩展种子的一跳邻居,并纳入当前地点的邻域 。
在上述候选中保留最多 5 个地点 ,形成相应的地点—物体子图。
将语义内容、相对几何、拓扑和关联失败证据序列化,再与工作记忆和指令进度共同输入 System 2。
6 · Grounded backtracking:回溯同时改变位置和失败记忆
回溯由 System 2 选择一个已经访问过的 waypoint 作为返回目标。HAM-VLN 同时记录被放弃分支在当前子目标下为何失败。
确定返回目标。 System 2 输出回溯动作和目标 waypoint;控制器使用其已保存的空间锚点执行返回。识别放弃的分支。 取返回目标之后的轨迹后缀,将其中的 waypoint 映射到关联地点,并排除返回目标所属地点。写入失败证据。 把这次决策的理由挂接到上述被放弃地点。返回目标保留在 waypoint 层面,便于执行;失败记录保存在 place 层面,可复用。条件召回。 以后只有相应区域被子目标检索选中,失败备注才随图切片原样返回,供 System 2 判断该经验是否适用于当前任务。
查看完整流程图 ↗ 流程图暂未加载,请通过上方链接查看。
评测基座 System 2:Gemini-3.1-Pro;System 1:Qwen3.6-35B。
实验数据 R2R-CE、RxR-CE 和 HM3D-v2 ObjectNav 分别采用 Uni-LaViRA 使用的 100 条子集协议,各重复运行 3 次,报告均值与标准差。
外部工具调用 Grounding DINO/SAM 提供检测与分割,RGB-D 与位姿用于几何定位;本地 bge-large-en-v1.5 支持语义检索;FMM 在局部可通行地图上执行前进和回溯,不依赖训练的 waypoint predictor。
本篇结果: R2R-CE / Gemini-3.1-Pro + Qwen3.6-35B · RxR-CE / Gemini-3.1-Pro + Qwen3.6-35B
回到实验总表 ↑ 回到论文目录 ↑
26 NavMCP Memory Harness Framework
Scaffolding Foundation Models into Physical-World Agents Pushes the Frontier of Long-Horizon Navigation
2026.08 首次预印本原论文 ↗
1. 需要解决的问题
VLM 能判断“还缺什么证据”,导航基础模型能执行“去哪里找”,但多次导航之间容易丢掉沿途观察和任务进度。 NavMCP 关注两者之间的调用接口:怎样把一段段独立导航,组织成能持续搜集证据、调整计划并完成问答的长时任务。
高层需求与运动指令之间有差距: “确认床头灯是否亮着”是一项取证需求,需要转成可执行的搜索区域或导航子目标。只返回终点会漏掉沿途证据: 机器人经过的房间、看到的物体和未检查的出口,都可能影响后续答案与路线选择。多次调用缺少持续状态: 如果没有保存搜索范围、已有证据和未完成目标,Agent 容易重复搜索,也会在上下文被压缩后忘记之前的发现。2. Framework · VLM 推理与 NFM 执行之间的三通道接口
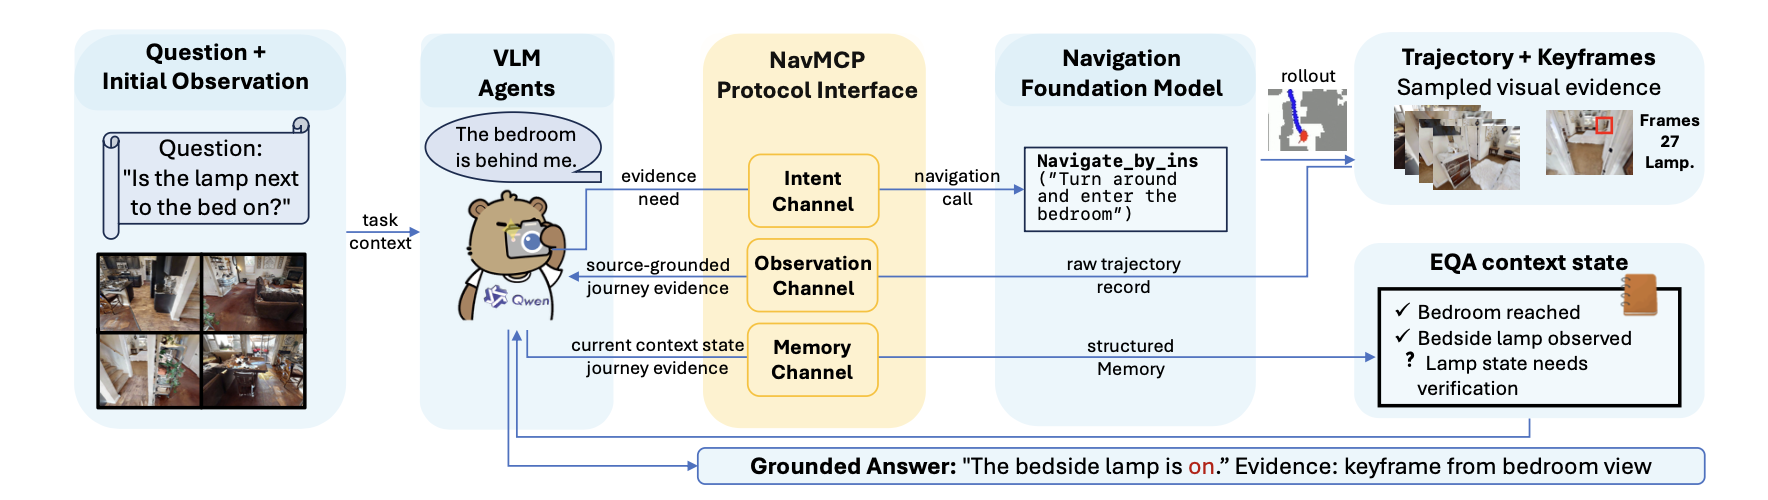
Figure 2 · Intent、Observation 与 Memory 三通道协作 图片暂未加载,请通过图片链接查看。
高层 VLM 负责决定缺什么信息、到哪里寻找、是否需要继续检查以及什么时候回答 ;底层 Navigation Foundation Model(NFM)接收自然语言子目标,在实际观察反馈下闭环执行。NavMCP 的 Harness 负责组织调用、整理导航返回,并在多轮之间维护任务状态。
组合已有 VLM 与 Qwen-RobotNav 导航模型,不为这套接口额外训练或修改两者 。系统能力来自模型分工,以及外部协议对证据和上下文的管理。
3. Intent Channel · 把取证需求变成导航子目标
一次导航调用包含四部分:导航模式、自然语言子目标、步数预算、可选约束 。提供两个模式:
navigate_to_object:按物体或类别进行搜索与接近,对应 Object Navigation。navigate_by_instruction:按路线、区域或场景级指令移动,对应 Vision-and-Language Navigation。两个模式调用同一个导航执行器。适配器在执行过程中持续提供前、右、后、左四个 RGB 视图、位姿、已探索区域的在线地图和碰撞状态;NFM 预测短时程航点轨迹,适配器执行后再获取新观察。
默认每次调用最多执行 64 个仿真步 ,在执行器停止、预算耗尽或仿真 episode 完成时返回。连续两次碰撞会在下一次查询中加入 is_stuck,让执行器尝试恢复。导航停止后的返回结果还需要由高层结合证据判断是否满足问答需求。
4. Observation Channel · 保留旅程中的证据
导航返回包含执行状态、停止原因、路径信息、最终位姿与关键帧。默认每四个仿真步采样一次前视图,每次调用最多保留 16 帧 。
VLM 将这些记录整理为 journey artifact 五类内容:子目标及完成情况、经过的房间和路线、显著物体、门与走廊等线索、不确定性或失败情况 。
记录负面证据时要保留搜索范围:单张图像里没有看到某物,只能说明当前视角没有观察到;要据此排除一个区域,还需要足够的区域覆盖证据。
5. Memory Channel · 先保存证据,再压缩工具返回
一次问答任务的上下文状态由三部分组成:
紧凑交互历史 保留近期决策与交互脉络,帮助下一轮理解任务如何推进到当前位置。 证据记录 保存观察结论、来源、支持信息、置信度及是否仍待确认,包括已搜索区域、正面观察和有依据的负面证据。 未完成目标 记录缺失的证据、不确定的发现,以及仍需检查的区域,为下一次导航或局部观察提供目标。 每次得到 journey artifact 或辅助工具结果后,先更新证据记录和未完成目标,再压缩原始返回。
write_notebook接收简短观察,为每条内容标记来源轮次、去除规范化后的完全重复项,并按先进先出顺序最多保存 100 条记录 。Notebook 每轮都会重新放入 Agent 提示中,记录导航目标、搜过的区域、房间转换、观察结果和剩余取证需求。
这套 Memory 在同一个 episode 的多次导航调用之间持续使用,每个评测 episode 开始时重置。
6. Evidence Verification · 从“找到了灯”到“确认灯亮着”
框架图中的问题是“床旁边的灯开着吗?”。完整过程可以按下面理解:
先决定去哪取证: VLM 根据问题和初始观察判断需要检查卧室,通过意图通道发出“转身进入卧室”等导航子目标。读取沿途证据: NFM 执行移动并返回关键帧,旅程摘要记录已到达卧室、观察到床头灯,以及其状态是否清晰。把进展和缺口写入记忆: 记录“卧室已到达”“床头灯已观察到”,同时保留“亮灭状态仍待验证”,避免仅凭找到物体就提前回答。补充局部观察: Agent 可以查阅历史关键帧、进行全景检测或目标裁剪放大检查,取得更清楚的视觉依据。基于证据作答: 确认状态后给出答案,并指出支持答案的观察;若仍有缺口,就更新未完成目标并继续取证。末端核验工具 analyze_status结合当前四向视图、Notebook 与存档图像评估目标可见性和证据充分性;需要时可追加一次补充检查,再综合判断是可以回答、有足够负面证据,还是需要继续探索。达到轮次预算时,系统基于已有状态返回最有证据支持的答案。
执行流程 问题与当前状态 → 明确缺失证据 → 语义导航调用 → 闭环移动与关键帧采样 → 带来源的旅程摘要 → 更新证据与未完成目标 → 压缩上下文 → 核验、补观察或再次导航 → 作答。
评测基座 主实验:Qwen3.6-Plus + Qwen-RobotNav-8B;受控消融:Qwen3.5-397B-A17B + 相同执行器。 实验数据 HM-EQA 准确率为 76.7% ± 0.1%,MT-HM3D 为 54.4% ± 1.5%;EXPRESS-Bench 的 LLM Score 为 79.27 ± 0.44。真机在 Unitree Go2 上测试 60 个 episode,总成功率为 78.3%,超过 20 米的长时任务成功率为 60%。仿真主表衡量具身问答质量,归一化 Agent Steps 衡量交互与探索开销。 外部组件与执行 使用已有训练的导航基础模型,并配合开放词汇检测、SAM、Depth-Anything、全景观察、目标裁剪放大与关键帧回看工具。协议本身不追加训练,性能仍依赖推理模型、导航执行器和实际观测质量。 本篇结果: HM-EQA / Qwen3.6-Plus + Qwen-RobotNav-8B · MT-HM3D / Qwen3.6-Plus + Qwen-RobotNav-8B · EXPRESS-Bench / Qwen3.6-Plus + Qwen-RobotNav-8B · HM-EQA / 匹配消融 / Qwen3.5-397B-A17B + Qwen-RobotNav-8B
回到实验总表 ↑ 回到论文目录 ↑
27 HarnessVLN Harness Framework Memory Tool Create
HarnessVLN: Unifying Training-Free Embodied Navigation through an Agent Harness
2026.09 首次预印本原论文 ↗
1 · 要解决什么问题
基于 MLLM 的 Agent 架构依赖模型自身的语义推理能力:模型理解指令、识别目标并提出下一步行动。但导航会持续改变智能体的位置、可见证据和任务进度,仅有语义上合理的规划,还不足以保证行动与真实执行状态一致。HarnessVLN 围绕三个具体问题建立统一管理机制:
证据应该如何长期保存? 导航过程中见过的地点、实体、目标线索以及执行结果,需要保留其位置、时间和观测来源,供后续子目标重新检索。如果只把历史堆进提示词,上下文会持续增长,旧证据是否仍然有效也难以判断。MLLM 提出的 proposal 应该如何验证? “前往白色床边”或“在门口右转”首先是语义提案。执行前还需要确认目标有观测证据、定位与当前位姿一致、几何上可达,并且符合正在执行的子目标。看到目标不能直接证明已经到达,发出动作也不能直接证明子目标完成。当执行失败时应该如何处理? 碰撞、目标不可达、grounding 不一致、没有进展或错误停止请求,都应成为后续决策可用的反馈:既记录这次尝试发生了什么,也更新相关空间证据,支持补充观察、修正目标、回溯和重新规划。 2 · Framework:由 Harness 管理决策与执行闭环
图 1 · HarnessVLN 整体架构(论文 Figure 2)· 查看本地图 ↗ 本地图暂未加载,请检查 pic/HarnessVLN.png。
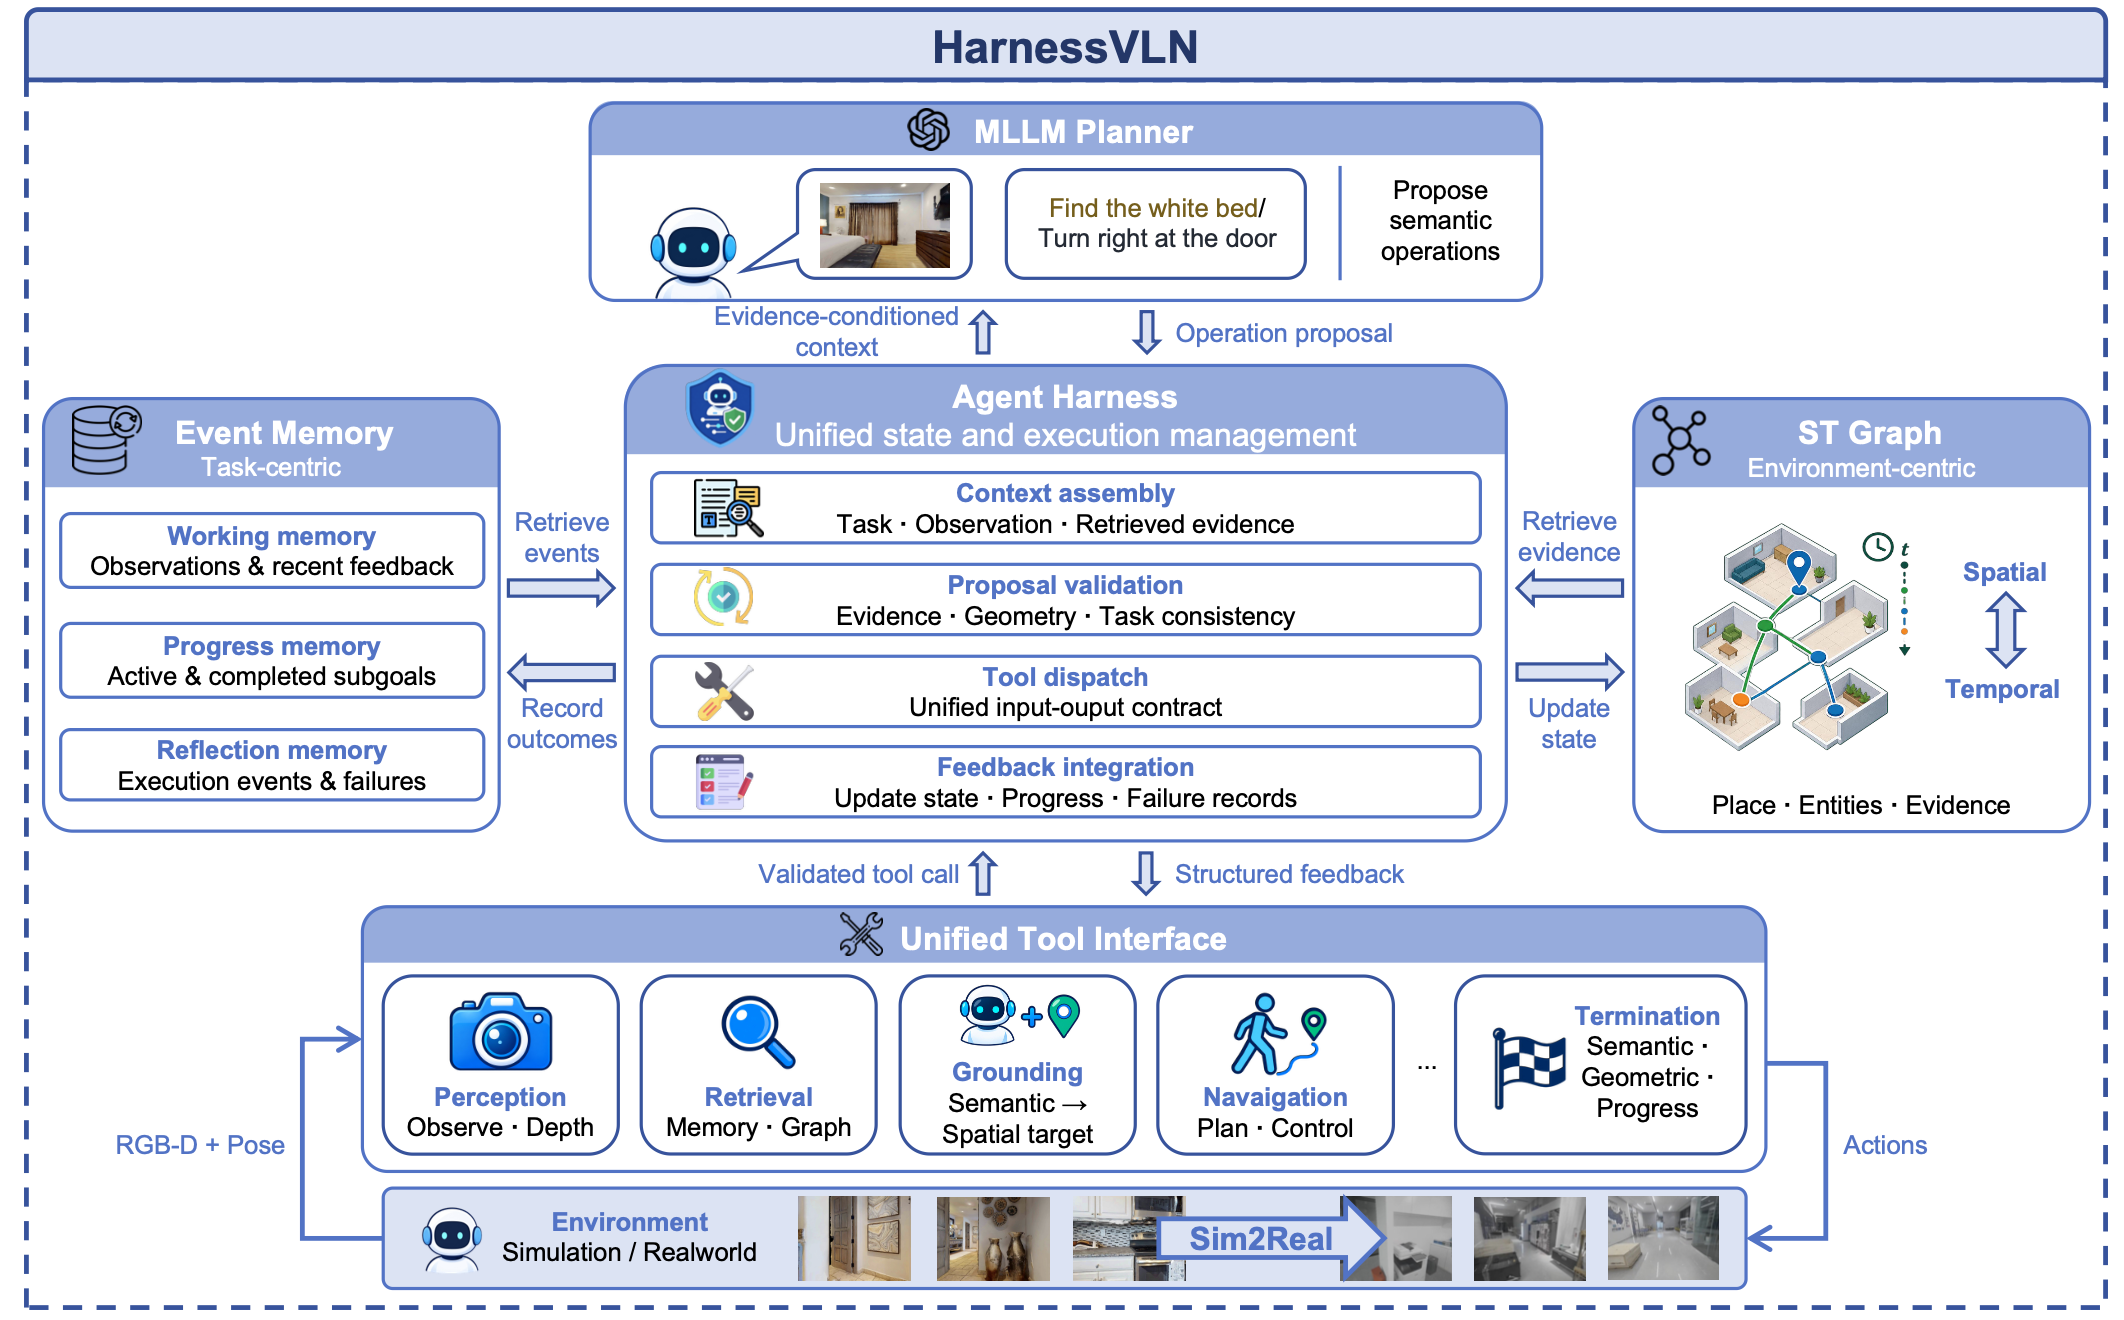
框架上层的 MLLM Planner 根据任务、当前观察和检索证据提出操作;中间的 Agent Harness 统一管理状态与执行;两侧分别保存以任务为中心的事件记忆、以环境为中心的时空图;下层通过 Unified Tool Interface 调用感知、检索、grounding、导航、恢复和终止能力。环境返回 RGB-D 与位姿,工具返回结构化执行反馈,二者共同支持下一次决策。
Context assembly · 组装上下文。 以当前任务和活动子目标为条件,汇总位姿对齐的观察、近期工具反馈,以及从事件记忆和 ST Graph 检索的证据,形成 MLLM 此刻需要的决策上下文。Proposal validation · 验证提案。 MLLM 输出候选操作后,Harness 检查工具参数、证据来源与新近性、目标的几何可行性、与活动子目标的一致性,以及适用的失败历史。验证发生在工具调度之前。Tool dispatch · 调度工具。 通过统一输入输出约定执行已验证的调用。导航执行器将已定位、已验证的目标转成路径与控制指令;工具或执行器可以替换,仍沿用同一 Harness 交互协议。Feedback integration · 整合反馈。 根据到达、碰撞、不可达或无进展等实际结果,更新观察、任务进度、事件记录和图状态,再进行下一轮规划。子目标完成必须有证据支持。
一次完整决策循环 当前任务与观察 → 检索相关证据 → 组装上下文 → MLLM 提出 proposal → Harness 验证 → 工具执行 → 结构化反馈 → 更新事件记忆与 ST Graph → 继续规划、恢复或验证停止
停止也进入同一个验证过程:request_stop 只是停止请求,只有语义、几何和任务进度 三项检查同时通过,才允许真正终止。若请求被拒绝,系统记录原因,并继续观察、修正目标、接近目标或回溯。
3 · Harness 提供哪些工具
八个工具覆盖从获取证据到验证任务完成的全过程。工具返回的执行状态、相关测量和失败证据会被 Harness 统一接收,用于更新状态。
4 · 两个核心:层次化事件记忆与时空图
两类记忆承担互补职责:层次化事件记忆(Hierarchical Event Memory) 围绕任务组织决策上下文、子目标进度和执行事件;时空图(Spatiotemporal / ST Graph) 围绕环境组织地点、实体、空间关系及带时间信息的证据。前者帮助解释“任务做到哪一步、某次执行发生了什么”,后者帮助检索“相关线索在哪里、何时看到、是否仍然适用”。
4.1 · Hierarchical Event Memory:保存任务执行过程
Working Memory。 保存当前观察、有限长度的全景历史、当前激活的目标假设,以及最近的工具反馈。它只保留下一个决策所需的短期上下文,避免随轨迹长度无限增长。Progress Memory。 表示任务分解与完成状态。每个子目标具有唯一 ID,状态为 pending(待执行)、active(执行中)、completed(已完成)或 blocked(受阻),同一时刻最多有一个活动子目标。Reflection Memory。 保存与具体子目标相关的完整执行事件,包括目标不可达、grounding 不一致、碰撞、没有取得进展、回溯失败,以及被拒绝的停止请求。每条记录包含事件标识符(event identifier)、任务上下文、位置、时间戳、工具反馈和支持观察,使后续恢复可以追溯失败发生的条件。
当一次失败具有可复用的空间含义时,Harness 会将轻量注释和原始事件引用 写入 ST Graph。完整事件仍保存在 Reflection Memory 中,图通过引用关联详细记录,避免把完整执行历史重复保存一遍。
4.2 · ST Graph:组织可检索的长期空间证据
ST Graph 跨子目标持续维护,是能够按当前任务查询、又会随执行结果更新的空间记忆。它把导航历史整理为结构化的地点、实体与证据关联,保留观察的时间和来源,支持重新规划及回溯。
$$\mathcal{G}_t=\bigl(\mathcal{V}_t^P\cup\mathcal{V}_t^E,\mathcal{E}_t,\mathcal{T}_t\bigr)$$ G t = ( V t P ∪ V t E , E t , T t )
$$\mathcal{V}_t^P$$ V t P Place nodes,汇总访问过的位置、支持观察和可通行航点。空间兼容的观察合并到已有地点,否则创建新节点。
$$\mathcal{V}_t^E$$ V t E Entity nodes,表示目标物体或指令提及的地标,保存语义别名、空间假设、置信度与支持视图。
$$\mathcal{E}_t$$ E t 带类型的关系:NavigableTo 连接可通行地点,支持前进与回溯;Contains 表示粗粒度的地点—实体关联;ObservedFrom 保留实体被观察的视点与时间来源。
$$\mathcal{T}_t$$ T t 保存时间戳及轻量事件注释,帮助区分当前证据与过时假设,并关联完整的事件记忆。
便于理解的结构示例
$$\text{Place A}\leftrightarrow\text{Place B}\leftrightarrow\text{Place C}$$ Place A ↔ Place B ↔ Place C
$$\text{Place B}\rightarrow\{\text{door},\text{chair},\text{bed}\}$$ Place B → { door , chair , bed }
地点之间记录通行关系,实体关联其支持观察,相关失败则带着时间、适用条件及原事件引用挂到相应地点、实体或关系上。
Task-Conditioned Retrieval · 当前任务决定召回哪些经验。 综合语义相关性、新近性、空间显著性以及适用失败的惩罚,对地点排序,再补充邻近节点及相关实体、航点和关系。最终提供紧凑的证据集合,使图可以积累更多经验,而每次送给 MLLM 的上下文仍然受控。
Failure-Aware Update · 执行结果改变后续检索。 可复用的失败被挂接到对应地点、实体或关系;注释保留子目标条件、失败类型、时间戳、适用权重及完整事件引用。当子目标变化或新证据推翻先前失败时,其影响减弱;一致的失败反复发生时,其影响增强。因此,一次失败需要结合条件解释,不会自动把某个地点永久判为不可用。
两者通过事件引用协同:事件记忆保留执行详情,ST Graph 提供空间检索入口 。本页所说的“长期”指跨决策、跨子目标持续保留空间证据,不据此推定存在跨测试 episode 的终身经验库。
评测基座 GPT-5.5 实验数据 Open nav 中R2R采样的 100 条 外部工具调用 平面导航使用 FMM,楼梯技能调用已训练的 NavDP,目标定位依赖 GroundingDINO/SAM 等预训练组件 本篇结果: R2R-CE / GPT-5.5 · RxR-CE / GPT-5.5
回到实验总表 ↑ 回到论文目录 ↑
28 GPT-6-Astra VLN Evaluation Harness Framework
GPT-6-Astra Lights Up Embodied Navigation: Evaluation in Zero-Shot Vision-and-Language Navigation in Continuous Environments
2026.09 首次预印本原论文 ↗
一句话点评 瘫坐眩晕,Astra征服了VLN这个低垂领域
1. 需要解决的问题
一个足够强的通用多模态模型,只拿到第一视角图像和最基础的移动工具,能把连续环境里的语言导航做到什么程度?
这篇报告关注通用模型本身的导航能力:理解多阶段指令、从图像中识别地标与空间关系、判断执行进度、发现走错后调整路线,以及在目标位置停止。作者沿用极简 Harness 评测设置,把这些决策交给 GPT-6-Astra,在 R2R-CE 上直接检验其表现。
2. Framework · Codex Harness + MCP + Simulator
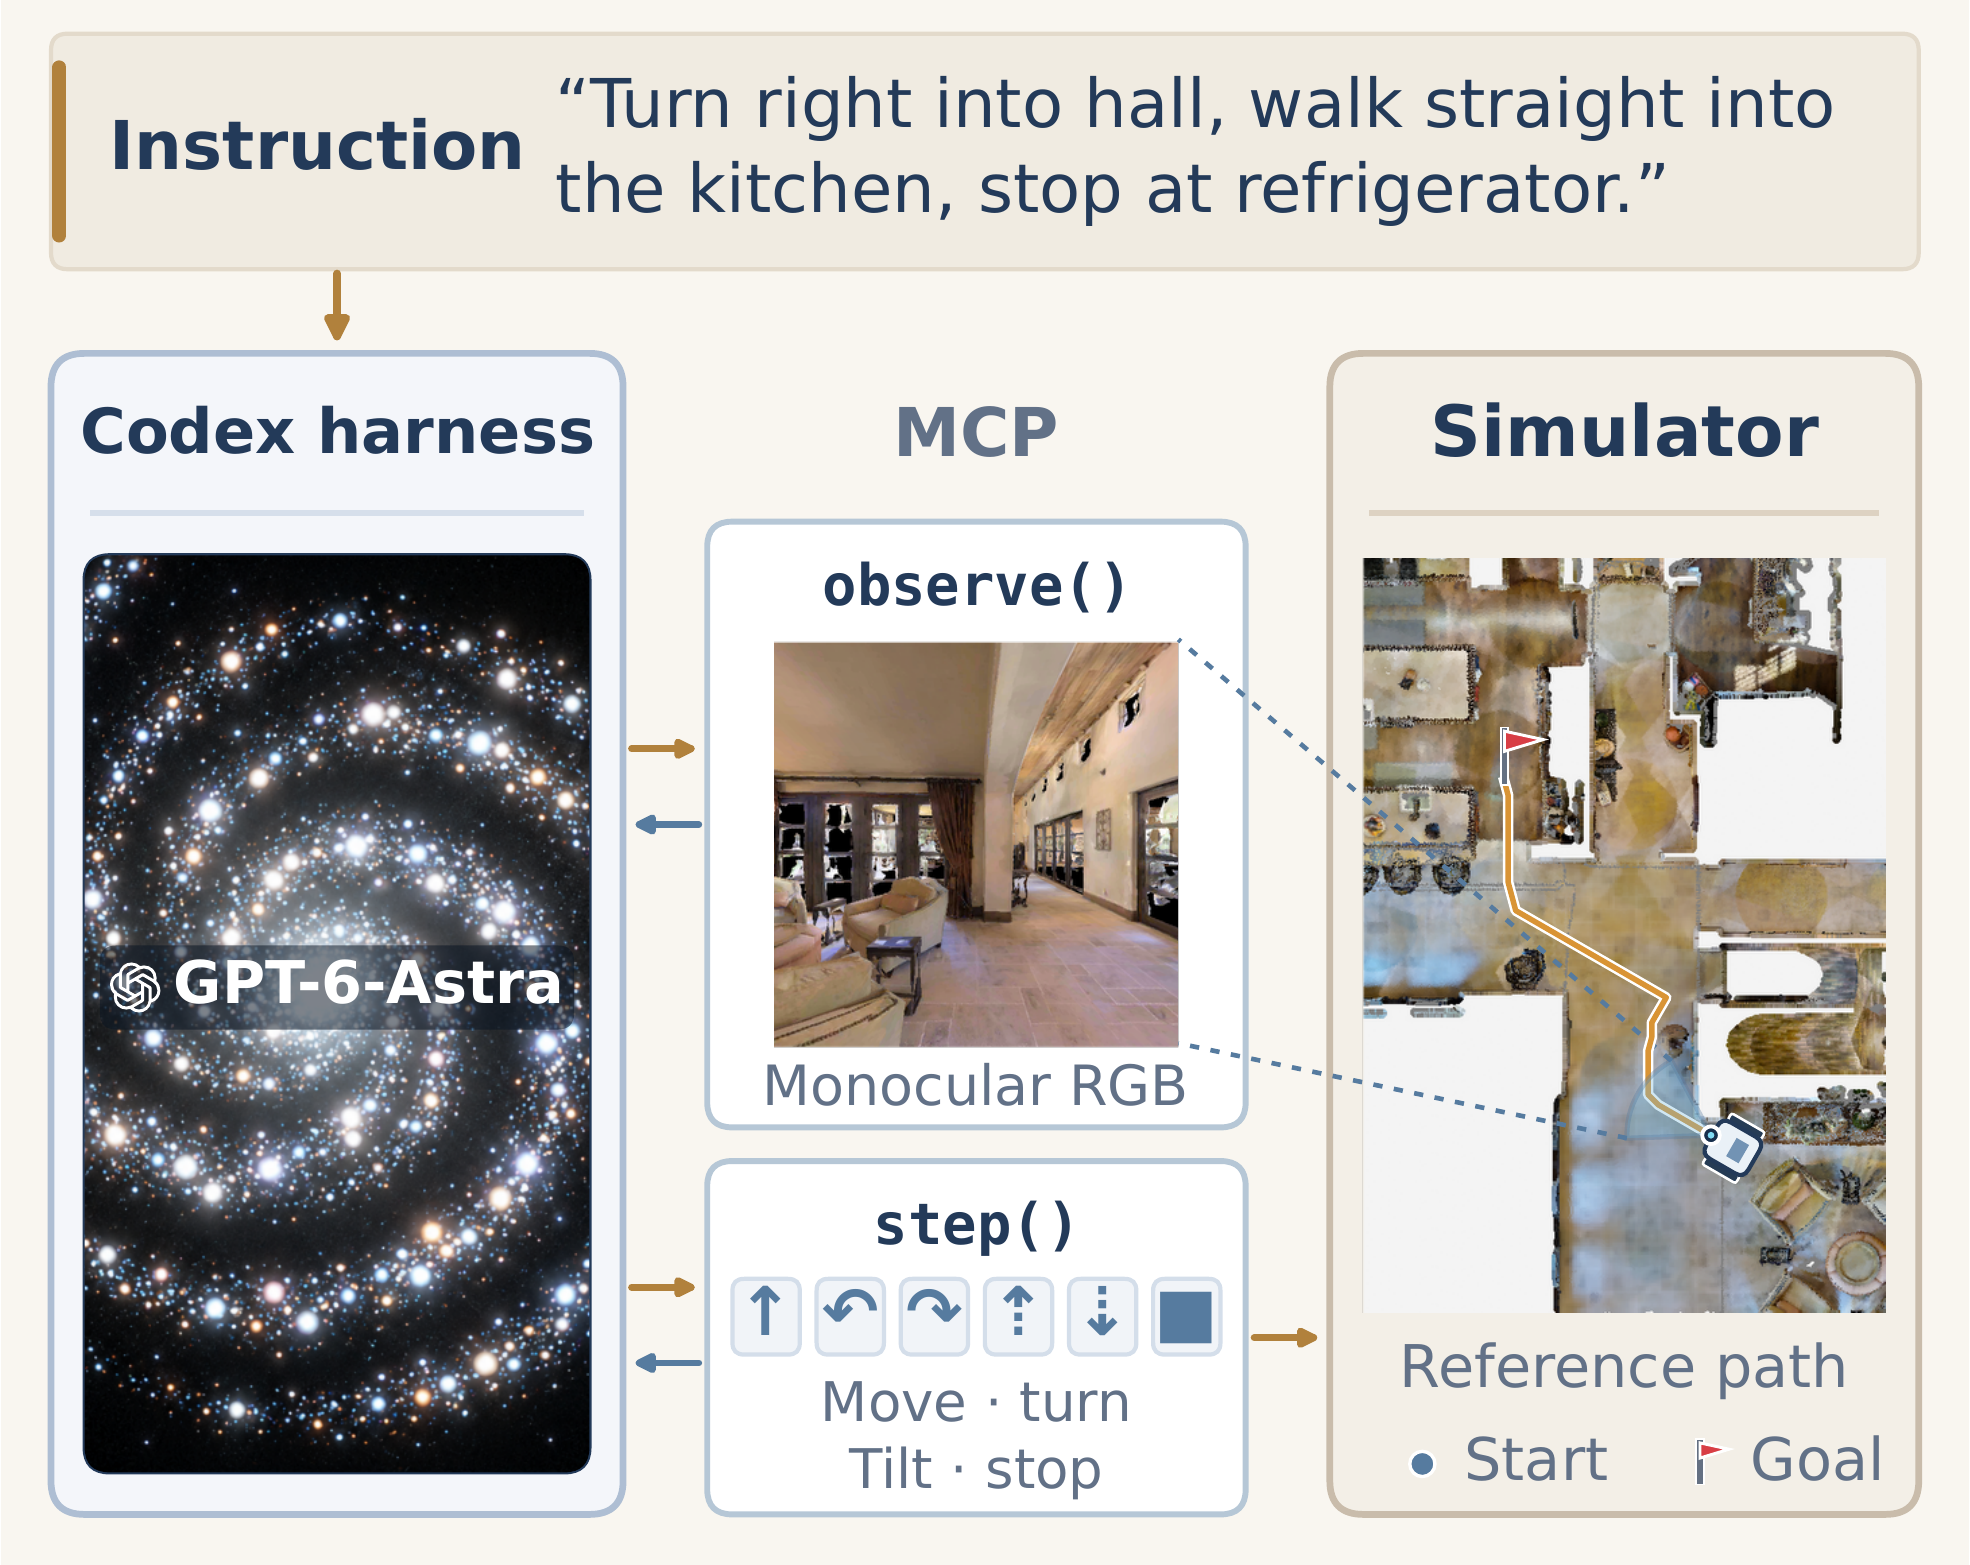
Figure 2 · 通用模型通过观察与动作接口直接导航。右侧 Reference path 为任务示意,参考路线、地图和目标坐标不作为模型输入。 图片暂未加载,请通过图片链接查看。
GPT-6-Astra 负责感知、推理和导航决策;Codex Harness 维持持续会话;MCP 将工具调用接到模拟器。 每个 episode 内,模型结合指令、已获得的图像和交互记录,决定下一次观察、动作序列与停止时机。
因此这里的 Harness Framework 重点在于让模型持续与环境交互:工具提供观察和动作能力,模型自己组织“看—想—走—再看”的过程。
3. 具体 Method · 用两个工具形成导航闭环
4. 自主交互 · 何时看、走多远、何时回退
结合指令读取观察: 识别当前房间与地标,判断自己可能处在指令的哪一阶段,并决定接下来要找的方向或出口。自主组织动作序列: 一次 step(actions) 可以包含多个基础动作,模型决定先转多少次、再前进多少步。再观察并修正判断: 调用 observe() 查看新画面,将实际变化与预期路线比较;必要时追加观察、改变前进方向或返回之前的位置。判断是否到达并停止: 根据当前视图和走过的路线判断是否满足指令,在认为完成时主动输出 STOP。执行流程 指令与持续会话 → observe 获取 RGB → 判断地标与执行进度 → step 执行动作序列 → 再次 observe 检查变化 → 继续前进、调整路线或回退 → STOP。
评测基座 GPT-6-Astra,medium/ultra reasoning;每个 episode 使用持续的 Codex 会话。 实验数据 R2R-CE val-unseen 的 Open-Nav 100 条任务,覆盖 10 个场景,每档设置重复三次。Medium:SR 75.7% ± 1.5%、SPL 65.6% ± 2.1%;Ultra:SR 81.3% ± 2.5%、SPL 71.5% ± 1.7%。均为三次运行的均值 ± 样本标准差。 外部组件与执行 Codex Harness 维持会话,MCP 对接观察与动作工具,模拟器执行原语动作并返回状态。本文提供的是导航能力评测,未引入新的导航训练方法。 本篇结果: R2R-CE / GPT-6-Astra / medium · R2R-CE / GPT-6-Astra / ultra
回到实验总表 ↑ 回到论文目录 ↑