VLN Voyager / PART 02
端到端VLN
梳理 25 篇 LLM / VLM 驱动的导航模型,逐篇拆解架构、动作输出与训练流程,结合 74 条原文实验记录区分训练边界与评测协议。支持搜索筛选、指标排序及数据导出。
shong Tan中文笔记 · 论文调研
E2E_VLN_PAPER · TRAINABLE NAVIGATION MODELS
LLM / VLM 驱动的
端到端 VLN 模型目录
聚焦需要训练或微调导航策略的视觉语言大模型:从输入、模型主干到动作输出,逐篇拆解“训练什么、怎样训练、能否自己训练”。保留少量早期图导航作为架构脉络,重点覆盖 2025—2026 年的连续环境与机器人导航工作。
25 篇模型 / 工作 · 74 条原文实验记录 · 12 篇已核实训练入口 · 最近增补:2026-10-09
先明确这里的“端到端”
模型训练 ≠ 所有参数从零训练
本页按“存在针对导航任务的可学习策略或动作头”收录。LLM / VLM 通常从预训练权重开始;冻结视觉编码器、分阶段训练、外接低层控制器都很常见。表中的架构分类是阅读归纳,不代表作者对 E2E 的统一定义。
直接动作 / 轨迹
VLM 生成动作 token,或通过学习的动作头输出路点。连续环境中执行离散动作,也属于此类。
分层 / 双系统
语言规划与高频动作分工;中间通过指令、像素目标或潜在表示连接,需分别检查训练方式。
导航图策略
在给定或构建的导航图中选下一节点。保留 NaviLLM、NavGPT-2 作为早期 LLM 架构参照。
地图中间表示
以显式地图连接感知和决策;地图可能来自几何管线,也可能由网络学习生成。
这是面向自训练选题的代表性目录,并非穷尽论文清单。TrackVLA 的目标跟随,以及 VLingNav 的 ObjectNav / ImageNav / 跟随任务,作为相关具身导航工作收录,与传统路线指令导航分别标注。ABot 在本页指导航模型 ABot-N0 / N1;ABot-AgentOS 属于另一类系统工作。
模型与训练总览
25 / 25 篇
点击模型进入逐篇解析。左侧绿线标出本次重点补充的三个模型。
多个关键词和方法标签按“同时满足”筛选;同时作用于总览、实验表和逐篇正文。侧边目录始终可检索全部论文。
训练入口已公开部分开放未发布(官方说明)训练开放未核实
没有符合条件的模型。试试减少关键词或清除筛选。
“训练入口已公开”表示已核实训练脚本或文档,不保证全部训练阶段、数据、权重、算力条件均已具备,也不代表已实测复现;具体缺项见各篇说明。“未核实”不等于闭源。
原文实验对照
74 条记录
本表是论文自报结果的索引,不是统一复测排行榜。比较前先对齐 benchmark、split、视觉输入、外部训练数据和模型变体。R2R graph、R2R-CE、LH-VLN 与 TrackVLA 的目标跟随任务分别记录;同一模型的多视角和单目结果分列。
SR、SPL、OSR、nDTW 为百分制(%),NE 为米;不同任务的 SR 成功条件不同。目标跟随的 TR / CR 等专属指标见协议栏。“—”表示不适用、本次未摘录或原表未报告。点击指标表头排序,缺失值始终排在最后。
当前模型筛选与实验条件下没有记录。可分别清除模型筛选和结果筛选。
默认展示 R2R-CE。模型筛选同样作用于此表;CSV 导出保留当前筛选及排序。
- 基座 / 规模
- EVA-CLIP-02-Large + 多视图 Transformer + Vicuna-7B;语言骨干 7B;视觉骨干约 428M;完整可训练参数量未核实
- 输入
- 指令、候选视点 RGB 特征、方向和位置编码、历史观察;定位任务另含物体特征。
- 动作输出
- 候选视点编号或停止;兼容物体编号、轨迹描述和问答文本。
- 训练数据
- R2R、REVERIE、CVDN、SOON、ScanQA,辅以导航扩增数据及 LLaVA-23k。
要解决什么问题
传统 VLN 各任务独立设计动作头,难以共享导航、物体定位和语言理解能力。
设计思路基于论文的阅读归纳
把任务、当前观察、历史和输出提示组织为统一 schema,使不同具身任务都成为同一个语言模型的序列生成问题。
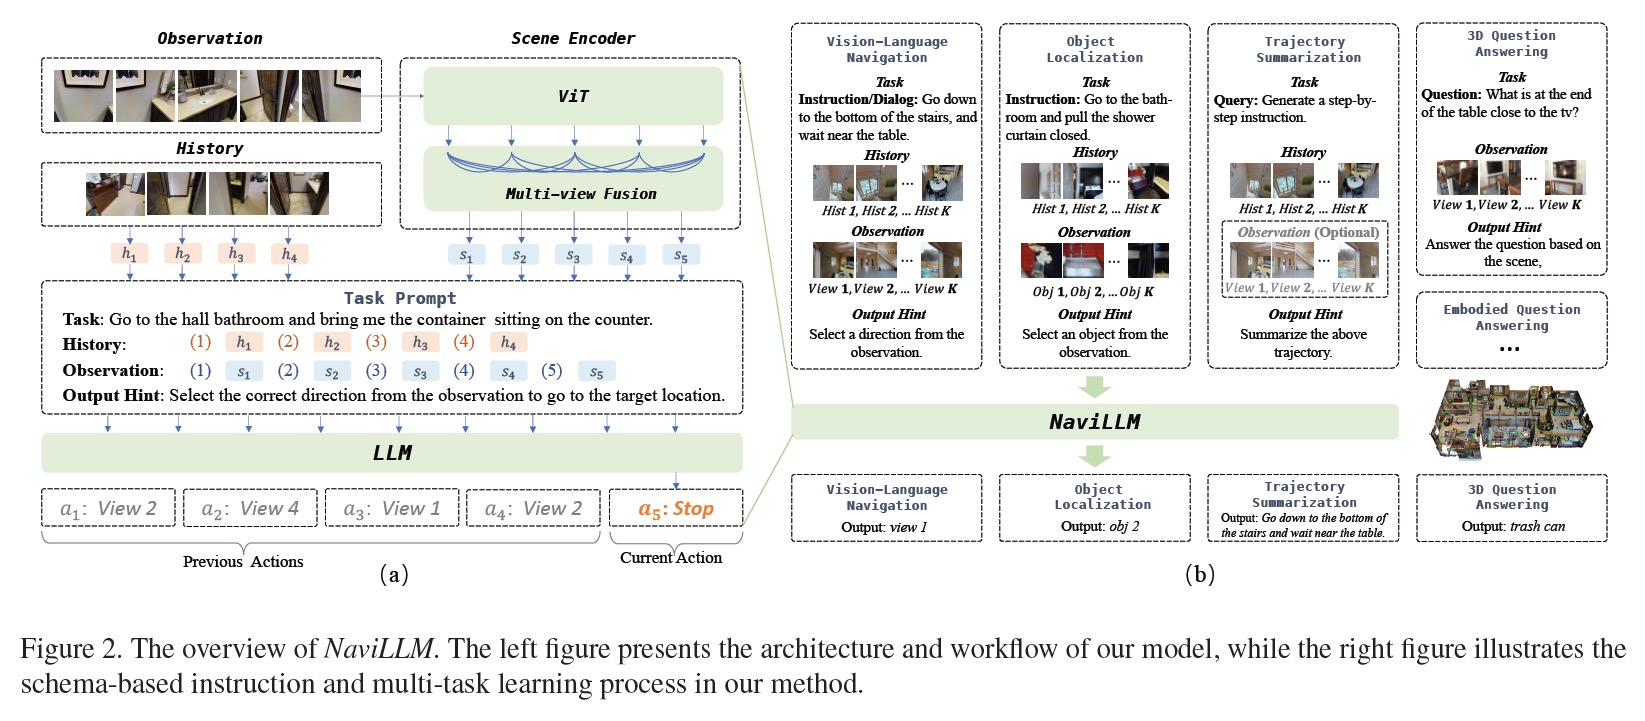 官方仓库方法图:任务 schema、多视图观察与历史输入统一语言模型。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 多视图融合 Transformer、视觉语言连接部分与语言模型;以交叉熵学习任务输出。
- 冻结 / 固定部分
- 预训练视觉编码器及预提取的物体视觉特征;并非从像素开始更新全部网络。
训练流程
- 预提取视觉特征,把导航、定位、轨迹总结和问答整理为共同的输入输出格式。
- 以专家轨迹进行教师强制预训练,学习观察、历史与文字输出之间的对应。
- 多任务微调交替使用专家轨迹与模型自身执行轨迹,减轻测试时的状态分布偏移。
推理时怎样行动
- 读取当前全景候选视点,编码方向与位置,并更新已访问观察的历史。
- 将任务 schema 和多模态特征输入语言模型,生成下一视点编号或停止。
- 仿真器按导航图执行视点转移;下一时刻重新观察并循环。
端到端边界:这是可训练的离散导航图策略;输出编号并不等于直接控制连续空间中的机器人,低层避障和运动控制未包含在模型内。
训练开放情况与复现限制
训练入口已公开
公开预训练、多任务微调、数据处理与权重。仓库明确纠正论文版本:复现应使用 Vicuna-7B-v1.1,旧版 v0 会降低成绩。
依赖候选视点与预提取特征;多任务和扩增数据量影响对比,不能把 R2R 图环境结果与 VLN-CE 混排。
查看本篇 2 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- LLaMA-VID 风格:EVA-CLIP + 文本查询编码器 + Vicuna-7B;语言骨干 7B;整体与可训练参数量未核实
- 输入
- 单目 RGB 当前帧、历史视频与自然语言指令;不需要深度、里程计或预建地图。
- 动作输出
- 包含前进距离、转向角度或停止的动作文本,解析后执行。
- 训练数据
- 原论文用 R2R:约 32 万专家动作、18 万 DAgger 动作、1 万轨迹总结样本,并混合 76.3 万网络视觉语言样本。
要解决什么问题
地图和候选航点引入额外假设,而逐帧图像模型难以理解长程指令对应的行进过程。
设计思路基于论文的阅读归纳
把整段导航作为视频语言建模;同时保留指令相关特征与通用视觉特征,并对历史帧采用更强压缩,直接预测下一动作。
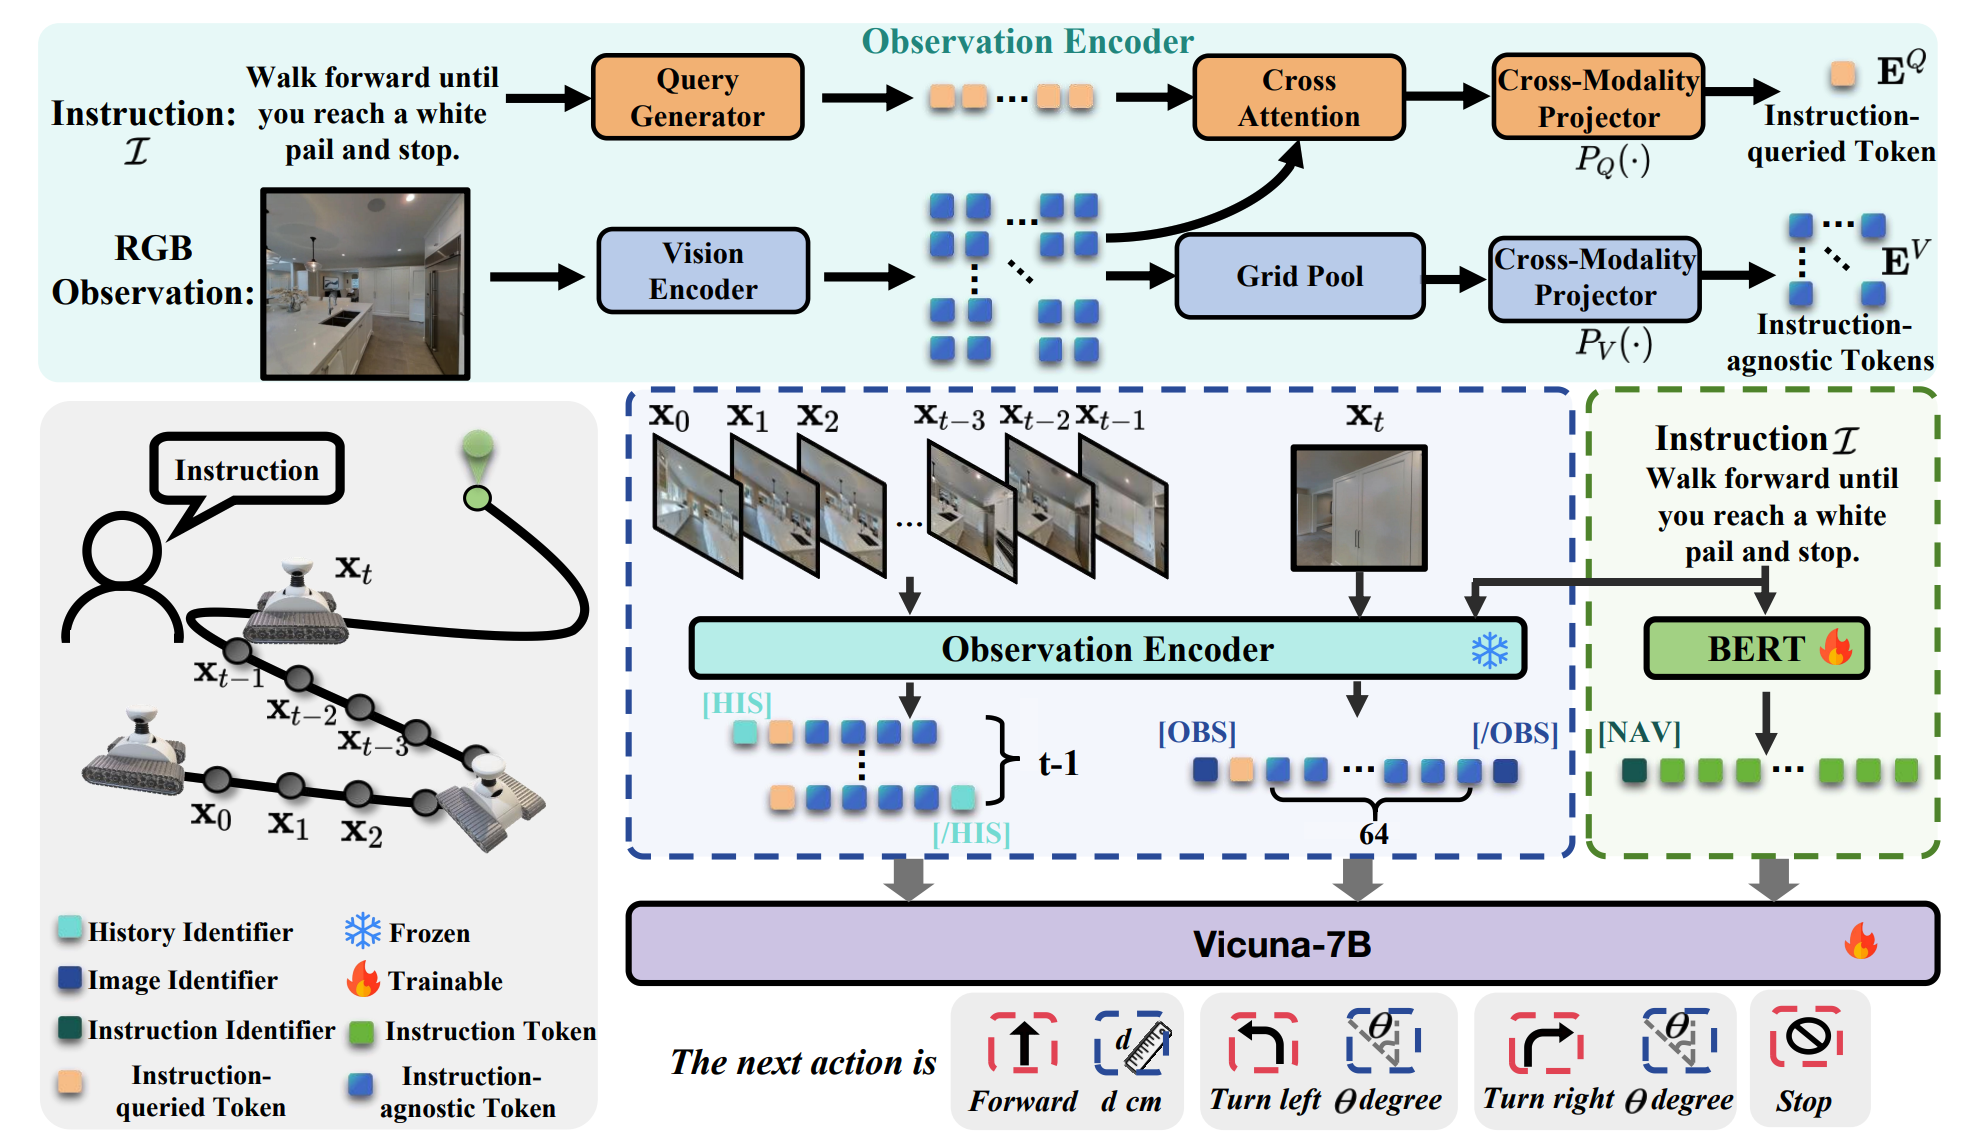 官方方法图:视频历史、当前观察与指令输入模型,生成可解析导航动作。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 论文明确优化语言模型及文本编码部分;未把未核实的连接层冻结细节补写为事实。
- 冻结 / 固定部分
- 预训练视觉主干保持固定;模型不是视觉和语言所有参数均从头训练。
训练流程
- 以预训练视频语言模型初始化,将专家导航轨迹转为视频到动作监督。
- 运行当前策略并收集偏离专家路线后的纠正样本,补充训练状态。
- 联合动作、轨迹总结和通用视觉语言数据进行监督微调,保留视觉语义能力。
推理时怎样行动
- 编码当前帧与历史,当前图像保留较细粒度特征,旧帧压缩为少量 token。
- 按历史、当前观察和导航任务标记组织上下文,语言模型生成动作文本。
- 解析动作并执行,追加新观察后再次生成,直到输出停止。
端到端边界:端到端指 RGB 与指令到导航动作;仿真动作执行器或机器人底层控制仍在模型之外,也不意味着直接预测关节力矩。
训练开放情况与复现限制
部分开放
官方仓库主要开放 VLN-CE 评测与推理。当前权重按后续 Uni-NaVid 配方重训,不能与原 RSS 论文训练数据及成绩等同;原版完整训练入口未核实。
长历史仍消耗上下文;原始训练复现开放程度有限,现有仓库新权重与论文主表必须分开标注。
查看本篇 2 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- EVA-CLIP ViT-g/14 + InstructBLIP Q-Former + FlanT5-XL/XXL + DUET 风格图策略;主结果为 5B 导航配置;完整 FlanT5-XXL 为 11B,导航只使用编码器,另有 1.5B 配置
- 输入
- 语言指令、候选 RGB 观察与朝向、在线维护的拓扑图和访问历史。
- 动作输出
- 图节点得分与停止决策;语言分支可生成局部导航理由。
- 训练数据
- 约 1 万条由 GPT-4V 生成的 R2R 推理样本;策略使用 R2R,最佳主行另含 PREVALENT 扩增。
要解决什么问题
直接提示大模型导航的成功率落后于专用策略;仅把视觉转成文字又会丢失细节。
设计思路基于论文的阅读归纳
先将视觉观察对齐到冻结语言模型的推理空间,再把其隐状态交给可训练图策略,同时保留自然语言解释能力。
 两阶段训练架构:视觉语言对齐后,由独立图策略产生导航动作。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 第一阶段训练 Q-Former 和投影层;第二阶段固定视觉语言部分,训练导航图策略。
- 冻结 / 固定部分
- 视觉编码器与 FlanT5 始终冻结;策略训练时也冻结第一阶段学到的视觉语言连接部分。
训练流程
- 从 R2R 观察与专家动作生成带理由的视觉指令数据。
- 通过生成监督调整 Q-Former,使冻结语言模型能够理解导航观察。
- 以导航模仿学习训练图策略,学习探索、回退与停止;两阶段分别优化。
推理时怎样行动
- 编码指令与当前候选视图,提取语言模型内部的多模态表示。
- 更新已访问和待探索节点,以图策略选择下一个目标节点。
- 沿导航图中的路径执行转移,重新观察;语言理由可单独解码。
端到端边界:不是语言模型直接生成连续动作;实际导航依赖可训练图策略和图上的路径执行。解释文本与最终策略动作没有严格的一致性保证。
训练开放情况与复现限制
训练入口已公开
公开视觉指令调优、导航策略微调脚本、推理数据和检查点;README 中保留的 TODO 不代表训练代码尚未开放。
使用预定义离散可通行关系;语言分支的局部解释不等同于具备完整历史推理,且最佳成绩包含额外扩增数据。
查看本篇 2 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- VILA-1.5:SigLIP + 连接器 + Llama-3-8B;另配视觉运动策略;高层 VLA 为 8B 级;低层策略参数量未核实
- 输入
- 高层接收指令与 RGB 视频;真实足式机器人低层另需地形高度图和本体状态。
- 动作输出
- 高层生成带距离或角度的中层运动指令,低层输出关节控制目标。
- 训练数据
- R2R、RxR、EnvDrop 导航样本,人类游览视频及动作标注,并混合 ScanQA 等通用视觉语言数据;低层使用地形仿真。
要解决什么问题
语言理解需要大模型,但复杂地形上的稳定行走需要高频闭环,两者计算频率与训练信号不同。
设计思路基于论文的阅读归纳
用动作语言作为接口,连接低频的视觉语言导航决策与高频的强化学习运动策略,使机器人既理解指令又能跨地形移动。
 论文分层框架:VLA 输出中层动作,再由独立运动策略驱动足式机器人。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 导航 SFT 更新视觉编码器、连接器与语言模型;运动策略在独立的机器人仿真任务中学习。
- 冻结 / 固定部分
- 前置对齐阶段冻结视觉与语言骨干;最终导航微调并非始终冻结主干,上下层没有联合反向传播。
训练流程
- 从 VILA 预训练模型初始化,将导航轨迹和人类视频整理为中层动作监督。
- 联合导航与通用任务微调高层模型,学习距离、角度和停止预测。
- 在随机化地形与物理条件下,以强化学习单独训练跟踪速度指令的运动策略。
推理时怎样行动
- 从历史中采样视频帧,保留起点和当前观察,结合语言指令生成中层动作。
- 将动作文本转换为可执行的速度及持续运动目标。
- 低层依据地形和本体状态高频执行,高层在获得新视频后继续规划。
端到端边界:这是可训练的分层系统。高层只用 RGB 不代表整个机器人只用 RGB;端到端导航监督也不等于语言到关节的统一联合训练。
训练开放情况与复现限制
训练入口已公开
公开导航 SFT 脚本、权重与训练标注;低层另见官方 legged-loco 仓库。人类视频提供链接和标注,原视频及部分渲染数据需自行准备。
部署依赖匹配机器人的运动策略和传感器;高层响应频率较低,未知地形与语义决策错误仍可能影响任务成功。
查看本篇 2 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- EVA-CLIP + 两层 MLP + Vicuna-7B;语言骨干 7B;完整模型参数量未核实
- 输入
- 单目 RGB 视频流与指令,统一覆盖 VLN、目标导航、具身问答和跟人任务。
- 动作输出
- 一次预测四步动作:前进 25 cm、左转或右转 30°、停止;问答任务生成答案。
- 训练数据
- 360 万导航样本,其中 VLN 约 240 万,来自 R2R-CE/RxR-CE;另含目标导航、问答、跟人,以及 230 万视觉语言样本。
要解决什么问题
各导航任务分别训练会浪费共享知识,而视频历史不断增长又使大模型难以实时闭环。
设计思路基于论文的阅读归纳
把任务统一为视频语言动作序列,以在线 token 合并形成当前、短期、长期记忆,并通过多步动作预测减少等待。
 官方架构图:在线视频 token 合并后,统一语言模型预测动作或问答结果。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 视觉到语言的投影层与语言模型;不同预训练阶段开放的参数范围不同。
- 冻结 / 固定部分
- 视觉编码器冻结;池化和相似度合并为确定性操作。
训练流程
- 先以图像问答完成视觉连接器对齐,建立视觉到语言的输入接口。
- 以视频问答训练投影层和语言模型,使其理解时序观察。
- 联合专家、DAgger 和多任务导航数据监督动作序列,同时混入通用视觉语言数据。
推理时怎样行动
- 新帧编码为当前观察,旧帧逐渐移入短期和长期记忆。
- 分别保留每帧 64、4、1 个 token,再合并相似的长期 token。
- 结合指令生成四步动作,滚动更新视频记忆;需要回答时输出自然语言。
端到端边界:VLN 是模型覆盖的四类任务之一;在连续环境执行离散小步动作,既不依赖导航图,也不直接产生机器人关节控制。
训练开放情况与复现限制
训练入口已公开
公开阶段训练脚本和小规模数据子集;完整 360 万导航样本并未整体公开,部分 ObjectNav 内容受第三方许可影响。评测在独立 VLN-CE 仓库。
长程压缩可能丢失细节,多步动作在动态环境中存在反馈延迟;完整训练数据的开放程度限制逐项复现。
查看本篇 2 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- LLaVA-OneVision:SigLIP-so400m + Qwen2-7B-Instruct;外接语义分割与建图;语言骨干 7B;地图、分割及完整系统参数量未核实
- 输入
- 指令、当前 RGB、标注语义地图,最佳主行加两帧历史;建图还依赖深度与位姿。
- 动作输出
- 可解析的导航动作文本;语义地图作为记忆输入而非候选导航图。
- 训练数据
- R2R/RxR 专家轨迹、DAgger 纠偏与碰撞恢复样本,混合图像、视频和多图问答;论文不同段落总量口径不一,未合并成单一数字。
要解决什么问题
原始视频记忆随路线增长,难以同时保留空间布局和处理长历史。
设计思路基于论文的阅读归纳
将历史投影为带物体文字标注的语义地图,显式记录空间、轨迹和已探索区域,让视觉语言模型同时阅读当前画面与地图。
 论文方法图:构建带文字标注的语义地图,再与观察和指令共同输入视觉语言模型。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 地图与观察的投影连接层,以及语言模型;以动作生成交叉熵监督。
- 冻结 / 固定部分
- 视觉编码器固定;语义分割使用预训练模型,几何投影、地图更新和文字标注不是联合可微学习。
训练流程
- 从专家轨迹产生 RGB、地图、指令和目标动作,建立初始监督策略。
- 让策略在仿真中执行,收集偏离路线后的专家纠正与碰撞恢复样本。
- 冻结视觉主干,联合动作和通用视觉语言数据微调连接器与语言模型。
推理时怎样行动
- 分割当前画面,结合深度和位姿反投影,更新障碍、语义和轨迹图层。
- 在地图上生成物体文字标注,与当前 RGB 及可选历史图像共同编码。
- 语言模型依据指令生成动作,执行后继续更新地图与观察。
端到端边界:策略直接输出动作,但整个系统含外部几何建图。主表中的 RGB 标记不能解释为纯 RGB:地图构建实际使用 RGB-D 与位姿。
训练开放情况与复现限制
部分开放
公开语义地图生成、推理与数据入口;训练说明要求自行构建问答并调用 LLaVA-NeXT,未核实完整 MapNav 专用训练流水线。
深度、定位和分割错误会累积进入记忆;地图压缩也会损失外观细节,完整训练复现还需补齐数据组织和脚本。
查看本篇 2 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- EVA-CLIP + 两层 MLP 投影 + Vicuna-7B + 基于轨迹锚点的 Diffusion Transformer;语言骨干 7B;主模型动作头 89M;全模型参数量未核实
- 输入
- 描述跟随目标的语言指令、第一视角 RGB 当前帧与 32 帧历史窗口;识别分支接视频问答。
- 动作输出
- 含 10 个 (x, y, θ) 航点的短时轨迹;识别分支输出文字答案。
- 训练数据
- 约 1.7M 跟随与识别样本;跟随数据来自 EVT-Bench 的 703 个训练场景,识别数据结合 SYNTH-PEDES 人物描述与公开视频问答。场景和人物与测试集分开。
要解决什么问题
目标被遮挡或混入相似行人时,独立检测器与规划器容易累积错误;离散动作也难适应快速跟随。
设计思路基于论文的阅读归纳
识别问答与轨迹规划共享同一个 LLM,分别连接语言头和扩散动作头,使目标辨识知识参与连续运动预测。
 官方项目方法图:共享视频语言骨干,识别语言头与轨迹扩散头并行。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 先训练视觉投影;随后联合更新投影、Vicuna 与扩散动作头,以文字交叉熵、轨迹 MSE 和锚点分类 BCE 学习。
- 冻结 / 固定部分
- EVA-CLIP 全程冻结;首阶段仅对齐投影层,LLM 在第二阶段参与训练。
训练流程
- 用图像—描述数据对齐视觉投影与语言空间,保留预训练视觉和语言知识。
- 构造目标跟随专家轨迹与识别问答,并对专家轨迹聚类,形成 40 个轨迹锚点。
- 混合两类任务训练一轮;动作头学习锚点去噪、轨迹回归和候选评分,语言头学习识别答案。
推理时怎样行动
- 把当前帧保留为较细视觉 token,将历史帧压缩,并加入指令与 [Track] 标记。
- LLM 生成一次隐藏状态;动作头执行两步 DDIM 去噪,选得分最高的候选轨迹。
- 控制器跟踪航点,并用新图像闭环更新;真机另用位姿进行 pure-pursuit 控制。
端到端边界:属于语言条件的具身目标跟随,与 R2R 指令到达任务分列。模型直接预测轨迹,但真机附加 pure-pursuit 控制及 LiDAR/elastic-band 避障;完整执行系统不能统一称为仅 RGB 或直接电机控制。
训练开放情况与复现限制
部分开放
截至 2026-10-09,官方仓库公开 EVT-Bench、仿真与基线评测,并提供 Uni-NaVid 接入说明;尚未核实到 TrackVLA 自身训练代码、权重和完整 1.7M 训练集的发布入口。部分开放指基准,不代表原模型已可直接重训。
模型训练链路尚不能由官方仓库直接完整复现。跟随成功率衡量持续追随目标,不能与 R2R-CE 到达成功率混排;此处收录原版,不混用 TrackVLA++。
查看本篇 3 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- Qwen2-VL;2B / 7B
- 输入
- 指令+第一视角 RGB 历史;长短期混合采样
- 动作输出
- 未来 6 个离散动作:前进、左转、右转、停止
- 训练数据
- VLN-Ego:约 630K R2R 与 1.2M RxR 动作级样本;RFT 使用约 20K 样本。样本不是独立完整轨迹。
要解决什么问题
直接模仿专家动作能学会基本导航,但还需要奖励信号改善动作序列的一致性。
设计思路基于论文的阅读归纳
在同一 VLM 上先做动作文本监督,再用组内相对奖励优化;奖励对较近的未来动作赋予更大权重。
输入指令+第一视角 RGB 历史;长短期混合采样
→
模型主干Qwen2-VL
→
输出未来 6 个离散动作:前进、左转、右转、停止
流程为阅读摘要;完整结构请见原论文。
自己训练时,需要更新哪些模块
- 可训练部分
- 导航 VLM 的 SFT 与 GRPO 强化微调参数;逐层冻结范围本次未核实。
- 冻结 / 固定部分
- 未核实具体冻结列表,不将其表述为所有模块均更新。
训练流程
- 在 Habitat 中把专家路径转换为观察历史与未来动作文本。
- 以交叉熵进行 SFT,使 Qwen2-VL 学会动作序列格式。
- 用 GRPO 和时间衰减奖励做 RFT;比较多个候选动作序列与监督目标。
推理时怎样行动
- 组合近期与远期 RGB 帧和导航指令。
- 自回归生成最多 6 个原语动作。
- 在环境执行、获得新观察,再预测下一段直到 STOP。
端到端边界:输出是连续环境中的离散原语,不是连续速度或关节控制。RFT 的动作匹配奖励与完整环境多轮在线 RL 应分开理解。
训练开放情况与复现限制
部分开放
官方已发布 VLN-Ego 数据与生成代码;README 仍将 VLN-R1 的 SFT、测试、RFT 列为进行中。仓库中 GPT4Scene 的训练代码不能等同 VLN-R1 完整代码。
适合研究 SFT→RFT;公开仓库的训练链路尚不完整。这里保留论文原表结果,不沿用摘要的泛化 SOTA 表述。
查看本篇 2 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- LLaVA-Video / Qwen2-7B;7B
- 输入
- 指令+流式 RGB;Prune 变体另用深度与位姿做几何裁剪
- 动作输出
- 4 步导航动作块
- 训练数据
- 导航数据来自 R2R、RxR、EnvDrop、ScaleVLN;混合 DAgger 纠错和 LLaVA-Video、ScanQA、MMC4。
要解决什么问题
逐步重编码长视频代价高,而简单丢弃历史又会损失长程导航线索。
设计思路基于论文的阅读归纳
近期观察和动作保留在快速更新的 KV 窗口;较早视觉内容压缩为慢更新记忆。
 Figure 2 · 快速对话窗口与慢更新视觉记忆。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 视频 VLM;论文给出语言模型与视觉编码器各自的学习率。
- 冻结 / 固定部分
- 体素裁剪是非学习几何操作;是否启用该操作取决于模型变体。
训练流程
- 先以专家导航视频进行动作监督微调。
- 用当前模型在训练环境运行,并让专家标注纠正动作。
- 加入纠错轨迹和通用多模态数据进行第二阶段训练。
推理时怎样行动
- 将新图像与历史动作追加到多轮上下文,复用 KV cache。
- 窗口满后将旧视觉上下文转为较紧凑记忆。
- 生成并执行动作块,再获取观察;Prune 版本额外使用几何去重。
端到端边界:RGB-only 与 Prune-Mem / Prune-All 的传感器条件不同。不能将几何裁剪变体统一标成纯 RGB。
训练开放情况与复现限制
训练入口已公开
提供两阶段训练、DAgger 收集、模型权重及部署入口;README 提醒使用 R2R_VLNCE_v1-3 数据版本。
v2 Table I / III 的 R2R SR/SPL 为 56.4/50.2、RxR 为 54.4/45.4,但 §IV-C 正文仍写旧值 56.9/51.9 和 52.9/46.0;本页明确采用 v2 表格 RGB-only† 配置,不将冲突数字混合。
查看本篇 2 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- LLaVA-Video:SigLIP+MLP+Qwen2;7B
- 输入
- 指令+采样的 16 帧单目 RGB 历史
- 动作输出
- 4 个有效导航动作组成的动作块
- 训练数据
- 约 2.1M 动作级导航样本,另有轨迹生成指令和通用视频问答;每轮增加自动生成纠错数据。
要解决什么问题
模型偏离专家路线之后缺少恢复经验,单纯增加成功轨迹不能充分教会纠错。
设计思路基于论文的阅读归纳
将训练环境中的失败转换为纠偏轨迹和关键帧感知问答,再继续训练,循环产生更难的新错误。
 Figure 2 · 导航微调与自纠错数据循环。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- LLaVA-Video 初始化的导航模型;本文强调数据与后训练机制。
- 冻结 / 固定部分
- 逐模块冻结表本次未核实。
训练流程
- 以动作预测、轨迹到指令和视频问答完成导航微调。
- 仅在训练 split 运行当前模型,检测路线偏离并生成纠偏与感知数据。
- 将新纠错数据与专家轨迹混合训练,再重复收集。
推理时怎样行动
- 采样 RGB 历史并结合指令。
- 导航模型直接预测动作块。
- 执行后获取新观察;纠错能力体现在策略中,无须额外反思 Agent。
端到端边界:是基于错误轨迹的监督后训练,不是推理时外接一个反思大模型,也不等于 GRPO 强化学习。
训练开放情况与复现限制
训练入口已公开
官方项目链接的仓库已有导航数据构建、flywheel 纠错收集、train_mixed.sh 监督训练及评测入口;真实机器人微调仍标注 Coming Soon。README 标题误写 AAAI 2025,会议年份按正式 proceedings 记为 2026。
迭代采样与自动标注增加训练成本;数据必须来自训练环境。保留 v1 原表结果,未实测复现。
查看本篇 2 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- System 2:Qwen2.5-VL;System 1:NavDP 类 diffusion policy;7B 规划器+独立动作策略
- 输入
- 语言+RGB 历史;原报告双系统的 System 1 使用当前 RGB-D 观察。S2 单独评测另接模拟器执行器。
- 动作输出
- 中期像素目标/latent plan → 短时运动轨迹
- 训练数据
- InternData-N1:3,000+ 场景、50M+ 第一视角图像;图像数不等于轨迹数。
要解决什么问题
语言规划计算较慢,避障与局部运动却需要高频响应;显式像素目标又容易丢失语义意图。
设计思路基于论文的阅读归纳
让慢速 VLM 规划与快速轨迹策略异步协作,再用可学习 latent plan 改善两者接口。
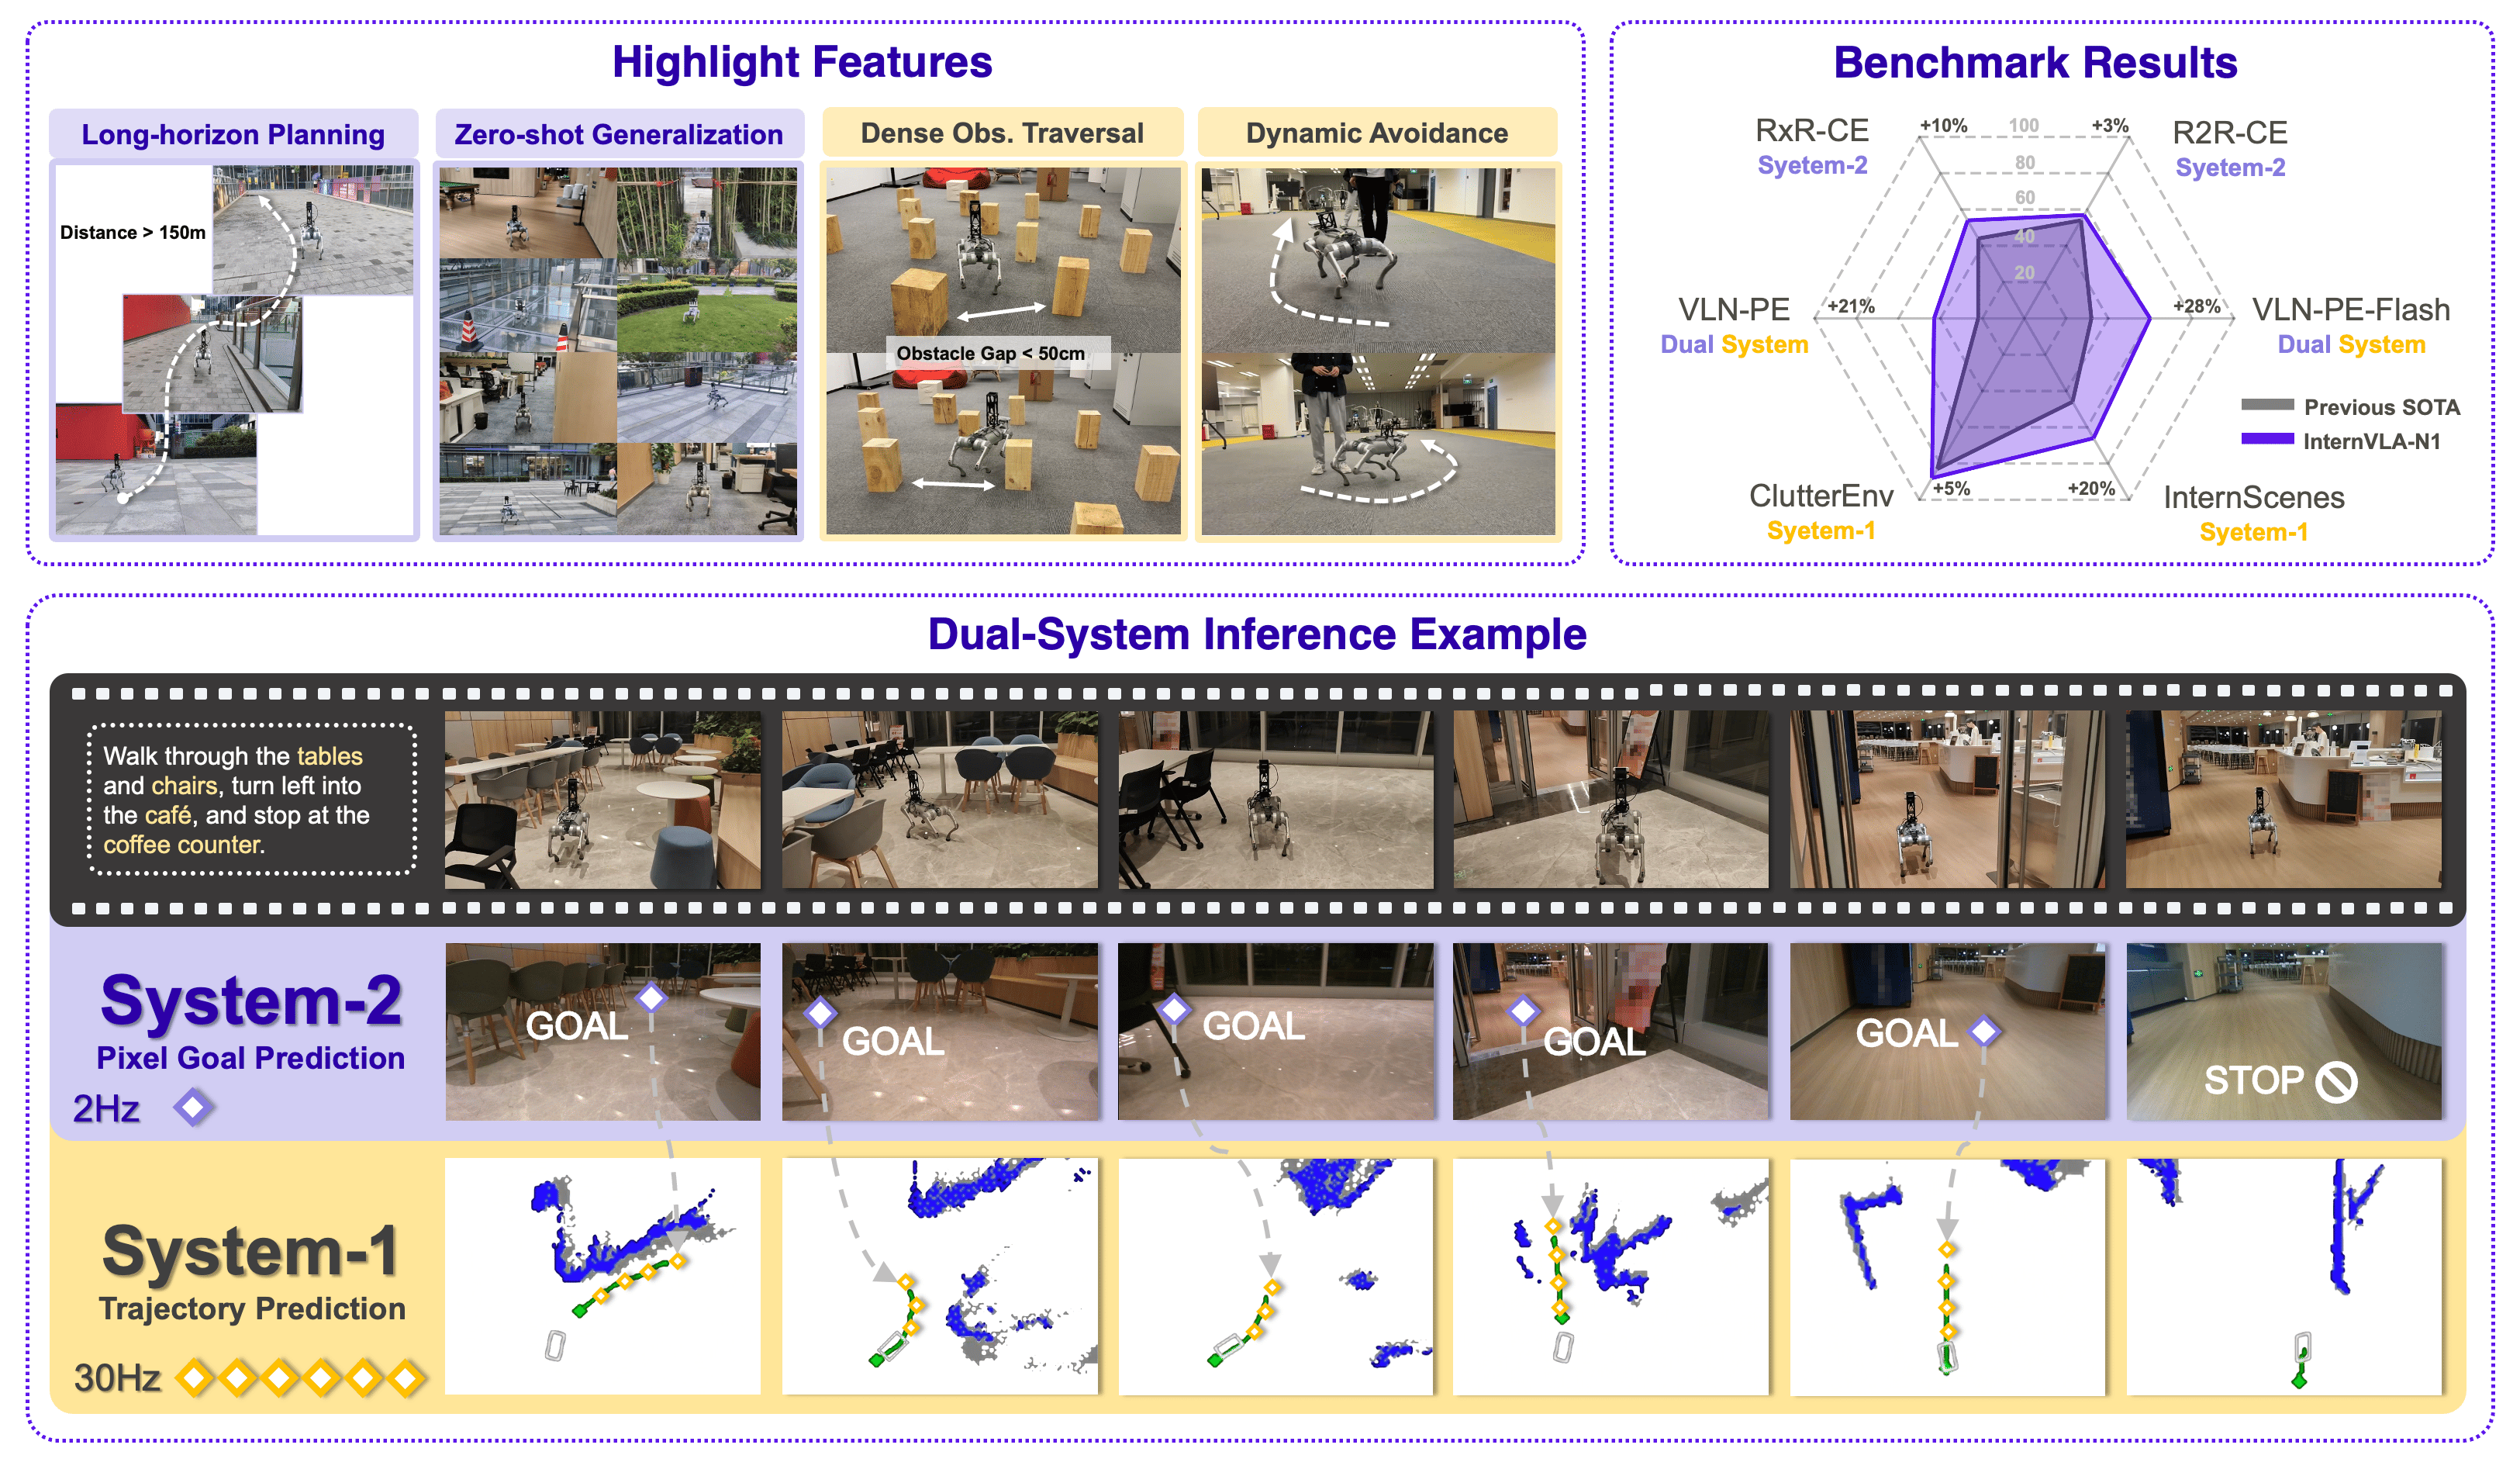 官方项目架构图 · 慢速规划与快速局部动作系统。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- System 2 预训练更新视觉编码器、connector 与 LLM;System 1 训练 diffusion、critic 和目标对齐;联合阶段训练 latent queries 与 System 1。
- 冻结 / 固定部分
- 联合阶段固定 System 2 主体;不等于整套模型所有参数同时更新。
训练流程
- 用导航指令和远端像素目标监督 VLM 规划器。
- 训练多目标条件 diffusion 策略与目标对齐、轨迹安全评分。
- 加入 latent plan,并用延迟观察训练异步规划—执行协作。
推理时怎样行动
- System 2 从长时历史与指令产生中期意图。
- System 1 结合最新局部观察和意图生成短时轨迹。
- 低层控制器执行;规划器以较慢频率刷新意图和停止判断。
端到端边界:是分层双系统,轨迹再接低层控制器。S2 的 55.4 SR 对应接 ShortestPathFollower 的独立规划评测,不能当作双系统或纯神经端到端执行成绩。
训练开放情况与复现限制
训练入口已公开
InternNav 于 2025-12 公告训练代码开放;实际提供 System 2 SFT、NavDP* 联合训练和后续 DualVLN 配置。训练入口默认 DualVLN,复现原报告须区分 NavDP* 的 RGB-D 配置。
原报告、后续 DAgger 版本与 DualVLN 必须区分。日期采用报告首页的 2025-09-11;仓库 News 将技术报告公开公告列在 2025-10,二者口径不同。
查看本篇 4 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- Qwen2-7B+DINOv2 / SigLIP 双视觉编码器;7B 语言基座
- 输入
- 指令+可变相机数量的 RGB 视频
- 动作输出
- 动作 token 经 MLP 头回归局部 waypoint 轨迹
- 训练数据
- 共约 12.7M 样本:8.02M 导航+4.76M 图像/视频问答;覆盖不同机器人与任务。
要解决什么问题
导航模型常依赖单一任务与相机配置,换机器人、视角或目标类型就要重建策略。
设计思路基于论文的阅读归纳
用时间—视角标记和固定 token 预算统一输入,用独立轨迹头统一不同任务的行动输出。
 Figure 3 · 共享语言骨干,分别连接语言生成头与轨迹规划头。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- LLM、跨模态映射与轨迹头等指定参数;导航回归与问答生成共同优化。
- 冻结 / 固定部分
- 视觉特征可离线缓存;不要据端到端名称推断所有视觉参数在线更新。
训练流程
- 将不同机器人轨迹转换为统一局部坐标与 waypoint 监督。
- 按时间、相机视角和视觉预算组织图像 token。
- 联合优化轨迹回归 MSE 和视觉语言问答交叉熵。
推理时怎样行动
- 根据 token 预算采样历史并保留当前帧的较细视觉信息。
- 语言模型融合指令、时间与相机标记。
- 动作头输出局部轨迹,由执行器跟踪并闭环刷新。
端到端边界:直接轨迹预测不等于直接电机控制。单视角与四视角成绩需分列,不把四视角优势归因于架构本身。
训练开放情况与复现限制
训练开放未核实
已核实论文和项目;项目未提供可核实的完整官方训练仓库入口。
数据和计算规模较大;不同任务样本混合带来收益,但不代表小规模训练可达到同样结果。
查看本篇 4 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- Qwen2.5-VL-3B-Instruct;3B
- 输入
- 指令+单目 RGB+多轮历史动作
- 动作输出
- 最多 3 个合并动作组成的动作块
- 训练数据
- R2R、EnvDrop 与 RxR 专家轨迹用于热启动;RL 从 R2R/RxR 各取约 4K 指令进行主动探索。
要解决什么问题
专家模仿与离线动作匹配奖励难覆盖真实执行中的偏移,导航需要从自己的多轮行为后果学习。
设计思路基于论文的阅读归纳
先用专家轨迹热启动,再让模型实际执行、观察、采样多条完整轨迹,通过 GRPO 更新策略。
 Figure 1 · 模仿学习热启动与环境多轮强化学习。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- IL 阶段更新 connector 与 LLM;RL 阶段全部参数可训练。
- 冻结 / 固定部分
- IL 阶段固定视觉编码器,RL 阶段解冻。
训练流程
- 用导航专家轨迹进行模仿学习。
- 模型与模拟器多轮交互,为每条指令采样多条 rollout。
- 根据到达/停止结果进行 GRPO;动态早停和场景缓存降低收集成本。
推理时怎样行动
- 将图像、已执行动作和指令保留为多轮上下文。
- 生成短动作块并在环境中执行。
- 追加新观察,继续决策或 STOP。
端到端边界:比单步离线 RFT 更强调环境中的多轮 rollout;RL 不需要动作标签,但成功奖励和训练早停仍使用模拟器提供的信息。
训练开放情况与复现限制
训练入口已公开
提供在线 RL 训练、SFT/RL 权重、评估与环境服务器;README 明确未提供 SFT 代码,只提供其数据与配置说明及外部框架参考。训练进程与模拟器通过 HTTP 交互。
训练策略与运行环境必须协同部署。原文 §V-C 与 Table II 的轨迹计数口径略有差异,不能把图像、动作样本与轨迹数量混为一谈。
查看本篇 2 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- Qwen2.5-VL-7B-Instruct + VGGT-1B 编码器/融合解码器 + 两层 MLP 几何投影;7B VLM + 1B VGGT 底座;完整总参数量未核实
- 输入
- 单目前视 RGB 视频流、自然语言指令;不要求输入深度图、外部里程计或全景。
- 动作输出
- 离散低层动作:前进 25 cm、左转/右转 30°、停止;在连续空间中逐步执行。
- 训练数据
- Base 使用 R2R-CE/RxR-CE;Extra 加 ScaleVLN 子集 155K 轨迹(约 9,207K 图像动作对)和 DAgger 14K 轨迹(约 1,485K 对)。
要解决什么问题
仅靠二维语义视觉特征容易漏掉空间几何;保存全部图像或文字地图还会导致上下文增长和重复计算。
设计思路基于论文的阅读归纳
将语义与三维几何分为两条编码分支,各保留初始帧和最近窗口的 KV。VGGT 提供 RGB 中的几何先验,经投影与语义特征融合后让 LLM 预测动作。
 原论文图 2:RGB 双编码器、双隐式 KV 记忆、几何语义融合与动作预测。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 微调 LLM 与几何融合投影层;公开脚本启用 tune_mm_llm 与 tune_mm_mlp。
- 冻结 / 固定部分
- 语义视觉编码器与 VGGT 空间编码器保持冻结;并非所有模块从头训练。
训练流程
- 准备 MP3D 环境与 R2R/RxR 连续轨迹观察—动作数据,载入 Qwen2.5-VL 与 VGGT。
- 运行 Base 监督训练;LLM 学习率 2e-5、投影层 1e-5,训练 1 epoch,冻结双视觉编码器。
- 用 Base 在环境中收集 DAgger 纠偏数据,并整理 ScaleVLN 子集。
- 从 Base 继续训练 Extra;分别保存和评测两个版本,避免混淆数据预算。
推理时怎样行动
- 对新 RGB 帧分别提取语义和几何特征。
- 增量更新两条 KV 记忆,默认保留 8 个初始帧和 48 个最近帧。
- 合并相邻几何 patch,经 MLP 按权重 0.2 融入语义特征,再结合指令交给 LLM。
- 预测并执行下一动作,闭环推进直至 Stop;不反复重编码全部历史。
端到端边界:属于 RGB 与指令到动作的直接策略;双视觉编码器冻结,不能称为全参数端到端训练。连续环境中的离散步进,也不同于连续速度或电机控制。
训练开放情况与复现限制
训练入口已公开
已核对官方 train.sh、train_extra.sh、DAgger 收集与评估入口,提供 Base/Extra 权重和训练数据准备说明;此处是内容核验,未实际启动训练。
固定窗口可能丢失较早的细节;双编码器仍有算力成本。真实机器人展示依赖远程 A10 推理,不能据此证明已在低功耗设备独立运行。主表 Extra 的 R2R SPL 为 56.8,附录数据消融同配置列 56.6;此处按主表摘录。
查看本篇 4 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- LLaVA-Video-7B + SigLIP-400M + MLP 连续动作头;VLM 骨干 7B 级;视觉编码器约 400M;完整模型与可训练参数总量未核实
- 输入
- 第一人称单目 RGB 视频、语言目标或目标图像,以及视觉辅助的语言记忆。
- 动作输出
- 可选推理和环境摘要,以及由连续动作头预测的局部轨迹 (x, y, θ)。
- 训练数据
- Nav-AdaCoT-2.9M 来自 ObjectNav、EVT 与 ImageNav,包含自动推理标注;另混合 LLaVA-Video-178K、Video-R1、ScanQA 的 1.6M 样本。底层数据公开不代表自建标注已开放。
要解决什么问题
固定推理预算和有限视觉历史容易造成重复探索,也难以应对长程导航与动态目标。
设计思路基于论文的阅读归纳
AdaCoT 按需触发推理;VLingMem 保留语言摘要和关键视觉信息,再由同一 VLM 的末尾隐状态预测轨迹。
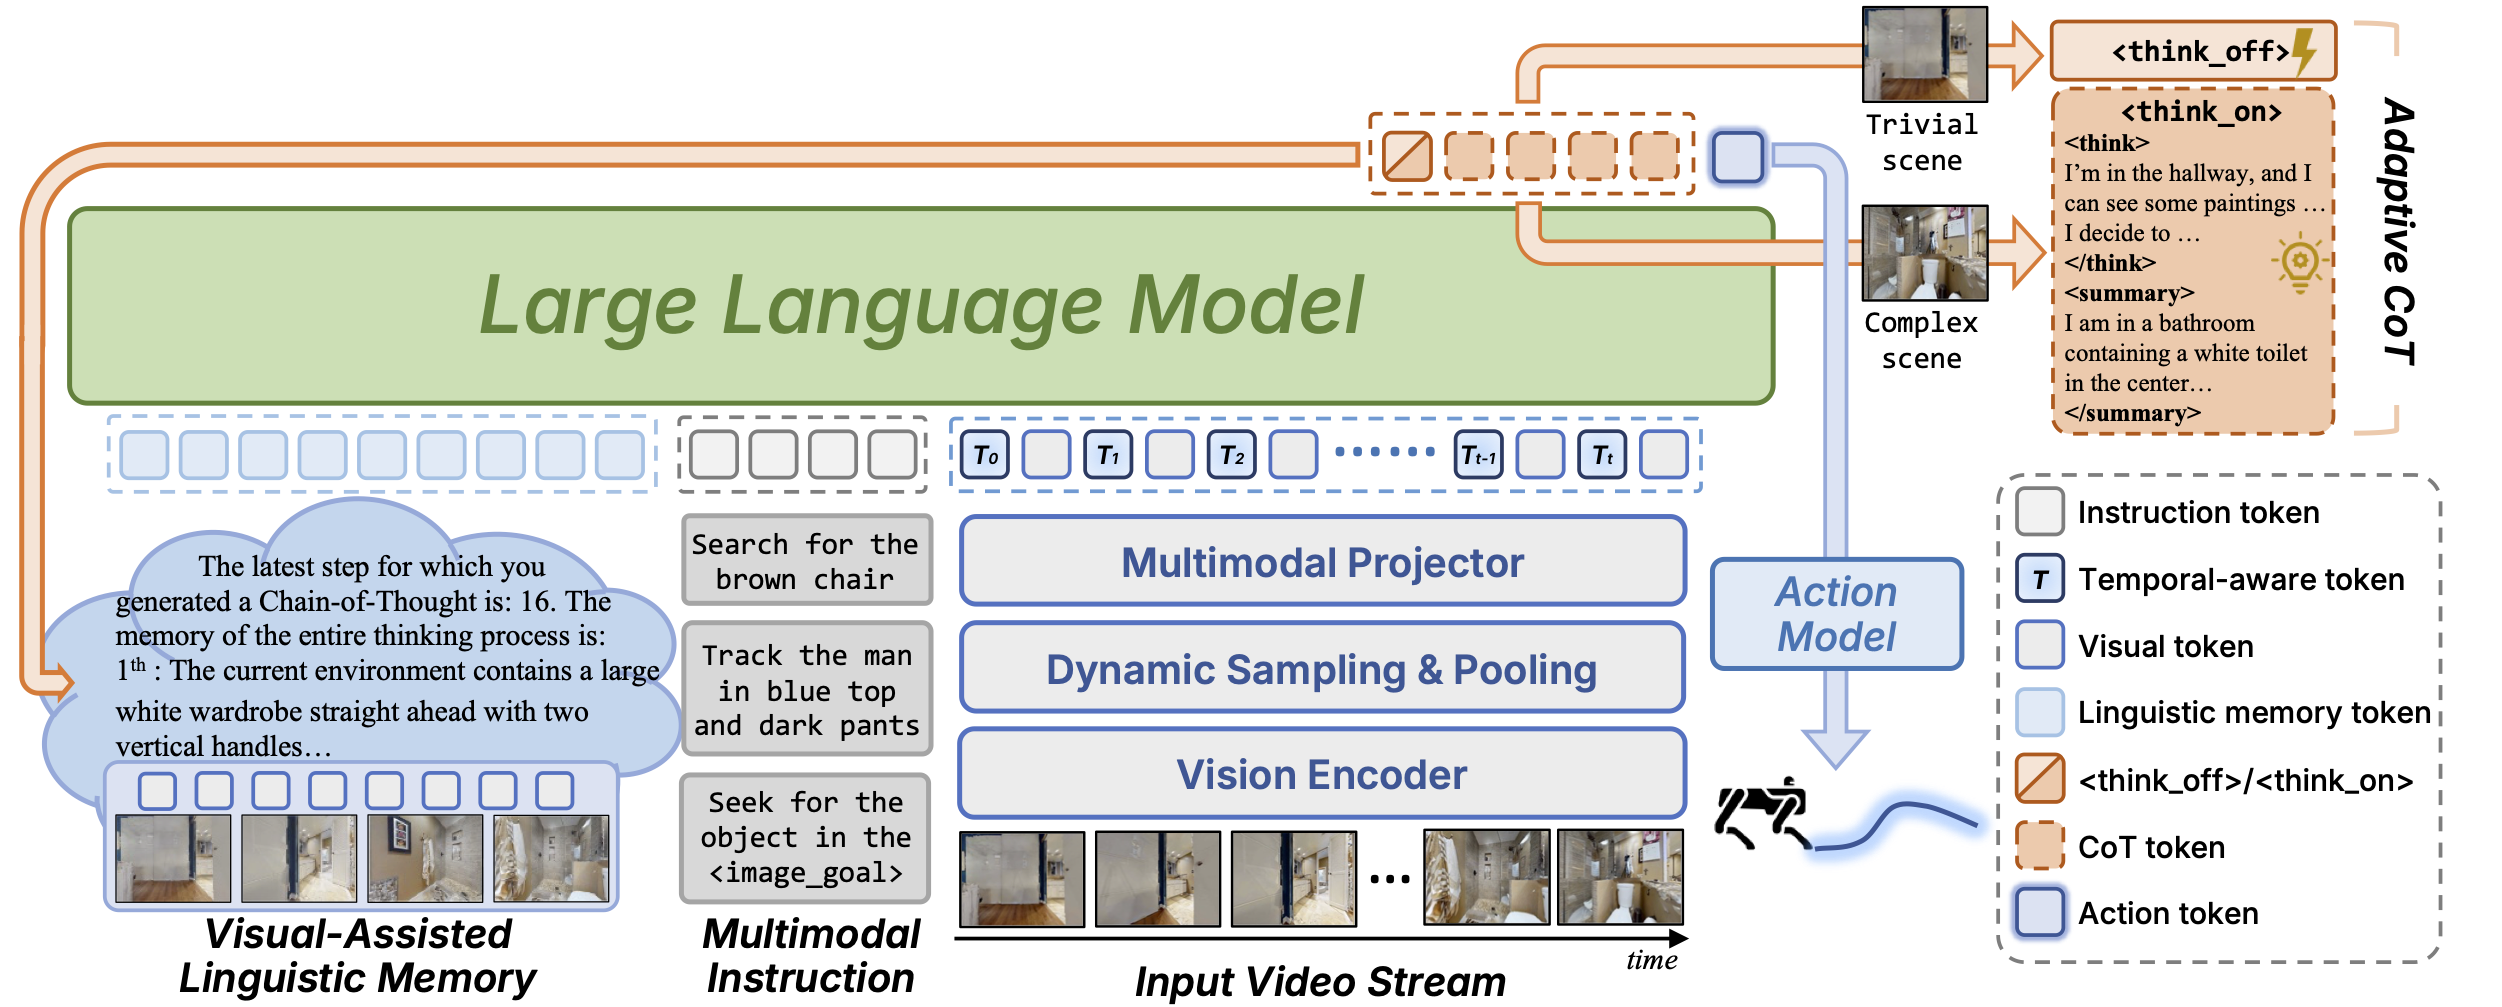 官方方法图:视频、目标与语言记忆进入 VLM,由自适应推理连接连续动作预测。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 视觉语言投影、VLM、时序表示及动作头;论文明确除视觉编码器外,其余组件全阶段更新。
- 冻结 / 固定部分
- SigLIP 视觉编码器全程冻结。
训练流程
- 以开放世界视频数据预训练自适应推理,用文本交叉熵学习何时思考。
- 混合导航与视频数据进行 SFT/模仿学习,联合优化轨迹均方误差和文本交叉熵。
- 在线收集成功执行与专家纠错轨迹,结合 PPO 式策略目标、REINFORCE++ 优势估计和监督损失更新。
推理时怎样行动
- 对历史视频动态采样与池化,将当前观察、目标和跨时刻记忆送入 VLM。
- 生成思考开关;需要时输出推理与环境摘要,并更新记忆。
- 动作头预测局部轨迹,实机由 MPC 控制器执行;获取新观察继续闭环。
端到端边界:属于通用导航 VLA 扩展:主评测是 ObjectNav、ImageNav 和具身跟踪,没有 R2R/RxR 主结果。快慢思考仍在单模型内,直接输出轨迹;MPC 执行器位于模型外。
训练开放情况与复现限制
训练开放未核实
截至 2026-10-09,官方项目只提供论文、视频和网页源码;未核实可运行训练实现、模型权重或 Nav-AdaCoT-2.9M 下载。VLingNav-web 是展示网站仓库,不能当作模型开源。
单目视野与单系统推理频率限制动态避障;尚依赖 MPC 航点控制。论文可训练性已明确,公开材料尚不足以确认完整复现。
查看本篇 9 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- Qwen2.5-VL + 预训练 VAR 视觉压缩器;7B(主 VLM)
- 输入
- 自然语言多阶段导航指令、当前及历史多视图 RGB 观测。
- 动作输出
- 自回归动作 token;默认使用不显式展开 CoT 的直接动作分支。
- 训练数据
- LH-VLN 训练集及其文本/视觉推理标注;训练切片约 18K,每段五步。文本推理由 Qwen-VL-Max 辅助标注。
要解决什么问题
长程导航需要推理,但文本思维链空间依据不足,显式生成想象图像又会消耗大量 token。作者希望训练时利用多模态推理监督,同时保留部署时直接动作预测的速度。
设计思路基于论文的阅读归纳
把未来图像压缩为 VAR 的低尺度 latent tokens,统一训练无 CoT、文本 CoT、视觉 CoT、图文 CoT 四种模式。共享模型参数并增加跨模式对齐,使推理监督能够改善不输出推理过程的导航分支。
 官方架构图:多种 CoT 模式联合训练,默认直接动作推理。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 语言层及视觉语言投影层的 LoRA 参数;扩展动作和视觉 latent token 的适配部分。
- 冻结 / 固定部分
- VAR 模型冻结;采用 LoRA 对 VLM 做参数高效适配,并非全模型从零训练。
训练流程
- 整理专家动作、文本解释与未来图像的 VAR latent 监督。
- 在共享 VLM 上联合学习四种推理模式,使用交叉熵预测相应序列。
- 交替优化直接动作目标和跨模式对齐目标,选择验证集检查点。
推理时怎样行动
- 编码导航指令以及当前和历史观测。
- 选择 non-CoT 分支直接解码下一动作,不生成像素图像。
- 执行动作、更新观测并循环;STOP 触发当前子任务完成判定。
端到端边界:属于可训练的视觉语言到动作策略。视觉想象主要提供训练监督,默认推理不运行外部世界模型规划。
训练开放情况与复现限制
训练入口已公开
已核实官方 train.sh、训练环境和数据转换流程;Qwen-VL-Max 生成的文本 CoT 标注未公开,需自行复现。核验:2026-10-06。
主要证据来自 LH-VLN 多阶段任务;其 SR 要求完成整段多阶段任务,不能和 R2R-CE SR 直接横比。训练代码公开不等于全部推理标注已公开。
查看本篇 1 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- Qwen2.5-VL-3B;3B
- 输入
- 语言指令、单目 RGB 当前图像和最多八帧历史。
- 动作输出
- 前进、左转、右转、停止组成的可变长动作块;动作类型与数字共同编码。
- 训练数据
- R2R、RxR、ScaleVLN 和 DAgger 轨迹,经 HPAC 处理得到约 2.4M 逆动力学三元组及约 2.8M 导航样本。
要解决什么问题
只拟合观察到动作的映射,模型可能依赖动作文本共现,而不理解移动如何改变视野。长动作块能提高效率,却也会延长错误持续时间。
设计思路基于论文的阅读归纳
将动作序列分层合并为 HPAC 动作块,同时训练逆动力学任务:根据起止图像恢复期间的动作。训练目标统一到动作 token 空间;部署时依据动作类型 token 的熵自适应截断执行前缀。
 原文 Figure 2:动作块、逆动力学联合监督与熵引导执行。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 视觉语言 projector 与语言模型主干,使用导航和逆动力学样本联合微调一个 epoch。
- 冻结 / 固定部分
- Qwen2.5-VL 的视觉编码器冻结;不新增未来图像生成器。
训练流程
- 合并重复微动作,再把子块组成更长且可变长的训练标签。
- 从轨迹起止图像构造逆动力学监督,与指令导航样本共用动作语法。
- 联合最小化两种任务的动作交叉熵,训练 projector 与 LLM。
推理时怎样行动
- 对历史帧均匀采样,输入指令和当前图像。
- 自回归预测动作块,并计算动作类型 token 的不确定性。
- 执行置信度允许的前缀,然后重新观察和预测。
端到端边界:是直接动作 VLA;逆动力学是训练任务,不是部署时额外接入的规划器,也没有生成未来视频。
训练开放情况与复现限制
训练入口已公开
官方仓库公开数据预处理、scripts/train.sh、Transformers 与 vLLM 评估脚本及 3B 检查点。核验:2026-10-06。
动作仍来自有限离散集合;熵只衡量模型置信度,不能保证真实物理安全。主结果含额外合成与 DAgger 数据,比较时需对齐数据预算。
查看本篇 2 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- Janus-Pro 地图生成模型 + NVILA-2B 导航策略;导航策略 2B;地图模块具体规模未核实
- 输入
- 语言指令、当前及历史单目 RGB,以及在线生成的任务 BEV 地图。
- 动作输出
- 地图模块生成三通道 BEV;导航策略生成接下来三步动作。
- 训练数据
- R2R/RxR-CE 轨迹形成约 1.2M 状态动作对,另含约 500K 探索样本;BEV 占据和距离来自仿真,地标监督来自 IRef-VLA。
要解决什么问题
固定手工地图追求几何完整性,却未必保留导航最需要的信息。作者把地图视为受下游动作任务塑造的可学习表示,而非提前冻结的场景重建结果。
设计思路基于论文的阅读归纳
地图模块自回归生成占据、距离和指令地标三通道 BEV,策略以此为条件预测动作。先监督建立稳定接口,再让地图生成器和策略共享导航奖励,联合 GRPO 微调。
输入语言指令、当前及历史单目 RGB,以及在线生成的任务 BEV 地图。
→
模型主干Janus-Pro 地图生成模型 + NVILA-2B 导航策略
→
输出地图模块生成三通道 BEV;导航策略生成接下来三步动作。
流程为阅读摘要;完整结构请见原论文。
自己训练时,需要更新哪些模块
- 可训练部分
- 先分别训练 Janus-Pro 地图模块与 NVILA 导航策略,第二阶段联合更新两者。
- 冻结 / 固定部分
- 监督策略冷启动时冻结已训练地图模块;联合 RL 阶段重新优化地图与策略,不是全程冻结地图。
训练流程
- 用仿真及地标标注监督 Janus-Pro 生成任务 BEV。
- 暂时固定地图生成器,用专家与 DAgger 样本训练 NVILA 三步动作预测。
- 联合 GRPO 微调两模块,奖励正确动作前缀和输出格式。
推理时怎样行动
- 地图模块读取指令与图像历史生成紧凑 BEV。
- 导航 VLM 结合 BEV 和原始视觉语言上下文预测动作序列。
- 执行动作、获取新观测,再更新地图和决策。
端到端边界:属于可联合训练的双模块地图导航模型;存在显式 BEV 中间接口,因此标为 hybrid,而非单 VLM 无中间表示直接控制。
训练开放情况与复现限制
未发布(官方说明)
官方项目仍写 Code (Coming Soon);已发现同名 Hugging Face 模型仓,但这不代表训练实现已公开。核验:2026-10-06。
地图监督依赖仿真特权信息;部署需要地图生成与动作预测两次计算。训练代码尚未公开,复现门槛高于已有完整脚本的直接动作模型。
查看本篇 2 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- Qwen3-4B Cognitive Brain + ViT + Conditional Flow Matching Action Expert;语言主干 4B;完整模型参数量未核实
- 输入
- 当前单目或前/左/右 RGB、视觉历史;目标可以是语言、物体、POI、人物描述或局部 BEV 点坐标。
- 动作输出
- Flow Matching 生成 5 个局部 BEV 路点,每点包含 (x, y, θ)。
- 训练数据
- 作者报告 7,802 个场景、16.9M 轨迹训练数据和 5M 推理样本,覆盖五类任务;包含公开场景、互联网视频、真实机器人及自有 3DGS/SocCity 数据。
要解决什么问题
点目标、物体目标、指令跟随、POI 和人物跟随常被分别设计模型;仅模仿最短路径也难以学会社会通行规则。
设计思路基于论文的阅读归纳
统一多模态输入,让 Qwen3-4B 提供语义上下文,再由流匹配动作专家生成连续轨迹。推理头与动作头按任务选择;导航时不必先输出一段 CoT 再行动。
 官方架构图:统一编码、条件双头 Cognitive Brain 与流匹配动作专家。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 阶段一训练 LLM;阶段二联合训练 Brain 的文本预测与动作专家的条件流匹配;阶段三只优化动作专家。
- 冻结 / 固定部分
- 认知预热冻结视觉编码器与动作专家;SAFE-GRPO 冻结 Brain。阶段二视觉编码器是否解冻未明确核实。
训练流程
- 用场景理解、导航推理与通用 VQA 做 cognitive warm-up,next-token loss 对齐 LLM。
- 混合五类导航示范与约 20% 推理回放,以文本交叉熵和 conditional flow matching 联合 SFT。
- 在 SocCity 上做 SAFE-GRPO,只更新动作专家;奖励结合社会通行、专家相似度、平滑与效率。
推理时怎样行动
- 将视角区分后的 RGB、历史和异构目标编码成共享 token。
- Brain 依据任务 token 走推理分支或直接为动作专家提供条件。
- 动作专家生成短时路点,交给控制器执行并根据新观察重规划。
- 长任务应用可另接 Agentic Planner 与拓扑记忆;它们是外围系统。
端到端边界:是有实际策略训练的 Brain–Action 模型;层次结构不等于 AgentOS,也不等于外围 Agentic Planner。输出为路点,仍需机器人控制器。
训练开放情况与复现限制
训练开放未核实
2026-10-06 核对:官方 ABot-N0 分支只有报告、README 与演示资源;未找到模型训练/推理实现,也未找到明确的后续模型开放承诺。
公开材料尚不足以直接复现;自有数据占有重要地位。RL 主要面向 SocCity 社会导航,不能据此宣称五种任务均做了在线 RL。
查看本篇 2 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- LLaVA-Video-7B + SigLIP + Pilot 投影模块;7B(决策主干)
- 输入
- 语言指令、当前单目 RGB、上一步缓存的 Pilot latent token。
- 动作输出
- 前进、左转、右转、停止,以及供下一步复用的 Pilot Token。
- 训练数据
- R2R、RxR、EnvDrop 增广数据及 HM3D 上的 ScaleVLN 轨迹;另通过 PilotLoop 收集当前策略轨迹及专家纠偏数据。
要解决什么问题
导航轨迹本身含有动作后的未来观测,但传统动作模仿没有充分利用这类监督。外接视频世界模型又会显著增加推理开销。
设计思路基于论文的阅读归纳
把未来视野信息内化到递归传播的 Pilot Token。训练时利用未来帧作特权输入和回归目标;测试时只读取上一轮模型预测的 latent,使同一决策主干具备紧凑的跨步记忆和前瞻表示。
 原文 Figure 2:当前观测与跨步 Pilot Token 驱动直接动作预测。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 决策主干及轻量 Pilot 线性投影;论文联合优化式也包含视觉编码参数。
- 冻结 / 固定部分
- 正文未明确列出独立冻结模块;不把 SigLIP 初始化误写为必然冻结。
训练流程
- 使用 Habitat 最短路径专家进行模仿学习冷启动。
- 执行当前策略,偏离参考轨迹过多时由专家接管,并保存未来观测。
- 联合动作交叉熵与未来 latent 回归反复微调,迭代采样和训练。
推理时怎样行动
- 读取当前图像、任务指令和上一轮 Pilot 缓存。
- 一次主干计算同时预测动作和更新后的 Pilot Token。
- 执行动作并覆盖缓存,循环至停止;不读取任何未来帧。
端到端边界:属于单主干直接动作导航;Pilot Token 是连续内部状态,不是离散地图或部署时的外部想象规划器。
训练开放情况与复现限制
训练入口已公开
官方仓库包含 latent_nav/script/train.sh、评测及真机服务脚本;运行前需配置前阶段权重和数据。核验:2026-10-06。
训练和推理的 Pilot 输入来源不同,复现需严格核对特权监督接口;正文对冻结策略交代有限。真机动作仍由机器人底层控制器执行。
查看本篇 2 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- Qwen3-VL;SigLIP-2 ViT、patch merger、LLM,另接四层 MLP 轨迹头。该底座由官方仓库与报告 v1 明确命名。;2B / 4B / 8B 系列;主结果含 4B、8B
- 输入
- 单目或多相机 RGB 历史、语言目标、任务模式、机器人身份提示;相机名与时间步以文本标签标识。
- 动作输出
- 8 个局部路点,每点为 (x, y, θ),合计 24 维;需要执行器将路点转成机器人运动。
- 训练数据
- 15.6M 样本,85% 导航轨迹、15% 视觉语言推理;含 R2R/RxR-CE、点目标、物体搜索、人物跟踪、驾驶及生成视频增广。数量是训练样本,不是完整导航 episode 数。
要解决什么问题
同一模型要跟随指令、搜索物体、跟踪目标和驾驶,但各任务需要的历史长度与图像精度不同。固定抽帧或滑动窗口难以适应任务中途切换。
设计思路基于论文的阅读归纳
把观察策略做成可配置接口:分配总视觉 token 预算、时间衰减、相机权重和抽帧模式;训练时随机化这些设置。统一 VLM 直接回归路点,并混合视觉语言样本保持理解能力。
 原论文图 2:下部为可配置观察编码与路点模型,上部为可选 agentic 调度系统。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 从预训练底座端到端微调视觉编码器、LLM 与轨迹头;轨迹样本用 MSE,视觉语言样本用 next-token loss。
- 冻结 / 固定部分
- 模型训练未固定视觉或语言底座;机器人控制器与可选上层规划器不属于该轨迹模型的联合训练范围。
训练流程
- 统一不同平台的观察与路点格式,并按数据集尺度归一化坐标。
- 逐样本随机 token 预算、时间权重、相机权重及 random/latest 抽帧,学习对观察配置的鲁棒性。
- 多任务联合微调,优化轨迹 MSE 与视觉语言 next-token loss;两项权重为 1。
- 8B 报告使用全局 batch 256、2,816 H100 GPU 小时;未报告此模型的导航 RL 阶段。
推理时怎样行动
- 依据任务选择观察配置,保留相应历史与相机画面。
- 调整各画面分辨率并插入时间、视角和具身身份标签。
- VLM 与 MLP 产生路点,反归一化后交由控制器执行,随新观察滚动重规划。
- 长任务可由外部 LLM 拆分子目标、切换模式并维护记忆;这是可选 agentic 系统。
端到端边界:基础模型属于 RGB/语言到连续路点的直接策略;完整 agentic 应用另有规划器、记忆与控制器,不能把应用系统的所有能力视为单网络端到端学习。
训练开放情况与复现限制
未发布(官方说明)
2026-10-06 核对:官方仓库只有 README 与展示资源,没有训练实现;README 明确目前没有发布 Qwen-RobotNav 权重的计划。论文公开不等于模型可复现。
官方未开放训练代码或权重;全景与单目结果必须分开比较。较大数据与计算规模也是复现实验的实质门槛。
查看本篇 8 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- Qwen3-VL-4B / 8B + VGGT 空间编码器;4B / 8B(VLM 主干)
- 输入
- 自然语言指令、当前及历史单目 RGB;同一图像同时提取视觉和空间特征。
- 动作输出
- STOP、MOVE_FORWARD、TURN_LEFT、TURN_RIGHT 四类动作文本。
- 训练数据
- R2R-CE、RxR-CE 专家轨迹;同时报告不使用外部数据的 0K 版本和完整数据版本,后者外部预算约 10.4M 样本。
要解决什么问题
仅学习观察到动作的对应关系,未必能理解当前空间状态、动作造成的变化以及未来状态。作者希望世界建模监督能提升导航,又不增加默认推理路径的额外生成成本。
设计思路基于论文的阅读归纳
将 VGGT 空间特征投影后融入 VLM token,共享表示上联合训练动作预测、正向动力学、逆动力学和未来空间状态生成。辅助任务回归 latent 特征,无需生成高分辨率未来图像。
 原文 Figure 2:冻结空间编码器与四类世界动作目标。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 语言模型、多模态 merger、动作与三种世界建模预测头。
- 冻结 / 固定部分
- VLM 视觉塔和 VGGT 空间编码器均冻结。
训练流程
- 编码当前与相邻观测,构造动作标签及下一观测的空间 latent 目标。
- 融合视觉与空间 token,联合优化动作和四种世界动作学习能力。
- 在匹配的数据设置下微调并评估;区分 4B、8B 与 0K 变体。
推理时怎样行动
- 用冻结编码器提取 RGB 语义和空间特征并融合。
- 语言模型直接解码下一导航动作,默认关闭辅助预测头。
- 执行动作并更新图像历史,继续闭环决策。
端到端边界:虽称世界动作模型,主评测使用直接动作分支;并非先生成未来视频再搜索路径的系统。
训练开放情况与复现限制
部分开放
官方仓库有环境、数据准备、检查点及评测说明;Training 仍为 Coming soon,不能视作完整训练代码开放。核验:2026-10-06。
训练脚本尚未公开;不同参数量和数据预算须分别比较。主表结果在本次检索的论文 HTML 版本中核实,后续修订可能变化。
查看本篇 4 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- 主实验:Qwen-3.5-4B 慢系统 + Qwen-3.5-2B 快系统;QFormer 与 MLP 解码连续动作。;主模型为 4B + 2B 底座;边缘部署另用 2B 慢系统与 306M DiT 快系统,不能混为同一模型配置。
- 输入
- 前/左/右三视角 RGB、历史前视帧、任务目标及先前决策;快系统还接收慢系统参考画面、文字与像素锚点。
- 动作输出
- 慢系统输出 CoT 与目标/可通行像素;快系统输出局部 SE(2) 路点序列及到达标志。
- 训练数据
- 约 30M 预训练样本:13.3M 高层、16.4M 低层,覆盖五任务;专家、DAgger/OOD 纠正及噪声增广。项目页列 8,423 场景;GRPO 实证为 0.5M 点目标 episode。
要解决什么问题
从视觉直接黑盒回归动作容易出现坐标漂移和语义判断错误,大模型推理延迟又与高频控制冲突。
设计思路基于论文的阅读归纳
用可解释的像素目标连接异步慢脑与快脑。慢脑决定往哪里走;快脑在其尚未更新时持续跟踪缓存目标,QFormer 查询隐状态后用 MLP 回归路点。
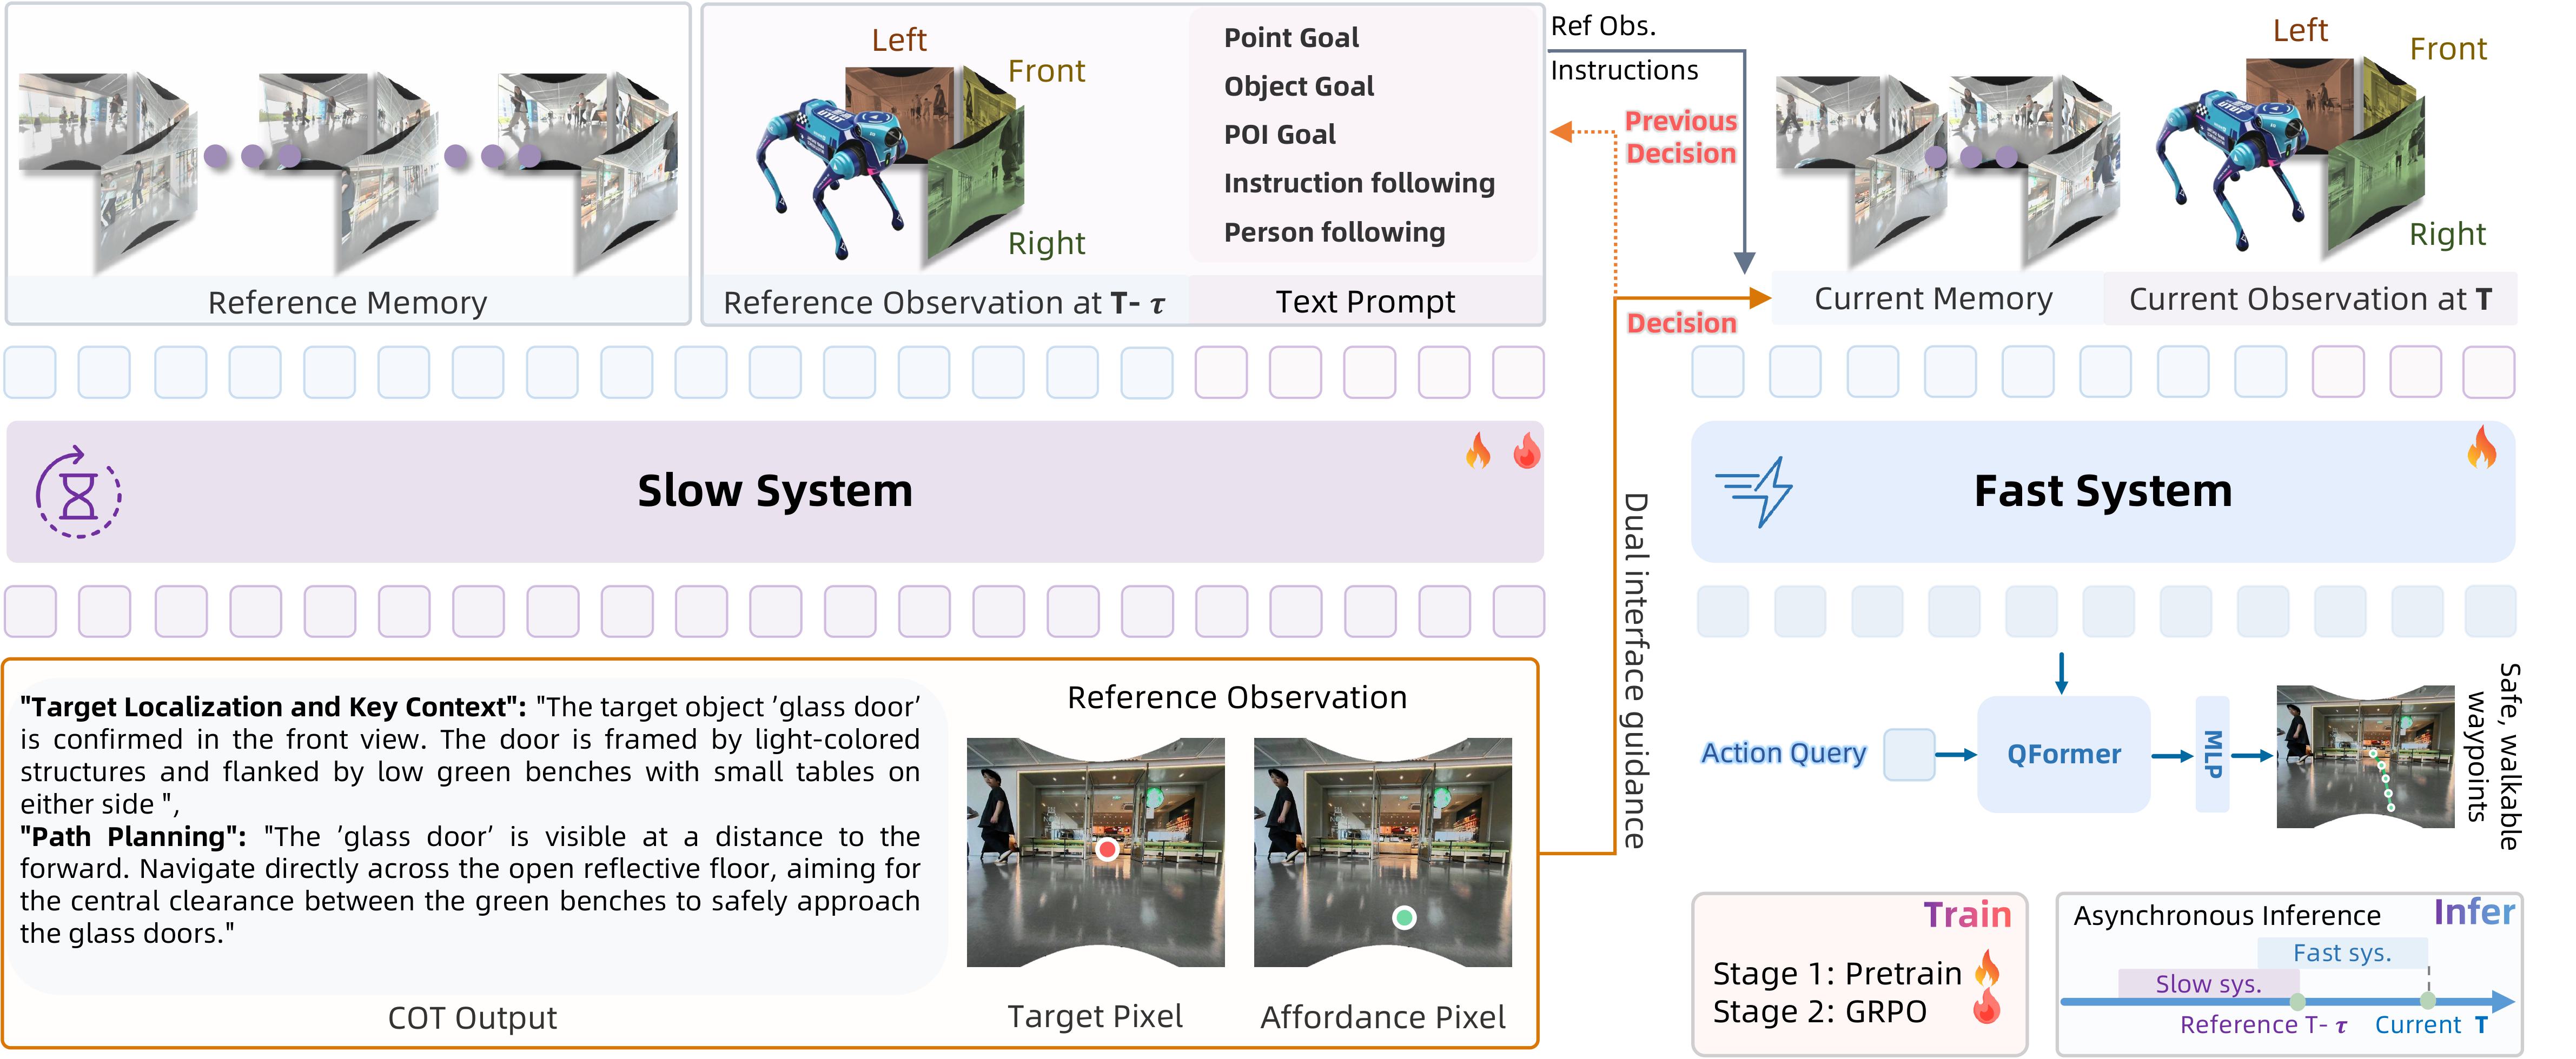 官方架构图:CoT/像素锚点驱动异步快系统;主实验动作头为 QFormer+MLP。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 两套系统分别接受监督预训练:慢脑学文字和像素 token,快脑学路点及到达;GRPO 后训练针对慢系统。
- 冻结 / 固定部分
- 主模型视觉编码器及投影层的完整冻结清单未核实;不能把数据标注器的冻结设置当作导航模型设置。
训练流程
- 构造轨迹、进度推理与像素目标;两系统分别从 Qwen-3.5 权重初始化。
- 慢系统用 token 交叉熵;快系统用位置/朝向 smooth-L1 和二分类到达损失。
- 扰动目标、前次像素与异步延迟,降低错误或过时指导的影响。
- 对慢系统做 GRPO,以格式、目标对齐和安全间距奖励优化像素决策;按安全程度平衡采样。
推理时怎样行动
- 慢系统读取历史、三视角和上次决策,产生新的像素锚点。
- 指令跟随/物体目标可同时输出 CoT;其他任务主要使用像素目标。
- 快系统结合当前观察与缓存参考画面、像素和文字,生成连续路点。
- 异步执行与更新直至到达标志触发;无需每一步等待慢系统重算。
端到端边界:属于分层、异步、分别训练的导航模型,不宜称为单网络全栈联合 E2E。ABot-N1 与 AgentOS 不同;主实验也不同于其压缩边缘部署版本。
训练开放情况与复现限制
部分开放
2026-10-06 核对:项目链接提供 ABotN-Bench 评测框架与示例 agent,不能据此认定 ABot-N1 模型、权重或训练代码已开放。
开放的是 benchmark 工具而非完整训练模型;GRPO 大规模验证限于点目标。人物跟随 DT/AT 的碰撞率仍上升,推理锚点也会有误差。
查看本篇 2 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- Qwen3-VL-8B-Instruct;8B
- 输入
- 语言指令、稀疏长期图像记忆和短期图像/动作交错历史。
- 动作输出
- 至多四个连续动作组成的动作块,动作类型为前进、左转、右转、停止。
- 训练数据
- 第一阶段含 R2R、RxR、EnvDrop、ScaleVLN 动作样本和轨迹摘要;后两阶段额外收集 DAgger 轨迹并重标注。
要解决什么问题
模仿学习与 DAgger 有助于纠错,强化学习有助于探索,但常被安排成互相独立的后训练阶段。作者研究如何让两类监督在同一优化过程里互补。
设计思路基于论文的阅读归纳
先学习基本导航,再用专家重标注的 DAgger 轨迹学习恢复,最后用 CHORD 框架动态混合 GRPO 与模仿损失。GRPO 聚焦高熵样本,模仿训练优先处理先前容易犯错的轨迹。
 原文 Figure 4:高熵 GRPO 与纠错优先模仿联合训练。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 视觉编码器、projector 和语言模型均设置独立学习率,在各阶段继续优化。
- 冻结 / 固定部分
- 正文未将主模型视觉塔列为冻结;GRPO 包含固定参考策略用于 KL 约束。
训练流程
- 联合训练动作预测与由导航视频生成指令的轨迹摘要任务。
- 执行模型采集 DAgger 轨迹,重放访问状态并用 oracle 重新标动作。
- 对高熵样本做 GRPO,同时以递减权重加入优先纠错的模仿损失。
推理时怎样行动
- 组织长期采样帧和短期图像动作对话。
- 复用 KV cache 预测下一动作块。
- 执行并追加观测,短期缓存满时更新长期记忆并重置短期上下文。
端到端边界:直接动作策略;RL 奖励主要针对动作块与 oracle 一致性等可验证信号,不应理解成只靠终局成功奖励的全程训练。
训练开放情况与复现限制
训练开放未核实
原文给出项目页;本次未核实可运行的官方训练仓库。项目页访问失败不等于作者未发布代码。核验:2026-10-06。
依赖 oracle 与多轮仿真数据采集;真机实验对每个环境使用十条轨迹适配,不能标成完全零样本迁移。多重相似地标仍可能引起错误转向。
查看本篇 2 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
- 基座 / 规模
- Qwen3-VL-4B-Instruct,保留原视觉语言架构与自回归语言输出头;论文称 4B 级主干;扩展指点与动作词表,完整可训练参数量未披露
- 输入
- 带时间戳的单目前视 RGB 历史与自然语言指令;策略无需深度、里程计或全景输入。
- 动作输出
- 两个空间指点 token,随后三个 RVQ 动作 token,解码为十步 SE(2) 航点轨迹。
- 训练数据
- 导航数据覆盖逾 2000 场景、4000 小时,包括 R2R/RxR、ScaleVLN、自蒸馏路线、目标导航和跟踪;另混合具身推理与视觉问答。
要解决什么问题
任务专用动作头割裂空间理解与控制,也限制同一模型跨导航任务和机器人平台复用。
设计思路基于论文的阅读归纳
先预测可通行位置与目标位置,再用残差量化动作词表表达轨迹;全部输出共享语言模型头,以空间指点作为固定长度的推理过程。
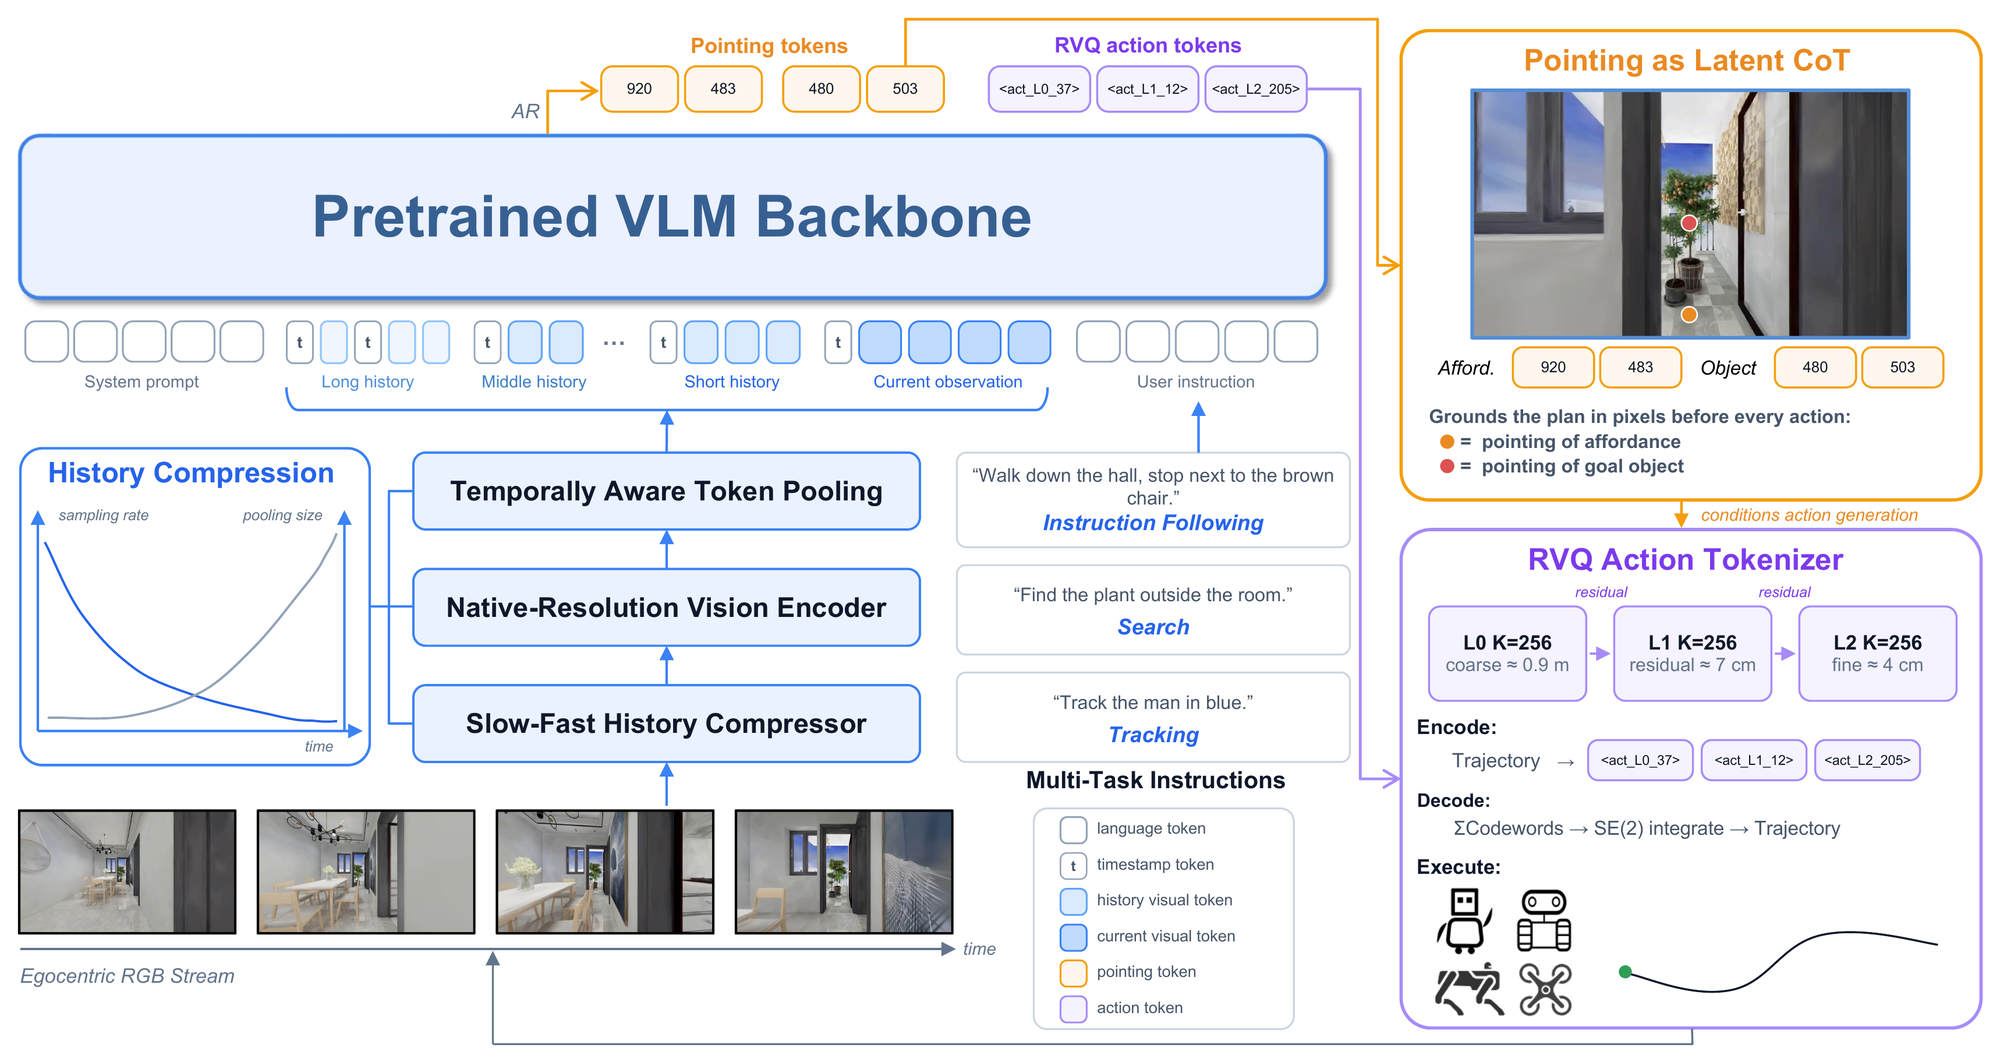 官方架构图:压缩 RGB 历史输入共享 VLM,先生成双通道指点,再解码 RVQ 航点。 原图 · 图片来自作者,版权归原作者。
自己训练时,需要更新哪些模块
- 可训练部分
- 共享自回归策略及扩展词表经具身推理训练、导航 SFT 和在线 RL 对齐;RVQ 码本通过残差聚类拟合。
- 冻结 / 固定部分
- RL 使用冻结的 SFT 参考策略;视觉编码器等逐模块冻结范围未明确披露,不能据此宣称全参数训练。
训练流程
- 以空间推理、图像指点及视频问答进行中期训练,得到 LightNav-ER 初始化。
- 拟合轨迹码本,联合指点、动作与保留的推理数据进行 SFT,并加入 DAgger 纠偏轨迹。
- 在仿真中进行多任务 GRPO,按整段轨迹的任务奖励优化策略,并约束其偏离参考模型的程度。
推理时怎样行动
- 按时间远近降低旧帧采样率并加强空间池化,在固定预算内保留历史。
- 由同一模型依次生成可通行点、目标点及三层残差动作编号。
- 查码本还原十步航点,由机器人轨迹跟踪器执行并滚动接收新观察。
端到端边界:端到端范围是 RGB 与指令到轨迹,两个指点由同一模型生成;真实机器人仍依赖轨迹跟踪器、里程计及平台自带运动控制。
训练开放情况与复现限制
部分开放
截至 2026-10-09,已公开权重、RVQ 码本、推理、评测和机器人部署代码;官方模型卡将仓库定位为推理与评测,未核实完整 ER/SFT/RL 训练入口或全部训练语料。
没有独立的高频避障策略;真实跨平台展示主要是定性验证,不能替代统一测试。完整训练复现仍需补足代码和语料。
查看本篇 5 条实验记录 · SR / SPL
完整输入条件、其他指标与版本说明见实验对照表;不同协议不可直接排序比较。
数据口径与使用说明
- 初次资料核验于 2026-10-06;2026-10-09 增补 TrackVLA、LightNav、VLingNav,其余条目沿用此前核验。日期按首次公开的论文或官方报告记录;会议年份另列,避免把后续录用年份当成模型首次提出时间。
- 来源优先使用论文、官方项目与官方仓库。未核实的冻结范围、代码或指标保留明确标记;网页上的路线与架构分类属于阅读归纳。
- 同一论文的多个版本、不同 checkpoint、S1/S2 子系统和额外数据变体可能有不同成绩。本页尽量固定到具体版本和表格,并保留必要的协议说明。
- “自训练”通常是用现成 VLM 权重做 SFT、模仿学习或 RL,而不是从零预训练大模型。动作级样本、图像、完整轨迹、场景数是不同计数单位。
- 训练代码状态为内容核验,没有实际启动模型训练或重跑实验;模型许可、完整数据可获得性和算力需求仍应以各仓库实际要求为准。